


QAI-h1290FX
Ein GPU-bereiter Edge KI Speicher Server mit Unterstützung für NVIDIA® GPUs, U.2 NVMe SSD und 25GbE-Konnektivität – entwickelt für lokale KI-, Virtualisierung- und rechenintensive Workloads.
QAI-h1290FX ist ein Desktop-Edge-Compute- und Speicher-Konvergenzserver, der eine Hochleistungs-Computing-Architektur mit ultraschnellem Speicher kombiniert. Er unterstützt konfigurierbare NVIDIA® RTX™ PRO Blackwell GPUs und ist damit ideal für lokale KI, LLM-Inferenz, private RAG-Suche, Virtualisierung und andere anspruchsvolle Rechenlasten.
Angetrieben von QuTS hero mit dem ZFS-Dateisystem bietet die Plattform unternehmensgerechte Daten-Integrität und konstante Performance. Ob für KI-Implementierung, Forschung und Entwicklung, High-Performance-Computing oder Enterprise-Virtualisierung-Umgebungen – QAI-h1290FX ermöglicht flexible Konfiguration und schnelle Bereitstellung, sodass kritische Workloads am Edge sicher und effizient ausgeführt werden.


GPU-bereite Architektur mit RTX PRO Blackwell Unterstützung
Mit einem GPU-bereiten Design gebaut, unterstützt NVIDIA® RTX™ PRO Blackwell GPUs, einschließlich Optionen wie die RTX PRO 6000 Blackwell Max-Q Workstation, um den Anforderungen von KI-Workloads, Bildgenerierung, Inferenz und GPU-beschleunigtem Computing gerecht zu werden.
High-Speed All-Flash NVMe Speicher Architektur
Ausgestattet mit 12 U.2 NVMe SSD-Bays und Unterstützung für SATA SSD, ermöglicht flexible Speicher-Konfigurationen, die auf Leistung, Kapazität oder Kosten optimiert sind. Ideal für KI-Workloads, Virtualisierung und Echtzeit-Daten-Verarbeitung.
On-Premise LLM & RAG Suche
Ermöglicht die lokale Bereitstellung privater LLMs und RAG-basierter Suche und bietet eine sichere semantische Dokumentenrecherche, ohne sensible Daten in die Cloud zu senden.
ZFS-basiertes QuTS hero Betriebssystem
Angetrieben von QuTS hero mit ZFS und bietet Inline-Komprimierung, Selbstheilung, Snapshots und SnapSync für unternehmensgerechte Daten-Integrität.
GPU-Beschleunigung & KI-App-Vorlagen
Nutzen Sie GPU-Beschleunigung über Container Station. Mit nur einem Klick Ollama, AnythingLLM, Stable Diffusion usw. bereitstellen. Vereinfacht die Einführung von KI-Anwendungen.
25GbE-Konnektivität & Erweiterungsbereitschaft
Integrierte Dual 25GbE- und 2,5GbE-Ports, aufrüstbar auf 100GbE. Skalieren Sie mit QNAP JBODs, um den wachsenden Anforderungen an KI-Daten-Speicher gerecht zu werden.


QuTS hero Betriebssystem
Ausgezeichnet mit dem 2026 MSP Today Product of the Year Award

QNAP QAI-h1290FX
TechRadar Pro Picks Awards Gewinner auf der CES 2026
QAI Ideale Anwendungen
-
Interner Chatbot & Wissensdatenbank
Setzen Sie private ChatGPT-ähnliche Bots mit AnythingLLM oder OpenWebUI ein. Stellen Sie eine sichere Verbindung zu internen Dokumenten für Mitarbeiterfragen, Richtliniensuche und Schulungsunterstützung her – ganz ohne Internetzugang.

-
Private RAG-Suchmaschine
Führen Sie Retrieval-Augmented Generation (RAG) lokal mit voller Kontrolle über Daten aus. Ermöglichen Sie die natürliche Sprachsuche in Dokumenten wie Verträgen, Berichten und Archiven – ideal für Rechts-, Finanz- und Unternehmensabteilungen.

-
KI-Inferenz & Inhaltserstellung
Nutzen Sie Stable Diffusion oder ComfyUI zur Bildgenerierung oder setzen Sie eigene Modelle für Video-Tagging, Dokumentenzusammenfassungen und medizinische Analysen ein. Profitieren Sie von GPU-Beschleunigung und All-Flash-Speicher.

Edge-KI und Hochleistungsrechnen in Unternehmensqualität
QAI-h1290FX ist mehr als ein Speicher-System – es ist eine rechenbereite Edge-Computing-Plattform in Unternehmensqualität. Basierend auf einer Hochleistungs-Computing-Architektur unterstützt sie konfigurierbare NVIDIA® RTX™ Pro Blackwell GPUs und eignet sich hervorragend für Large Language Model (LLM) Inferenz, Bildgenerierung, RAG-Suche und eine Vielzahl rechenintensiver und virtualisierter Workloads.
Ob für KI-Inferenz, Forschung und Entwicklung, Daten-Analysen oder Unternehmensanwendungen mit hohen Kernzahlen und dauerhafter Leistung – eine einzelne Desktop-Enterprise-Plattform kann herausragende Recheneffizienz und Daten Sicherheit vollständig On-Premises bereitstellen.
Maximale KI-Compute-Leistung (optionale GPU-Konfiguration)

GPU-Ready-Architektur – Unterstützung für NVIDIA® RTX™ Pro Blackwell
QAI-h1290FX verfügt über eine GPU-Ready-Architektur, die für NVIDIA® RTX™ Pro Blackwell GPUs ausgelegt ist. Basierend auf der Blackwell-Architektur unterstützt sie Beschleunigungstechnologien wie CUDA, TensorRT und die Transformer Engine und eignet sich somit ideal für moderne KI- und GPU-beschleunigte Computing-Workloads.
Von Large Language Model (LLM) Inferenz und Computer Vision bis hin zu generativer KI und anderen GPU-beschleunigten professionellen Anwendungen können Workloads vollständig lokal ausgeführt und bereitgestellt werden – für starke Leistung bei Wahrung der Daten-Privatsphäre und vollständiger Systemkontrolle. Die Plattform kann auch als CPU-zentriertes Hochleistungs-Computingsystem betrieben werden und unterstützt Virtualisierung sowie eine Vielzahl von Enterprise-Computing-Szenarien.
-
 Flaggschiff
NVIDIA® RTX™ Pro 6000 Blackwell Max-Q Workstation
- 96 GB GDDR7 ECC-Speicher
- 24.064 CUDA-Kerne, 752 Tensor-Kerne, 188 RT-Kerne
- 125 TFLOPS (FP32), bis zu 4000 AI TOPS
- 1.792 GB/s Speicherbandbreite
- 300W Stromverbrauch
- PCIe 5.0 x16 Schnittstelle
-
 Leistung
NVIDIA® RTX™ Pro 4500 Blackwell
- 32 GB GDDR7 ECC Speicher
- 10.496 CUDA-Kerne, 328 Tensor-Kerne, 82 RT-Kerne
- 54,94 TFLOPS (FP32)
- 896 GB/s Speicherbandbreite
- 200W Stromverbrauch
- PCIe 5.0 x16 Schnittstelle
NVIDIA® RTX™ Pro Blackwell Serie – Die Neudefinition von KI- und High-Performance-Computing-Workflows
Die NVIDIA® RTX™ Pro Blackwell Serie GPUs sind speziell für anspruchsvolle KI-, Rechen- und Kreativanwendungen konzipiert und kombinieren die Blackwell-Architektur der nächsten Generation mit ultraschnellem GDDR7 ECC Speicher. Dies ermöglicht eine Rechenleistung und VRAM-Kapazität auf einer einzigen professionellen GPU, die zuvor mehrere Consumer-Grafikkarten erforderte.
Mit Unterstützung für bis zu 96 GB VRAM und erweiterten KI-Beschleunigungsfunktionen ist die RTX™ Pro Blackwell Serie ideal für fortschrittliche LLMs, generative Modelle, Daten-Analysen sowie komplexe 3D-Visualisierungen und professionelle Rechen-Workflows.

Angetrieben von Server-Class AMD EPYC™ Prozessoren für High-Performance-Computing
QAI-h1290FX basiert auf einer Server-Class AMD EPYC Prozessorplattform und bietet hohe Kernzahlen sowie enorme Multithread-Leistung.
Entwickelt für einen langfristigen, stabilen Betrieb unter hochparallelen Workloads, eignet sie sich optimal für Virtualisierung, Multithread-Computing, Daten-Verarbeitung und Edge-Computing-Szenarien – und unterstützt zudem KI-Inferenz sowie eine Vielzahl rechenintensiver Anwendungen.

QuTS hero Betriebssystem
Entwickelt für Unternehmen, verwendet das QuTS hero Betriebssystem das hochzuverlässige ZFS-Dateisystem, um höchste Datenintegrität und Stabilität für geschäftskritische Speicher zu gewährleisten. QuTS hero optimiert die Leistung und Lebensdauer von SSDs weiter, um den strengen Anforderungen von Unternehmen an Leistung und Zuverlässigkeit gerecht zu werden. Entdecken Sie das QuTS hero Betriebssystem Lernen Sie die neuesten Funktionen von QuTS hero kennen
Fernzugriff auf On-Prem AI – jederzeit und überall
Schaffen Sie eine nahtlose hybride Arbeitsumgebung mit mehreren Fernzugriffsoptionen von QNAP. Egal, ob Sie KI-Anwendungen verwalten oder auf Dateien zugreifen, das QAI-h1290FX sorgt dafür, dass Sie stets verbunden bleiben – ohne Kompromisse bei Sicherheit.
Direkte oder Relay-Zugriffsoptionen
- myQNAPcloud DDNS:
Greifen Sie von überall über eine eigene Domain auf Ihre QuTS hero-Oberfläche zu, ohne sich IP-Adressen merken zu müssen. - myQNAPcloud Link:
Stellt eine sichere Relay-Verbindung über QNAP-Server her – Sie müssen keine Router-Ports öffnen oder Firewall-Einstellungen ändern. - VPN-Server-Unterstützung:
Richten Sie ein privates VPN mit dem QVPN-Dienst ein und ermöglichen Sie sichere, verschlüsselte Tunnel für den vollständigen Netzwerkzugriff.
Ob Sie Ihr LLM-Container-Setup optimieren, Inferenzprotokolle prüfen oder standortübergreifend zusammenarbeiten – das QAI-h1290FX bietet zuverlässigen Zugriff auf Ihre On-Prem AI-Umgebung von jedem Gerät, jederzeit.

Ein leistungsstärkeres Container Station: Ein neues Erlebnis bei der Bereitstellung von KI-Anwendungen
Um die praktische Nutzung von KI zu fördern, integriert die QAI-Serie Container Station mit einer großen Auswahl an KI-Anwendungsvorlagen. Diese Vorlagen ermöglichen die Ein-Klick-Bereitstellung beliebter KI-Tools und Frameworks, wobei QNAP regelmäßig Updates bereitstellt, damit Sie stets Zugang zu den neuesten Technologien haben.
Egal, ob Sie neu im Bereich KI sind oder Workloads lokal ausführen möchten – QAI erleichtert Ihnen den Einstieg in KI, senkt Kosten, verbessert Daten Sicherheit und ermöglicht sogar die Entwicklung eigener KI-Tools zur Förderung von Innovationen in Ihrem Unternehmen.

Containerisierte KI-Bereitstellung leicht gemacht
Verbessern Sie Ihre KI-Infrastruktur durch nahtlose Container-Integration. Entdecken Sie Container Station
KI-zentrierte Container-Umgebung
Das QAI-h1290FX wird mit Container Station geliefert und ermöglicht die Bereitstellung von Docker- und LXD-Containern. Da die meisten KI-Tools heute als containerisierte Anwendungen bereitgestellt werden, bietet QAI-h1290FX eine direkte und effiziente Möglichkeit, Modelle wie LLM, RAG Search, Bildgenerierung (z. B. Stable Diffusion) oder Wissensdatenbanken wie AnythingLLM bereitzustellen – und das ganz ohne komplexe Einrichtung.

Persistente Daten Speicher für KI-Modelle
Mit Docker volume-Unterstützung ermöglicht das QAI-h1290FX Containern das Einbinden von freigegebenen Ordnern aus dem NAS, sodass persistente Speicher auch nach dem Wiederherstellen von Containern erhalten bleiben. Dies ist besonders vorteilhaft für KI-Workloads mit großen Modelldateien, Trainings-Daten oder Protokollen. Sie müssen sich keine Sorgen mehr machen, wichtige Daten bei Updates oder Versionswechseln zu verlieren.

Machen Sie GPU-Beschleunigung für alle KI-Workloads einfach und zugänglich
Der QAI-h1290FX nimmt Ihnen die Komplexität der GPU-Konfiguration in Docker-Umgebungen ab. Mit der intuitiven Oberfläche von Container Station wählen Sie beim Erstellen eines neuen Containers einfach die gewünschte NVIDIA® GPU aus dem Dropdown-Menü aus, und der Container erhält sofort Zugriff auf die GPU-Rechenleistung. Egal, ob Sie LLMs bereitstellen, Bildgenerierung durchführen oder Deep-Learning-Inferenzen ausführen – der QAI-h1290FX sorgt für einen nahtlosen und effizienten Ablauf.

Kreativität neu definiert mit KI-gestütztem visuellen Design
ComfyUI ermöglicht Künstlern, Designern und Content Creators eine leistungsstarke, modulare Oberfläche für KI-basierte Bild- und Video-Erstellung. Dank des intuitiven, node-basierten Designs und der Unterstützung fortschrittlicher Modelle wie Stable Diffusion können Nutzer visuelle Inhalte mühelos generieren, transformieren und animieren. In Kombination mit GPU-Beschleunigung und flexiblen Workflows senkt ComfyUI die Hürde für komplexes visuelles Design und eröffnet ungeahnte kreative Freiheiten.
Echte KI-Leistung – gemessen auf QAI-h1290FX
Die KI-Bereitstellungsleistung wird durch reale Benchmark-Daten validiert. In einer High-End-GPU-Testkonfiguration wurde QAI-h1290FX umfassend mit der NVIDIA® RTX™ PRO 6000 Blackwell Max-Q Workstation-GPU bewertet, um die Leistung bei On-Premises-KI-Inferenz und Unternehmensbereitstellungen zu bestätigen.
Ollama LLM Inference Benchmark (Schnelle Bereitstellung)
Dank der GPU-Beschleunigung der Blackwell-Architektur kann QAI-h1290FX eine Vielzahl großer Sprachmodelle lokal über Ollama ausführen.
Ollama ermöglicht eine schnelle Bereitstellung und eine vereinfachte Verwaltung und eignet sich ideal für Proof-of-Concept-(PoC)-Projekte, Einzelbenutzerumgebungen sowie kleine bis mittlere Anwendungsfälle wie RAG-basierte Suche, KI-Assistenten und Offline-Inferenz.
vLLM Gleichzeitiger Inferenz-Benchmark (Enterprise-Grade Durchsatz)
Um den Anforderungen von Multi-User- und Hochlast-KI-Diensten gerecht zu werden, unterstützt QAI-h1290FX auch die Bereitstellung mit der vLLM-Inferenz-Engine.
Im Vergleich zu Einzelanfragen-basierten Inferenzansätzen verbessert vLLM die GPU-Auslastung und den Gesamtdurchsatz durch Paged Attention und effiziente Planungsmechanismen erheblich. Dies macht es besonders geeignet für Enterprise-KI-Dienste, Multi-User-RAG-Systeme und API-basierte KI-Anwendungen.
Bei gleicher GPU-Konfiguration zeigt vLLM in Szenarien mit gleichzeitigen Anfragen konsistentere Latenzzeiten und eine höhere Token-pro-Sekunde-Rate, was es ideal für Produktionsumgebungen und langfristige Enterprise-KI-Bereitstellungen macht.
Getestetes Large Language Model: deepseek-ai/DeepSeek-R1-Distill-Qwen-7B (Hugging Face)
Getestetes Large Language Model: openai/gpt-oss-20b (Hugging Face)
Entfesseln Sie das KI-Potenzial mit praxisnahen Anwendungsfällen
Von Dokumentenautomatisierung über kreative Workflows bis hin zu systemweiter Automatisierung ermöglicht das QAI-h1290FX jeder Abteilung, KI sinnvoll und messbar einzusetzen – sicher gehostet auf Ihrer eigenen Infrastruktur.
Kein Cloud-Lock-in, keine komplexe Einrichtung – nur echte Ergebnisse durch lokale LLMs, sichere Container und integrierte QNAP-Funktionen.
Smart HR Assistant – Interner Policy-Chatbot
Erstellen Sie einen internen Q&A-Assistenten mit AnythingLLM + Ollama. Laden Sie HR-Dokumente wie Mitarbeiterhandbücher, Urlaubsrichtlinien und Benefits auf das QAI-h1290FX hoch. Mitarbeitende können natürliche Fragen stellen wie:
„Wie beantrage ich Familienpflegezeit?“
Das System führt eine lokale RAG-Suche durch und antwortet sofort, wodurch die HR-Arbeitslast sinkt und die Reaktionszeit verbessert wird.

Creative Team AI Studio – Bildgenerierungs-Hub
Designteams nutzen Stable Diffusion und ComfyUI, bereitgestellt auf dem QAI-h1290FX, um Werbebilder, Mockups oder stilisierte Grafiken per Prompteingabe zu generieren.
Dank GPU-Beschleunigung und persistenten NAS Speicher erhalten Designer schnelle und reproduzierbare Ergebnisse – kein Neustart von Grund auf nötig.

AI Co-Pilot für Entwickler – Dokumente, Code & Zusammenfassungen
Entwicklungsteams betreiben LLMs wie Qwen oder Llama in Ollama auf dem QAI-h1290FX, um bei Spezifikationen, Code-Reviews und technischen Übersetzungen zu unterstützen.
Laden Sie API-Dokumente oder Whitepapers hoch und chatten Sie dann mit dem Modell für Klarstellungen, Zusammenfassungen oder sogar Markdown-Formatierung – komplett offline und sicher.

n8n + NAS Automatisierung – Lösen Sie KI von überall aus
Mit n8n, das auf dem QAI-h1290FX installiert ist, können Sie Aufgaben automatisieren, die KI in Geschäftsabläufe integrieren. Zum Beispiel:

KI-Docker-Anwendungen auf QAI-h1290FX
Führen Sie leistungsstarke KI-Lösungen über Container Station und GPU-Integration aus.

Verwandeln Sie Ihr NAS in ein KI-gestütztes Wissenszentrum
Ermöglichen Sie Unternehmensanwendern, Informationen schneller als je zuvor zu suchen, zu verstehen und abzurufen – unterstützt von Qsirch und der nächsten Generation der RAG-Suche. Das QAI-h1290FX bringt Intelligenz in Ihre Dokumente und sorgt gleichzeitig für Sicherheit und lokale Speicherung.

Qsirch – Intelligente Volltextsuche
Qsirch bietet blitzschnelle Volltextsuche in all Ihren NAS-Dateien – PDFs, Office-Dokumente, E-Mails und mehr. Mit erweiterten Filtern, Indizierung und Vorschaufunktionen können Nutzer relevante Dokumente sofort in Terabytes von Daten finden. Mehr erfahren

RAG-Suche – KI-gestützte kontextbezogene Antworten
Die RAG-Suche (Retrieval-Augmented Generation) geht noch einen Schritt weiter, indem sie Qsirch mit einem lokalen Large Language Model (LLM) kombiniert. Wenn Nutzer eine Frage stellen, werden zunächst relevante Dateien über Qsirch gefunden und anschließend eine präzise, natürlichsprachliche Antwort durch die lokale KI generiert. Mehr erfahren
Auf QAI-h1290FX ist die RAG-Suche vollständig lokal:
5-Jahres-Garantie als Standard
Für das QAI-h1290FX gilt eine 5-Jahres-Garantie ohne zusätzliche Kosten – was Ihrem Unternehmen mehr Sicherheit verschafft.

Edge-AI-Speicher-Server-Vergleich:
QAI-h1290FX vs. andere KI-NAS vs. AI-Workstation
Benötigen Sie Hilfe?
Kontaktieren Sie uns jetzt, um weitere empfohlene Produkte oder Lösungen zu erhalten, die auf Ihre Bedürfnisse und Anforderungen zugeschnitten sind!
Optionales Zubehör
-

QM2-2P-244A
Dual M.2 22110/2280 PCIe SSD expansion card;
Dimension (L × W × H): 170.5 × 20.6 × 68.9 (mm)
Weight: 0.29 (kg)
Please check the M.2 SSD compatibility list and QM2 Installation Guide
-

QM2-2P-344A
Dual M.2 PCIe SSD expansion card; M.2 2280/22110 PCIe NVMe(Gen 3x4) SSDs; PCIe Gen3x4 host interface
Dimension (L × W × H): 170.5 × 19.3 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P-384A
Dual M.2 PCIe SSD expansion card; M.2 2280/22110 PCIe NVMe(Gen 3x4) SSDs; PCIe Gen3x8 host interface
Dimension (L × W × H): 170.5 × 19.3 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P10G1TB
QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen3 x 8 , 1 x Marvell AQC113C 10GbE NBASE-T port
Dimension (L × W × H): 152.65 × 18.9 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P2G2T
QNAP QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen3 x 4 , 2 x Intel I225LM 2.5GbE NBASE-T port
Dimension (L × W × H): 152.65 × 20.6 × 68.9 (mm)
Weight: 0.29 (kg)
-

QM2-2P410G1T (EOL)
QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen4 x 4 , 1 x AQC113C 10GbE NBASE-T port
Dimension (L × W × H): 187 × 19.35 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P410G2T (EOL)
QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen4 x 4 , 2 x AQC113C 10GbE NBASE-T port
Dimension (L × W × H): 187 × 19.35 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2S-220A
Dual M.2 22110/2280 SATA SSD expansion card;
Dimension (L × W × H): 147.15 × 20.6 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-4P-384
Quad M.2 PCIe SSD expansion card; supports up to four M.2 2280 formfactor M.2 PCIe (Gen3 x4) SSDs; PCIe Gen3 x8 host interface; Low-profile bracket pre-loaded, Low-profile flat and Full-height are bundled
Dimension (L × W × H): 204.95 × 68.9 × 20.6 (mm)
Weight: 0.32 (kg)
-

QM2-4S-240 (EOL)
Quad M.2 2280 SATA SSD expansion card
Dimension (L × W × H): 204.95 × 68.9 × 20.6 (mm)
Weight: 0.32 (kg)
-
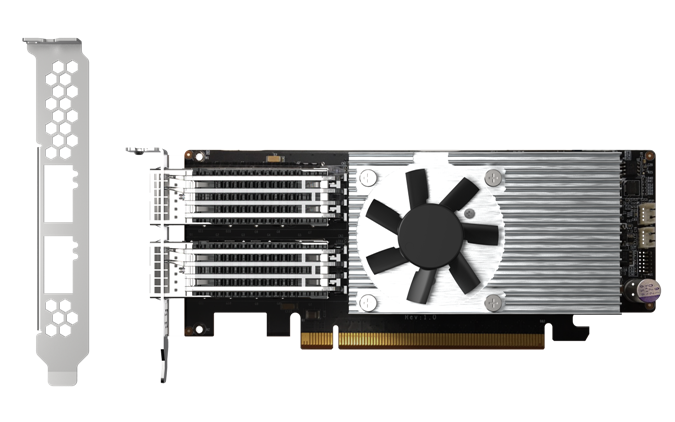
QXG-100G2SF-E810
Dual port 100GbE Network adapter; 2 x QSFP28; Intel E810 Ethernet controller
Dimension (L × W × H): 169.6 × 69 × 18.7 (mm)
Weight: 0.36 (kg)
-

QXG-10G1T
Single-port (10Gbase-T) 10GbE network expansion card, PCIe Gen3 x4, Low-profile bracket pre-loaded, Low-profile flat and Full-height are bundled
Dimension (L × W × H): 143 × 193 × 52 (mm)
Weight: 0.53 (kg)
-

QXG-10G2SF-X710
Dual-port SFP+ 10Gb network expansion card; low-profile formfactor; PCIe Gen3 x8
Dimension (L × W × H): 26 × 10.5 × 6 (mm)
Weight: 0.29 (kg)
-

QXG-10G2T
Dual-port 10GBASE-T 10Gb network expansion card; low-profile formfactor; PCIe Gen3 x4
Dimension (L × W × H): 54.5 × 39.5 × 18 (mm)
Weight: 0.24 (kg)
-

QXG-10G2T-X710
Dual-port 10GbE Network Adaptor, Intel 700 series Ethernet Controller
Dimension (L × W × H): 113.6 × 68.9 × 18.3 (mm)
Weight: 0.24 (kg)
-

QXG-10G2TB (EOL)
Dual-port 10GbE Network Adaptor, Aquantia AQC113C
Dimension (L × W × H): 104.7 × 16.1 × 68.9 (mm)
Weight: 0.28 (kg)
-

QXG-25G2SF-CX6
Dual-port SFP28 25Gb network expansion card; Mellanox ConnectX-6 Lx;low-profile formfactor; PCIe Gen4 x8
Dimension (L × W × H): 120 × 16.5 × 69 (mm)
Weight: 0.15 (kg)
-
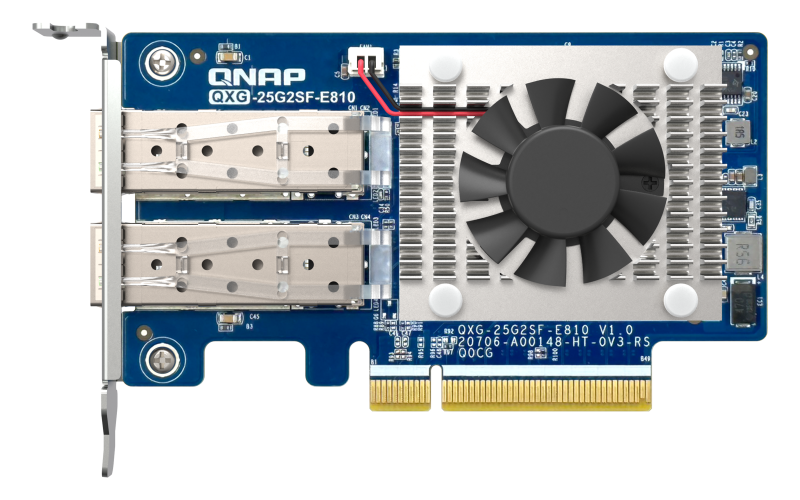
QXG-25G2SF-E810
2 port 25GbE(Intel E810-XXVAM2) Network Interface Cards (NIC)
Dimension (L × W × H): 119.3 × 68.9 × 18.1 (mm)
Weight: 0.23 (kg)
-

QXG-2G1T-I225
Single port 2.5GbE 4-speed Network card
Dimension (L × W × H): 67.3 × 68.9 × 25.2 (mm)
Weight: 0.19 (kg)
-

QXG-2G2T-I225
Dual port 2.5GbE 4-speed Network card
Dimension (L × W × H): 81.3 × 68.9 × 25.2 (mm)
Weight: 0.23 (kg)
-

QXG-2G4T-I225
Quad port 2.5GbE 4-speed Network card
Dimension (L × W × H): 104.6 × 68.9 × 24.1 (mm)
Weight: 0.24 (kg)
-

QXG-5G1T-111C
QNAP 5GbE multi-Gig expansion card;Aquantia AQC111C;Gen2 x 1;low profile
Dimension (L × W × H): 145 × 190 × 52 (mm)
Weight: 0.20 (kg)
-

QXG-5G2T-111C (EOL)
QNAP dual port 5GbE multi-Gig expansion card;Aquantia AQC111C;Gen2 x 2;low profile
Dimension (L × W × H): 145 × 190 × 52 (mm)
Weight: 0.20 (kg)
-
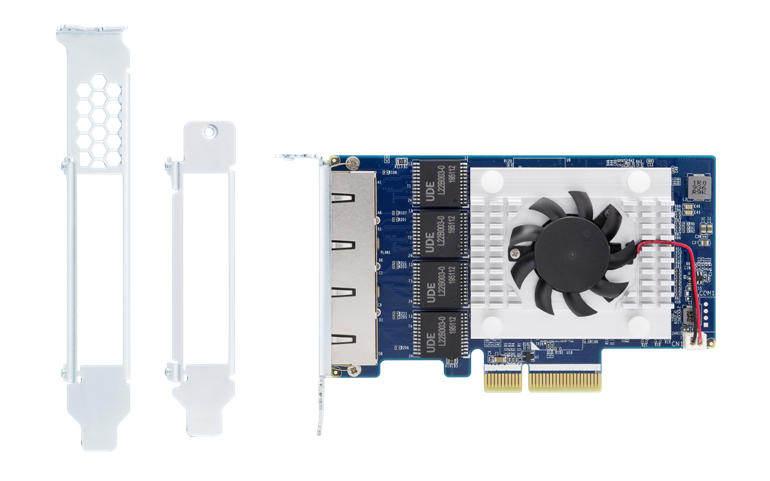
QXG-5G4T-111C (EOL)
QNAP Quad port 5GbE multi-Gig expansion card;Aquantia AQC111C;Gen2 x 4;low profile
Dimension (L × W × H): 145 × 190 × 52 (mm)
Weight: 0.23 (kg)
-

QXP-16G2FC
QNAP 2-port 16Gbps fiber channel adapter, PCIe 3.0 x8, SFP+, low profile, w/ SFP+ 16G transceivers
Dimension (L × W × H): 190 × 143 × 50 (mm)
Weight: 0.28 (kg)
-

QXP-32G2FC
QNAP 2-port 32Gbps fiber channel adapter, PCIe 3.0 x8, SFP+, low profile, w/ SFP+ 32G optical transceivers
Dimension (L × W × H): 190 × 143 × 50 (mm)
Weight: 0.28 (kg)
-
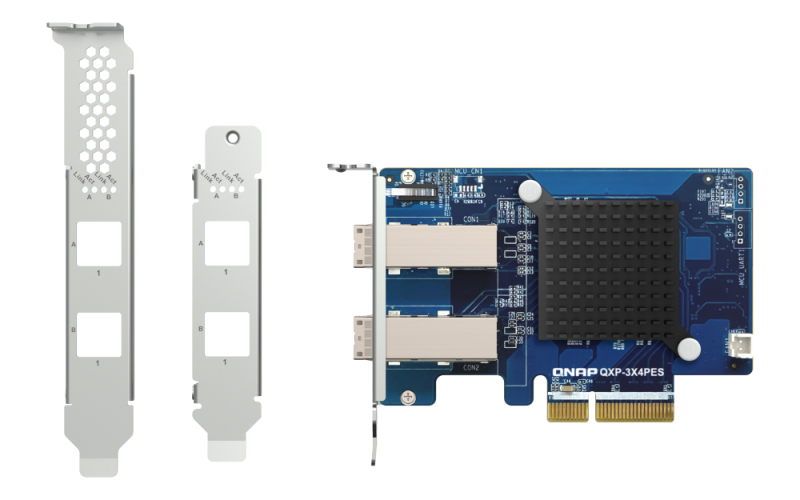
QXP-3X4PES
2 ports (SFF-8644) Expansion card; PCIe Gen3 x4 for QNAP PCIe JBOD series
Dimension (L × W × H): 102.65 × 68.9 × 19 (mm)
Weight: 0.11 (kg)
-
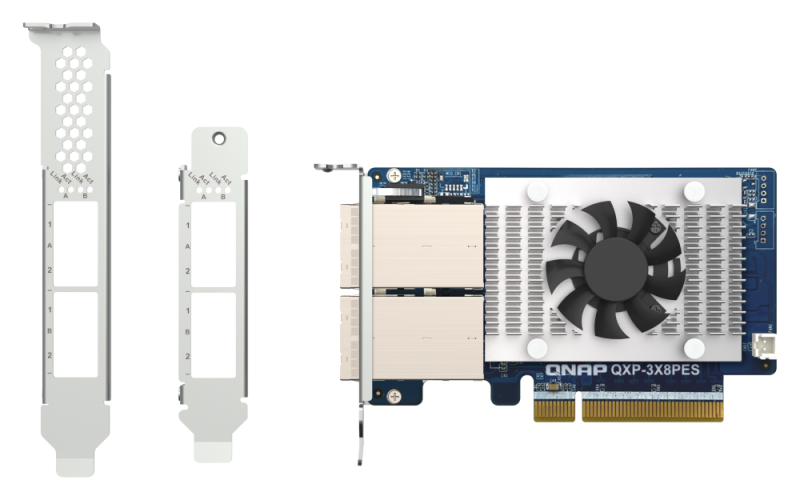
QXP-3X8PES
2 ports (SFF-8644 1x2) Expansion card; PCIe Gen3 x8 for QNAP PCIe JBOD series
Dimension (L × W × H): 112.65 × 68.9 × 18.26 (mm)
Weight: 0.17 (kg)
-
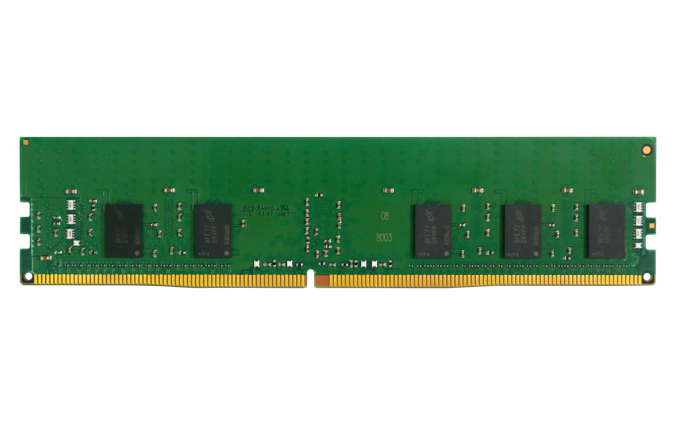
RAM-16GDR4ECT0-RD-3200
DDR type: DDR4(288PIN)
Capacity: 16GB
Spec: 1G X 8
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 2048M*72
Temperature: 0℃~85℃
Environmental Regulation: Halogen Free
-
RAM-32GDR4ECT0-RD-3200 (EOL)
DDR type: DDR4(288PIN)
Capacity: 32GB
Spec: 2G X 8
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 4G*72
Temperature: 0℃~85℃
Environmental Regulation: Halogen Free
-

RAM-32GDR4K0-RD-3200
32GB DDR4 RAM, 3200 MHz, RDIMM
-
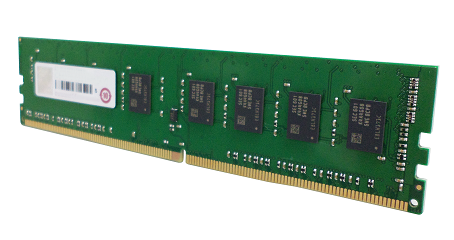
RAM-64GDR4ECK0-RD-3200 (EOL)
DDR type: DDR4(288PIN)
Capacity: 64GB
Spec: 4G X 4
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 8G*72
Temperature: 0℃~85℃
Environmental Regulation: RoHS
-
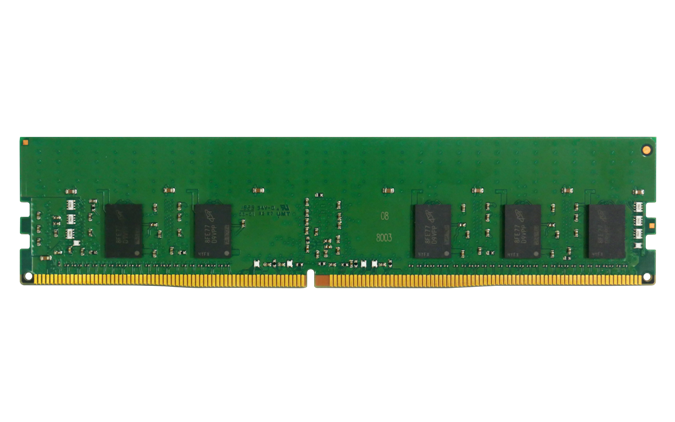
RAM-8GDR4ECT0-RD-3200
DDR type: DDR4(288PIN)
Capacity: 8GB
Spec: 1G X 8
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 1024M*72
Temperature: 0℃~85℃
Environmental Regulation: Halogen Free
-

CAB-PWR20M-C1314
Power Cord, 2M, C13-C14, 250V, 10A, IEC
Dimension (L × W × H): 180 × 29 × 21 (mm)
Weight: 0.19 (kg)


