


QAI-h1290FX
En edge AI-lagringsserver klar til GPU, der understøtter NVIDIA® GPU'er, U.2 NVMe SSD'er og 25GbE-forbindelse – designet til lokal AI, virtualisering og compute-intensive arbejdsbelastninger.
QAI-h1290FX er en edge compute- og lagringskonvergensserver i desktop-klassen, der kombinerer højtydende computerarkitektur med ultrahurtig lagring. Den understøtter konfigurerbare NVIDIA® RTX™ PRO Blackwell GPU'er, hvilket gør den ideel til lokal AI, LLM-inferens, privat RAG-søgning, virtualisering og andre krævende compute-arbejdsbelastninger.
Drevet af QuTS hero med ZFS-filsystemet leverer platformen dataintegritet på enterpriseniveau og ensartet ydeevne. Uanset om det er til AI-implementering, forskning og udvikling, high-performance computing eller enterprise-virtualiseringsmiljøer, muliggør QAI-h1290FX fleksibel konfiguration og hurtig implementering, så kritiske arbejdsbelastninger kører sikkert og effektivt på kanten.


GPU-klar arkitektur med RTX PRO Blackwell-understøttelse
Bygget med et GPU-klar design, der understøtter NVIDIA® RTX™ PRO Blackwell GPU'er, herunder muligheder som RTX PRO 6000 Blackwell Max-Q Workstation, for at imødekomme kravene til AI-arbejdsbelastninger, billedgenerering, inferens og GPU-accelereret computing.
Højhastigheds all-flash NVMe-lagringsarkitektur
Udstyret med 12 U.2 NVMe SSD-pladser og understøttelse af SATA SSD'er, hvilket muliggør fleksible lagringskonfigurationer optimeret til ydeevne, kapacitet eller pris. Ideel til AI-arbejdsbelastninger, virtualisering og realtidsdatabehandling.
Lokal LLM- og RAG-søgning
Muliggør lokal implementering af private LLM'er og RAG-baseret søgning, hvilket giver sikker semantisk dokumenthentning uden at sende følsomme data til skyen.
ZFS-baseret QuTS hero OS
Drevet af QuTS hero med ZFS, der tilbyder inline-komprimering, selvhelbredelse, snapshots og SnapSync for dataintegritet på enterpriseniveau.
GPU-acceleration og AI-appskabeloner
Udnyt GPU-acceleration via Container Station. Én-klik implementering af Ollama, AnythingLLM, Stable Diffusion m.fl. Gør udrulning af AI-applikationer enkel.
25GbE-forbindelse og klar til udvidelse
Indbyggede dual 25GbE- og 2.5GbE-porte samt mulighed for opgradering til 100GbE. Skaler op med QNAP JBOD'er for at imødekomme voksende AI-datalagringsbehov.


QuTS hero operativsystem
Hædret med 2026 MSP Today Product of the Year Award

QNAP QAI-h1290FX
TechRadar Pro Picks Awards-vinder for CES 2026
QAI Ideelle anvendelser
-
Intern chatbot & videnbase
Implementer private ChatGPT-lignende bots med AnythingLLM eller OpenWebUI. Forbind sikkert til interne dokumenter for medarbejder Q&A, politik-søgning og træningssupport—ingen internetforbindelse krævet.

-
Privat RAG-søgemaskine
Kør Retrieval-Augmented Generation (RAG) lokalt med fuld kontrol over data. Muliggør søgning i dokumenter med naturligt sprog på tværs af kontrakter, rapporter og arkiver—ideelt for juridiske, finansielle og virksomhedsteams.

-
AI-inferens & indholdsgenerering
Brug Stable Diffusion eller ComfyUI til billedgenerering, eller implementer tilpassede modeller til videotagging, dokumentsummering og medicinsk analyse. Drag fordel af GPU-acceleration og all-flash-lagring.

Edge AI og high-performance computing i enterprise-klassen
QAI-h1290FX er mere end et lagringssystem — det er en enterprise-grade edge computing-platform, der er klar til beregning. Bygget på en high-performance computing-arkitektur understøtter den konfigurerbare NVIDIA® RTX™ Pro Blackwell GPU'er, hvilket gør den velegnet til LLM-inferens (Large Language Model), billedgenerering, RAG-søgning og en bred vifte af beregningstunge og virtualiserede arbejdsbelastninger.
Uanset om det er til AI-inferens, forskning og udvikling, dataanalyse eller enterprise-applikationer, der kræver højt antal kerner og vedvarende ydeevne, kan en enkelt desktop-klasse enterprise-platform levere fremragende beregningseffektivitet og datasikkerhed helt lokalt.
Maksimal AI-beregningsydelse (valgfri GPU-konfiguration)

GPU-klar arkitektur — Understøtter NVIDIA® RTX™ Pro Blackwell
QAI-h1290FX har en GPU-klar arkitektur, der er designet til at understøtte NVIDIA® RTX™ Pro Blackwell GPU'er. Bygget på Blackwell-arkitekturen understøtter den accelerationsteknologier som CUDA, TensorRT og Transformer Engine, hvilket gør den velegnet til moderne AI- og GPU-accelererede computerarbejdsbelastninger.
Fra Large Language Model (LLM) inferens og computer vision til generativ AI og andre GPU-accelererede professionelle applikationer kan arbejdsbelastninger implementeres og udføres fuldt ud lokalt—hvilket giver høj ydeevne, samtidig med at dataprivatliv og fuld systemkontrol opretholdes. Platformen kan også fungere som et CPU-centreret high-performance computing-system, der understøtter virtualisering og en bred vifte af virksomhedsscenarier.
-
 Flagskib
NVIDIA® RTX™ Pro 6000 Blackwell Max-Q Workstation
- 96 GB GDDR7 ECC-hukommelse
- 24.064 CUDA-kerner, 752 Tensor-kerner, 188 RT-kerner
- 125 TFLOPS (FP32), op til 4000 AI TOPS
- 1.792 GB/s hukommelsesbåndbredde
- 300 W strømforbrug
- PCIe 5.0 x16 interface
-
 Ydeevne
NVIDIA® RTX™ Pro 4500 Blackwell
- 32 GB GDDR7 ECC-hukommelse
- 10.496 CUDA-kerner, 328 Tensor-kerner, 82 RT-kerner
- 54,94 TFLOPS (FP32)
- 896 GB/s hukommelsesbåndbredde
- 200W strømforbrug
- PCIe 5.0 x16 interface
NVIDIA® RTX™ Pro Blackwell-serien — Redefinerer AI og højtydende computerarbejdsgange
NVIDIA® RTX™ Pro Blackwell-seriens GPU'er er specialudviklet til højintensive AI-, compute- og kreative arbejdsbelastninger og kombinerer den næste generations Blackwell-arkitektur med ultrahurtig GDDR7 ECC-hukommelse. Dette leverer et niveau af compute-ydeevne og VRAM-kapacitet på et enkelt professionelt grafikkort, som tidligere krævede flere grafikkort i forbrugerkvalitet.
Med understøttelse af op til 96 GB VRAM og forbedrede AI-accelerationsmuligheder er RTX™ Pro Blackwell-serien ideel til avancerede LLM'er, generative modeller, dataanalyse samt komplekse 3D-visualiseringer og professionelle compute-arbejdsgange.

Drevet af serverklasse AMD EPYC™-processorer til højtydende computing
QAI-h1290FX er bygget på en serverklasse AMD EPYC-processorplatform, der leverer højt antal kerner og massiv multitrådet ydeevne.
Designet til langvarig, stabil drift under meget parallelle arbejdsbelastninger, hvilket gør den velegnet til virtualisering, multitrådet computing, databehandling og edge computing-scenarier—samtidig med at den understøtter AI-inferens og en bred vifte af compute-intensive applikationer.

QuTS hero styresystem
Operativsystemet QuTS hero er designet til virksomheder og anvender det meget pålidelige ZFS-filsystem for at give maksimal dataintegritet og stabilitet til missionskritisk lagring. QuTS hero optimerer SSD'ens ydeevne og holdbarhed yderligere for at imødekomme virksomhedernes strenge krav til ydeevne og pålidelighed. Udforsk operativsystemet QuTS hero Tjek QuTS hero's nyeste funktioner
Fjernadgang til lokal AI – når som helst, hvor som helst
Skab et problemfrit hybridarbejdsmiljø med flere fjernadgangsmuligheder fra QNAP. Uanset om du administrerer AI-applikationer eller tilgår filer, sikrer QAI-h1290FX, at du altid er forbundet – uden at gå på kompromis med sikkerheden.
Direkte eller relay-adgangsmuligheder
- myQNAPcloud DDNS:
Få adgang til din QuTS hero-grænseflade hvor som helst via et brugerdefineret domæne, uden at skulle huske IP-adresser. - myQNAPcloud Link:
Etablerer en sikker relay-forbindelse gennem QNAP-servere – ingen grund til at åbne routerporte eller ændre firewall-indstillinger. - VPN-serverunderstøttelse:
Opsæt en privat VPN med QVPN Service, som muliggør sikre krypterede tunneler for fuld netværksadgang.
Uanset om du finjusterer din LLM-containeropsætning, gennemgår inferenslogs eller samarbejder på tværs af lokationer, giver QAI-h1290FX pålidelig adgang til dit lokale AI-miljø fra enhver enhed, når som helst.

En kraftigere Container Station: En ny oplevelse inden for udrulning af AI-applikationer
For at fremme praktisk AI-anvendelse integrerer QAI-serien Container Station med et bredt udvalg af AI-applikationsskabeloner. Disse skabeloner understøtter ét-klik-udrulning af populære AI-værktøjer og frameworks, med regelmæssige opdateringer fra QNAP for at sikre adgang til de nyeste teknologier.
Uanset om du er ny inden for AI eller ønsker at flytte arbejdsbelastninger lokalt, gør QAI det nemt at udforske AI, reducere omkostninger, forbedre datasikkerheden og endda udvikle brugerdefinerede AI-værktøjer for at styrke forretningsinnovation.

Containeriseret AI-udrulning gjort enkelt
Forbedr din AI-infrastruktur med problemfri containerintegration. Udforsk Container Station
AI-centreret container-miljø
QAI-h1290FX leveres med Container Station, hvilket muliggør udrulning af Docker- og LXD-containere. Da de fleste AI-værktøjer i dag leveres som containeriserede applikationer, giver QAI-h1290FX en direkte og effektiv måde at implementere modeller som LLM, RAG Search, billedgenerering (f.eks. Stable Diffusion) eller knowledge base engines som AnythingLLM – alt sammen uden kompleks opsætning.

Vedvarende datalagring til AI-modeller
Med Docker Volume-understøttelse gør QAI-h1290FX det muligt for containere at montere delte mapper fra NAS'en, hvilket sikrer vedvarende lagring selv efter container-genopbygning. Dette er især fordelagtigt for AI-arbejdsbelastninger, der involverer store modelfiler, træningsdata eller logs. Du behøver ikke længere bekymre dig om at miste vigtige data under opdateringer eller versionsskift.

Gør GPU-acceleration enkel og tilgængelig for alle AI-arbejdsbelastninger
QAI-h1290FX fjerner kompleksiteten ved at konfigurere GPU-ressourcer i Docker-miljøer. Med Container Stations intuitive grænseflade skal du blot vælge den ønskede NVIDIA® GPU fra rullemenuen, når du opretter en ny container, og containeren får straks adgang til GPU-beregningskapaciteter. Uanset om du implementerer LLM'er, kører billedgenerering eller udfører deep learning-inferens, sikrer QAI-h1290FX, at processen er problemfri og effektiv.

Omdefinerer kreativitet med AI-drevet visuel design
ComfyUI giver kunstnere, designere og indholdsskabere en kraftfuld, modulær grænseflade til AI-drevet billede- og videoproduktion. Gennem dets intuitive nodebaserede design og understøttelse af avancerede modeller som Stable Diffusion kan brugere ubesværet generere, transformere og animere visuelt indhold. Kombineret med GPU-acceleration og fleksible workflows sænker ComfyUI barrieren for komplekst visuelt design—og låser op for hidtil uset kreativ frihed.
AI-ydeevne i den virkelige verden – målt på QAI-h1290FX
AI-implementeringsydelse valideres gennem virkelige benchmarkdata. Under en high-end GPU-testkonfiguration blev QAI-h1290FX fuldt evalueret med NVIDIA® RTX™ PRO 6000 Blackwell Max-Q Workstation GPU, hvilket bekræftede dens ydeevne i on-premises AI-inferens og virksomhedsimplementeringsscenarier.
Ollama LLM Inference Benchmark (Hurtig implementering)
Ved at udnytte GPU-accelerationsmulighederne i Blackwell-arkitekturen kan QAI-h1290FX køre et bredt udvalg af store sprogmodeller lokalt via Ollama.
Ollama muliggør hurtig implementering og forenklet administration, hvilket gør det velegnet til proof-of-concept (PoC)-projekter, enkeltbruger-miljøer og små til mellemstore brugsscenarier som RAG-baseret søgning, AI-assistenter og offline-inferens.
vLLM Concurrent Inference Benchmark (Enterprise-Grade Throughput)
For at imødekomme kravene til multi-bruger og høj samtidighed i AI-tjenester understøtter QAI-h1290FX også implementering med vLLM-inferensmotoren.
Sammenlignet med enkeltforespørgselsbaserede inferensmetoder forbedrer vLLM GPU-udnyttelsen og den samlede gennemstrømning markant via Paged Attention og effektive planlægningsmekanismer. Dette gør den særligt velegnet til virksomheds-AI-tjenester, multi-bruger RAG-systemer og API-baserede AI-applikationer.
Med samme GPU-konfiguration viser vLLM mere konsistente latensegenskaber og højere tokens-per-sekund gennemstrømning i samtidige forespørgselsscenarier, hvilket gør den ideel til produktionsmiljøer og langvarige virksomheds-AI-implementeringer.
Testet Large Language Model: deepseek-ai/DeepSeek-R1-Distill-Qwen-7B (Hugging Face)
Testet Large Language Model: openai/gpt-oss-20b (Hugging Face)
Frigør AI-potentiale med praktiske anvendelsestilfælde
Fra dokumentautomatisering til kreative arbejdsgange og systemomfattende automatisering giver QAI-h1290FX alle afdelinger mulighed for at anvende AI på meningsfulde, målbare måder—sikkert hostet på din egen infrastruktur.
Ingen cloud lock-in, ingen kompliceret opsætning—bare reelle resultater drevet af lokale LLM'er, sikre containere og integrerede QNAP-funktioner.
Smart HR-assistent – intern politik-chatbot
Byg en intern Q&A-assistent med AnythingLLM + Ollama. Upload HR-dokumenter såsom medarbejderhåndbøger, orlovspolitikker og personalegoder til QAI-h1290FX. Medarbejdere kan stille naturlige spørgsmål som:
”Hvordan ansøger jeg om familieplejeorlov?”
Systemet udfører lokal RAG-søgning og svarer øjeblikkeligt, hvilket reducerer HR-arbejdsmængden og forbedrer svartiden.

Kreativt team AI Studio – billedgenereringshub
Designteams bruger Stable Diffusion og ComfyUI, der er implementeret på QAI-h1290FX, til at generere reklamebilleder, mockups eller stiliseret grafik via prompt-input.
Takket være GPU-acceleration og vedvarende NAS-lagring får designere hurtige og reproducerbare resultater—ikke mere at starte forfra.

AI Co-Pilot til udviklere – Dokumentation, kode og resuméer
Ingeniørteams kører LLM'er som Qwen eller Llama i Ollama på QAI-h1290FX for at hjælpe med specifikationsskrivning, kodegennemgang og tekniske oversættelser.
Upload API-dokumentation eller whitepapers, og chat derefter med modellen for afklaringer, resuméer eller endda markdown-formatering—helt offline og sikkert.

n8n + NAS-automatisering – Udløs AI hvor som helst fra
Med n8n installeret på QAI-h1290FX kan du automatisere opgaver, der integrerer AI med forretningsdrift. For eksempel:

AI Docker-applikationer på QAI-h1290FX
Kør kraftfulde AI-løsninger via Container Station & GPU-integration.

Forvandl din NAS til et AI-drevet videnshub
Giv virksomhedens brugere mulighed for at søge, forstå og hente information hurtigere end nogensinde – drevet af Qsirch og næste generations RAG Search. QAI-h1290FX bringer intelligens til dine dokumenter, mens alt holdes sikkert og lokalt.

Qsirch – Smart fuldtekstsøgning
Qsirch tilbyder lynhurtig fuldtekstsøgning på alle dine NAS-filer – PDF’er, Office-dokumenter, e-mails og meget mere. Med avancerede filtre, indeksering og forhåndsvisningsfunktioner kan brugere finde relevante dokumenter øjeblikkeligt på tværs af terabytes af data. Læs mere

RAG Search – AI-drevne kontekstuelle svar
RAG (Retrieval-Augmented Generation) Search går skridtet videre ved at kombinere Qsirch med en lokal Large Language Model (LLM). Når brugere stiller et spørgsmål, henter systemet først relevante filer via Qsirch og genererer derefter et præcist, naturligt sprog-svar ved hjælp af den lokale AI. Læs mere
På QAI-h1290FX er RAG Search fuldt ud lokal:
5 års garanti som standard
QAI-h1290FX er dækket af en 5-års garanti uden ekstra omkostninger – det giver din virksomhed større ro i sindet.

Edge AI Storage Server-sammenligning:
QAI-h1290FX vs. anden AI NAS vs. AI Workstation
Har du brug for hjælp?
Kontakt os nu for at få flere anbefalede produkter eller løsninger, der passer til dine behov og krav!
Optional Accessories
-

QM2-2P-244A
Dual M.2 22110/2280 PCIe SSD expansion card;
Dimension (L × W × H): 170.5 × 20.6 × 68.9 (mm)
Weight: 0.29 (kg)
Please check the M.2 SSD compatibility list and QM2 Installation Guide
-

QM2-2P-344A
Dual M.2 PCIe SSD expansion card; M.2 2280/22110 PCIe NVMe(Gen 3x4) SSDs; PCIe Gen3x4 host interface
Dimension (L × W × H): 170.5 × 19.3 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P-384A
Dual M.2 PCIe SSD expansion card; M.2 2280/22110 PCIe NVMe(Gen 3x4) SSDs; PCIe Gen3x8 host interface
Dimension (L × W × H): 170.5 × 19.3 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P10G1TB
QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen3 x 8 , 1 x Marvell AQC113C 10GbE NBASE-T port
Dimension (L × W × H): 152.65 × 18.9 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P2G2T
QNAP QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen3 x 4 , 2 x Intel I225LM 2.5GbE NBASE-T port
Dimension (L × W × H): 152.65 × 20.6 × 68.9 (mm)
Weight: 0.29 (kg)
-

QM2-2P410G1T (EOL)
QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen4 x 4 , 1 x AQC113C 10GbE NBASE-T port
Dimension (L × W × H): 187 × 19.35 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P410G2T (EOL)
QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen4 x 4 , 2 x AQC113C 10GbE NBASE-T port
Dimension (L × W × H): 187 × 19.35 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2S-220A
Dual M.2 22110/2280 SATA SSD expansion card;
Dimension (L × W × H): 147.15 × 20.6 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-4P-384
Quad M.2 PCIe SSD expansion card; supports up to four M.2 2280 formfactor M.2 PCIe (Gen3 x4) SSDs; PCIe Gen3 x8 host interface; Low-profile bracket pre-loaded, Low-profile flat and Full-height are bundled
Dimension (L × W × H): 204.95 × 68.9 × 20.6 (mm)
Weight: 0.32 (kg)
-

QM2-4S-240 (EOL)
Quad M.2 2280 SATA SSD expansion card
Dimension (L × W × H): 204.95 × 68.9 × 20.6 (mm)
Weight: 0.32 (kg)
-
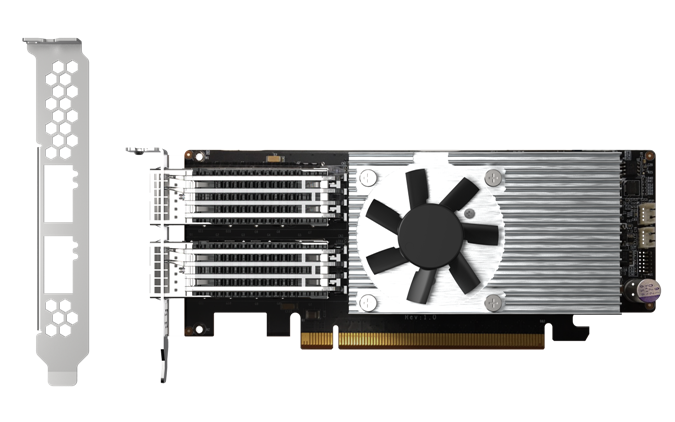
QXG-100G2SF-E810
Dual port 100GbE Network adapter; 2 x QSFP28; Intel E810 Ethernet controller
Dimension (L × W × H): 169.6 × 69 × 18.7 (mm)
Weight: 0.36 (kg)
-

QXG-10G1T
Single-port (10Gbase-T) 10GbE network expansion card, PCIe Gen3 x4, Low-profile bracket pre-loaded, Low-profile flat and Full-height are bundled
Dimension (L × W × H): 143 × 193 × 52 (mm)
Weight: 0.53 (kg)
-

QXG-10G2SF-X710
Dual-port SFP+ 10Gb network expansion card; low-profile formfactor; PCIe Gen3 x8
Dimension (L × W × H): 26 × 10.5 × 6 (mm)
Weight: 0.29 (kg)
-

QXG-10G2T
Dual-port 10GBASE-T 10Gb network expansion card; low-profile formfactor; PCIe Gen3 x4
Dimension (L × W × H): 54.5 × 39.5 × 18 (mm)
Weight: 0.24 (kg)
-

QXG-10G2T-X710
Dual-port 10GbE Network Adaptor, Intel 700 series Ethernet Controller
Dimension (L × W × H): 113.6 × 68.9 × 18.3 (mm)
Weight: 0.24 (kg)
-

QXG-10G2TB (EOL)
Dual-port 10GbE Network Adaptor, Aquantia AQC113C
Dimension (L × W × H): 104.7 × 16.1 × 68.9 (mm)
Weight: 0.28 (kg)
-

QXG-25G2SF-CX6
Dual-port SFP28 25Gb network expansion card; Mellanox ConnectX-6 Lx;low-profile formfactor; PCIe Gen4 x8
Dimension (L × W × H): 120 × 16.5 × 69 (mm)
Weight: 0.15 (kg)
-
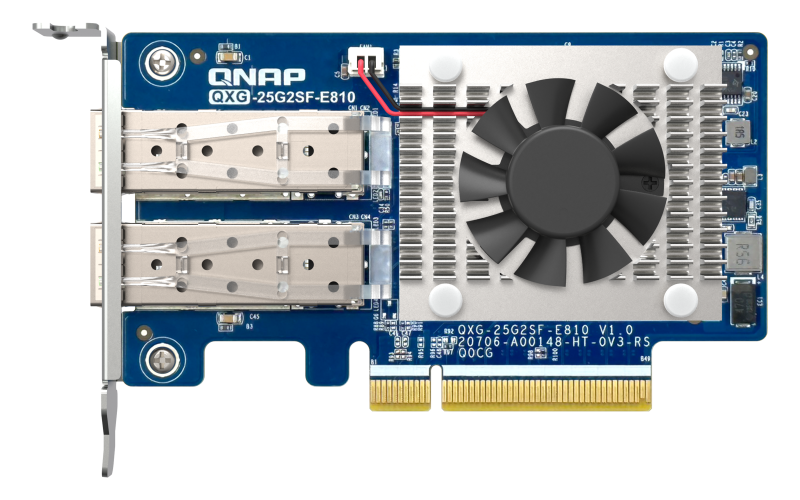
QXG-25G2SF-E810
2 port 25GbE(Intel E810-XXVAM2) Network Interface Cards (NIC)
Dimension (L × W × H): 119.3 × 68.9 × 18.1 (mm)
Weight: 0.23 (kg)
-

QXG-2G1T-I225
Single port 2.5GbE 4-speed Network card
Dimension (L × W × H): 67.3 × 68.9 × 25.2 (mm)
Weight: 0.19 (kg)
-

QXG-2G2T-I225
Dual port 2.5GbE 4-speed Network card
Dimension (L × W × H): 81.3 × 68.9 × 25.2 (mm)
Weight: 0.23 (kg)
-

QXG-2G4T-I225
Quad port 2.5GbE 4-speed Network card
Dimension (L × W × H): 104.6 × 68.9 × 24.1 (mm)
Weight: 0.24 (kg)
-

QXG-5G1T-111C
QNAP 5GbE multi-Gig expansion card;Aquantia AQC111C;Gen2 x 1;low profile
Dimension (L × W × H): 145 × 190 × 52 (mm)
Weight: 0.20 (kg)
-

QXG-5G2T-111C (EOL)
QNAP dual port 5GbE multi-Gig expansion card;Aquantia AQC111C;Gen2 x 2;low profile
Dimension (L × W × H): 145 × 190 × 52 (mm)
Weight: 0.20 (kg)
-
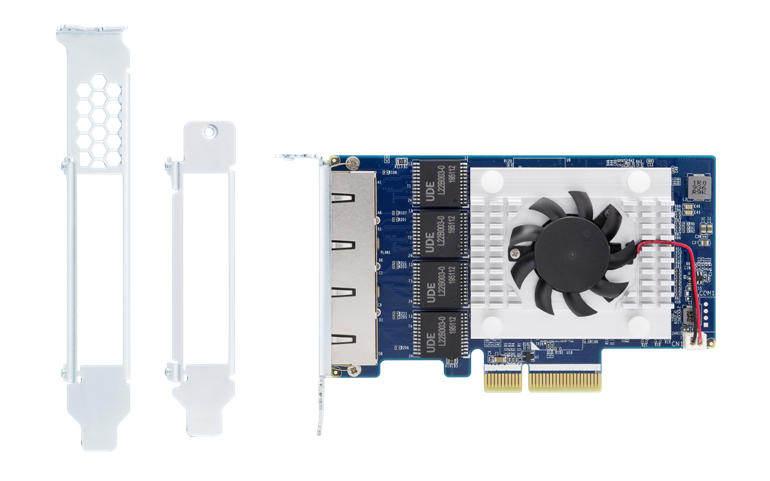
QXG-5G4T-111C (EOL)
QNAP Quad port 5GbE multi-Gig expansion card;Aquantia AQC111C;Gen2 x 4;low profile
Dimension (L × W × H): 145 × 190 × 52 (mm)
Weight: 0.23 (kg)
-

QXP-16G2FC
QNAP 2-port 16Gbps fiber channel adapter, PCIe 3.0 x8, SFP+, low profile, w/ SFP+ 16G transceivers
Dimension (L × W × H): 190 × 143 × 50 (mm)
Weight: 0.28 (kg)
-

QXP-32G2FC
QNAP 2-port 32Gbps fiber channel adapter, PCIe 3.0 x8, SFP+, low profile, w/ SFP+ 32G optical transceivers
Dimension (L × W × H): 190 × 143 × 50 (mm)
Weight: 0.28 (kg)
-
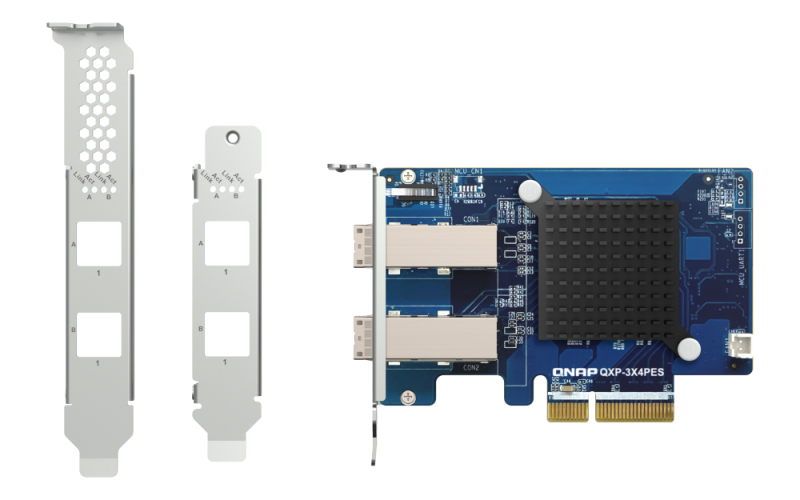
QXP-3X4PES
2 ports (SFF-8644) Expansion card; PCIe Gen3 x4 for QNAP PCIe JBOD series
Dimension (L × W × H): 102.65 × 68.9 × 19 (mm)
Weight: 0.11 (kg)
-
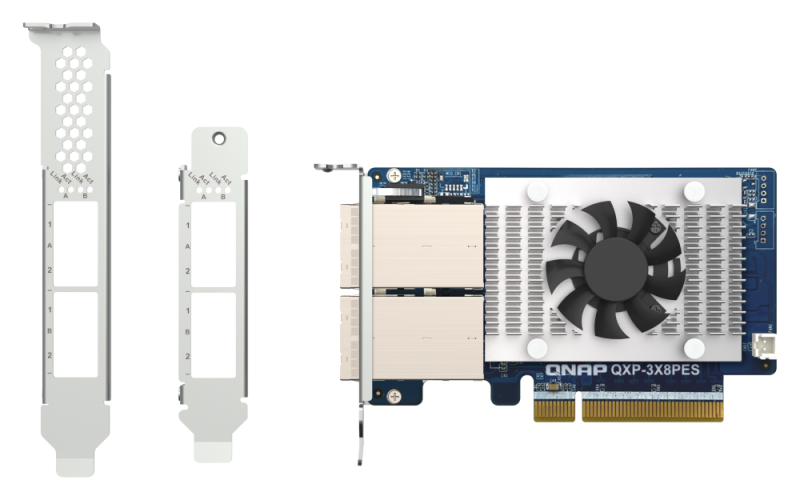
QXP-3X8PES
2 ports (SFF-8644 1x2) Expansion card; PCIe Gen3 x8 for QNAP PCIe JBOD series
Dimension (L × W × H): 112.65 × 68.9 × 18.26 (mm)
Weight: 0.17 (kg)
-
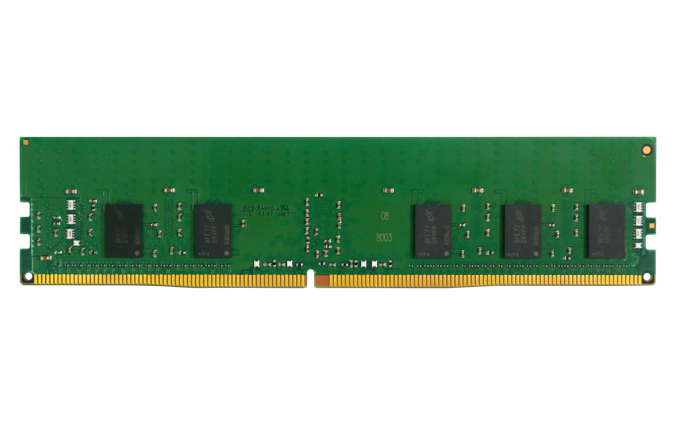
RAM-16GDR4ECT0-RD-3200
DDR type: DDR4(288PIN)
Capacity: 16GB
Spec: 1G X 8
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 2048M*72
Temperature: 0℃~85℃
Environmental Regulation: Halogen Free
-
RAM-32GDR4ECT0-RD-3200 (EOL)
DDR type: DDR4(288PIN)
Capacity: 32GB
Spec: 2G X 8
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 4G*72
Temperature: 0℃~85℃
Environmental Regulation: Halogen Free
-

RAM-32GDR4K0-RD-3200
32GB DDR4 RAM, 3200 MHz, RDIMM
-
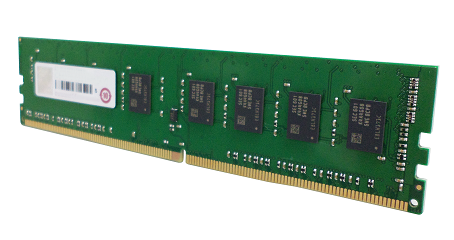
RAM-64GDR4ECK0-RD-3200 (EOL)
DDR type: DDR4(288PIN)
Capacity: 64GB
Spec: 4G X 4
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 8G*72
Temperature: 0℃~85℃
Environmental Regulation: RoHS
-
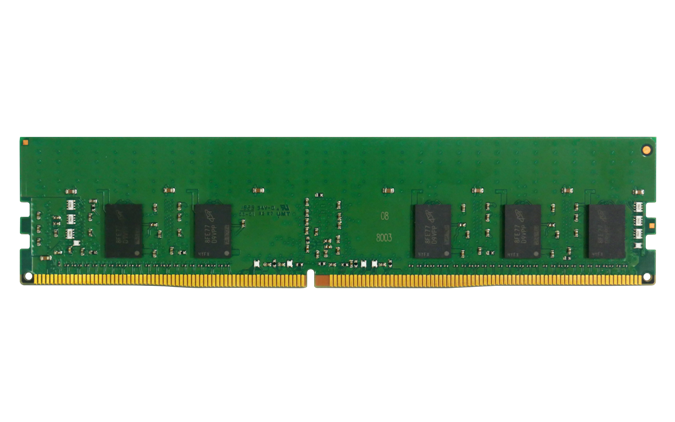
RAM-8GDR4ECT0-RD-3200
DDR type: DDR4(288PIN)
Capacity: 8GB
Spec: 1G X 8
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 1024M*72
Temperature: 0℃~85℃
Environmental Regulation: Halogen Free
-

CAB-PWR20M-C1314
Power Cord, 2M, C13-C14, 250V, 10A, IEC
Dimension (L × W × H): 180 × 29 × 21 (mm)
Weight: 0.19 (kg)


