


QAI-h1290FX
En GPU-redo edge AI Lagring-server som stöder NVIDIA® GPU:er, U.2 NVMe SSD och 25GbE-anslutning—designad för lokal AI, Virtualisering och beräkningsintensiva arbetsbelastningar.
QAI-h1290FX är en edge compute- och Lagring-konvergensserver i desktopklass som kombinerar högpresterande datorkraft med ultrasnabb Lagring. Den stöder konfigurerbara NVIDIA® RTX™ PRO Blackwell GPU:er, vilket gör den idealisk för lokal AI, LLM-inferens, privat RAG-sökning, Virtualisering och andra krävande beräkningsarbetsbelastningar.
Drivs av QuTS hero med ZFS-filsystemet och levererar dataintegritet i företagsklass och konsekvent prestanda. Oavsett om det gäller AI-distribution, forskning och utveckling, högpresterande databehandling eller företagsmiljöer för Virtualisering, möjliggör QAI-h1290FX flexibel konfiguration och snabb implementering, vilket säkerställer att kritiska arbetsbelastningar körs säkert och effektivt vid edge.


GPU-redo arkitektur med stöd för RTX PRO Blackwell
Byggd med en GPU-redo design som stöder NVIDIA® RTX™ PRO Blackwell GPU:er, inklusive alternativ som RTX PRO 6000 Blackwell Max-Q Workstation, för att möta kraven från AI-arbetsbelastningar, bildgenerering, inferens och GPU-accelererad databehandling.
Höghastighets all flash NVMe Lagring-arkitektur
Utrustad med 12 U.2 NVMe SSD-fack och stöd för SATA SSD, vilket möjliggör flexibla Lagring-konfigurationer optimerade för prestanda, kapacitet eller kostnad. Perfekt för AI-arbetsbelastningar, Virtualisering och realtidsbearbetning av data.
Lokal LLM- och RAG-sökning
Möjliggör lokal distribution av privata LLM:er och RAG-baserad sökning, vilket ger säker semantisk dokumenthämtning utan att skicka känslig data till molnet.
ZFS-baserat QuTS hero-operativsystem
Drivs av QuTS hero med ZFS och erbjuder inline-komprimering, självhelande, snapshots och SnapSync för dataintegritet i företagsklass.
GPU-acceleration & AI-appmallar
Utnyttja GPU-acceleration via Container Station. Ett klick för att distribuera Ollama, AnythingLLM, Stable Diffusion m.fl. Förenklar utrullning av AI-applikationer.
25GbE-anslutning & expansionsredo
Inbyggda dubbla 25GbE- och 2.5GbE-portar, och kan uppgraderas till 100GbE. Skala upp med QNAP JBODs för att möta ökande AI data Lagring-behov.


QuTS hero operativsystem
Utmärkt med 2026 MSP Today Product of the Year Award

QNAP QAI-h1290FX
TechRadar Pro Picks Awards-vinnare för CES 2026
QAI Ideala användningsområden
-
Intern chatbot & kunskapsbas
Distribuera privata ChatGPT-liknande bottar med AnythingLLM eller OpenWebUI. Anslut säkert till interna dokument för medarbetarfrågor, policysökning och utbildningsstöd—ingen internetanslutning krävs.

-
Privat RAG-sökmotor
Kör Retrieval-Augmented Generation (RAG) lokalt med full kontroll över data. Möjliggör dokumentsökning med naturligt språk i avtal, rapporter och arkiv—perfekt för juridik, finans och företagsteam.

-
AI-inferens & innehållsgenerering
Använd Stable Diffusion eller ComfyUI för bildgenerering, eller distribuera egna modeller för video-taggning, dokumentsummering och medicinsk analys. Dra nytta av GPU-acceleration och all-flash Lagring.

Edge AI i företagsklass och högpresterande databehandling
QAI-h1290FX är mer än ett Lagring-system — det är en beräkningsklar edge computing-plattform i företagsklass. Byggd på en högpresterande databehandlingsarkitektur, stöder den konfigurerbara NVIDIA® RTX™ Pro Blackwell-GPU:er, vilket gör den väl lämpad för LLM-inferens (Large Language Model), bildgenerering, RAG-sökning och ett brett utbud av beräkningstunga och virtualiserade arbetsbelastningar.
Oavsett om det gäller AI-inferens, forskning och utveckling, data-analys eller företagsapplikationer som kräver högt antal kärnor och uthållig prestanda, kan en enda desktop-klassad företagsplattform leverera enastående beräkningseffektivitet och data Säkerhet helt på plats.
Maximal AI-beräkningsprestanda (valfri GPU-konfiguration)

GPU-redo arkitektur — Stödjer NVIDIA® RTX™ Pro Blackwell
QAI-h1290FX har en GPU-redo arkitektur som är utformad för att stödja NVIDIA® RTX™ Pro Blackwell GPU:er. Byggd på Blackwell-arkitekturen, stöder den accelerationsteknologier som CUDA, TensorRT och Transformer Engine, vilket gör den väl lämpad för moderna AI- och GPU-accelererade beräkningsarbetsbelastningar.
Från LLM-inferens (Large Language Model) och datorseende till generativ AI och andra GPU-accelererade professionella applikationer kan arbetsbelastningar distribueras och köras helt lokalt—med hög prestanda samtidigt som data-integritet och full systemkontroll bibehålls. Plattformen kan även fungera som ett CPU-centrerat högpresterande beräkningssystem, med stöd för Virtualisering och ett brett utbud av företagsberäkningsscenarier.
-
 Flaggskepp
NVIDIA® RTX™ Pro 6000 Blackwell Max-Q-arbetsstation
- 96 GB GDDR7 ECC-minne
- 24 064 CUDA-kärnor, 752 Tensor-kärnor, 188 RT-kärnor
- 125 TFLOPS (FP32), upp till 4000 AI TOPS
- 1 792 GB/s minnesbandbredd
- 300 W effektförbrukning
- PCIe 5.0 x16-gränssnitt
-
 Prestanda
NVIDIA® RTX™ Pro 4500 Blackwell
- 32 GB GDDR7 ECC-minne
- 10 496 CUDA-kärnor, 328 Tensor-kärnor, 82 RT-kärnor
- 54,94 TFLOPS (FP32)
- 896 GB/s minnesbandbredd
- 200 W effektförbrukning
- PCIe 5.0 x16-gränssnitt
NVIDIA® RTX™ Pro Blackwell-serien – omdefinierar AI- och högpresterande datorkraft-arbetsflöden
NVIDIA® RTX™ Pro Blackwell-seriens GPU:er är specialbyggda för intensiva AI-, beräknings- och kreativa arbetsbelastningar och kombinerar nästa generations Blackwell-arkitektur med ultrasnabbt GDDR7 ECC-minne. Detta ger en beräkningsprestanda och VRAM-kapacitet på ett enda professionellt GPU-kort som tidigare krävde flera konsumentgrafikkort.
Med stöd för upp till 96 GB VRAM och förbättrade AI-accelerationsmöjligheter är RTX™ Pro Blackwell-serien idealisk för avancerade LLM:er, generativa modeller, data-analys och komplex 3D-visualisering samt professionella beräkningsarbetsflöden.

Drivs av serverklassade AMD EPYC™-processorer för högpresterande beräkningar
QAI-h1290FX är byggd på en serverklassad AMD EPYC-processorplattform och levererar högt antal kärnor och massiv multitrådad prestanda.
Designad för långvarig, stabil drift under mycket parallella arbetsbelastningar och passar utmärkt för Virtualisering, multitrådad datorkraft, data-bearbetning och edge computing-scenarier – samtidigt som den stöder AI-inferens och ett brett utbud av beräkningsintensiva applikationer.

Operativsystemet QuTS hero
Operativsystemet QTS hero är utformat för större företag och använder det mycket pålitliga filsystemet ZFS med yttersta dataintegritet och stabilitet för verksamhetskritisk lagring. QuTS hero optimerar dessutom SSD-prestanda och tålighet för att uppfylla strikta företagskrav på prestanda och tillförlitlighet. Utforska operativsystemet QuTS heroTitta på de senaste funktionerna i QuTS hero
Fjärråtkomst till lokal AI – när som helst, var som helst
Skapa en sömlös hybrid arbetsmiljö med flera fjärråtkomstalternativ från QNAP. Oavsett om du hanterar AI-applikationer eller kommer åt filer ser QAI-h1290FX till att du alltid är uppkopplad – utan att kompromissa med Säkerhet.
Direkta eller reläåtkomstalternativ
- myQNAPcloud DDNS:
Få åtkomst till ditt QuTS hero-gränssnitt var som helst via en egen domän, utan att behöva komma ihåg IP-adresser. - myQNAPcloud Link:
Upprättar en säker reläanslutning via QNAP-servrar – ingen öppning av Router-portar eller ändring av brandväggsinställningar krävs. - Stöd för VPN-server:
Ställ in ett privat VPN med hjälp av QVPN Service, vilket möjliggör säkra krypterade tunnlar för fullständig nätverksåtkomst.
Oavsett om du finjusterar din LLM-containerinstallation, granskar inferensloggar eller samarbetar över olika platser, erbjuder QAI-h1290FX tillförlitlig åtkomst till din lokala AI-miljö från valfri enhet, när som helst.

En kraftfullare Container Station: En ny upplevelse för AI-applikationsdistribution
För att främja praktisk AI-användning integrerar QAI-serien Container Station med ett brett urval av AI-applikationsmallar. Dessa mallar stöder ettklicksdistribution av populära AI-verktyg och ramverk, med regelbundna uppdateringar från QNAP för att säkerställa tillgång till den senaste tekniken.
Oavsett om du är ny inom AI eller vill flytta arbetsbelastningar lokalt gör QAI det enkelt att utforska AI, minska kostnader, förbättra data Säkerhet och till och med utveckla egna AI-verktyg för att öka affärsinnovation.

Förenklad containerbaserad AI-distribution
Förbättra din AI-infrastruktur med smidig containerintegration. Utforska Container Station
AI-centrerad containermiljö
QAI-h1290FX levereras med Container Station och möjliggör distribution av Docker- och LXD-containrar. Eftersom de flesta AI-verktyg idag levereras som containerapplikationer erbjuder QAI-h1290FX ett direkt och effektivt sätt att distribuera modeller som LLM, RAG Search, bildgenerering (t.ex. Stable Diffusion) eller kunskapsbasmotorer som AnythingLLM – allt utan komplicerad installation.

Beständig data Lagring för AI-modeller
Med stöd för Docker volym kan QAI-h1290FX låta containrar montera delade mappar från NAS, vilket säkerställer beständig Lagring även efter att containern byggts om. Detta är särskilt fördelaktigt för AI-arbetsbelastningar som involverar stora modellfiler, tränings-data eller loggar. Du behöver inte längre oroa dig för att förlora viktig data vid uppdateringar eller versionsbyten.

Gör GPU-acceleration enkelt och tillgängligt för alla AI-arbetsbelastningar
QAI-h1290FX tar bort komplexiteten i att konfigurera GPU-resurser i Docker-miljöer. Med Container Stations intuitiva gränssnitt väljer du enkelt önskad NVIDIA® GPU från rullgardinsmenyn när du skapar en ny behållare, och behållaren får omedelbart tillgång till GPU-beräkningskapacitet. Oavsett om du distribuerar LLM:er, kör bildgenerering eller utför djupinlärningsinferens, säkerställer QAI-h1290FX att processen är smidig och effektiv.

Omdefiniera kreativitet med AI-driven visuell design
ComfyUI ger konstnärer, designers och innehållsskapare ett kraftfullt, modulärt gränssnitt för AI-driven bild- och video-skapande. Med sin intuitiva nodbaserade design och stöd för avancerade modeller som Stable Diffusion kan användare enkelt generera, transformera och animera visuellt innehåll. I kombination med GPU-acceleration och flexibla arbetsflöden sänker ComfyUI tröskeln för komplex visuell design—och låser upp enastående kreativ frihet.
AI-prestanda i verkliga världen – uppmätt på QAI-h1290FX
AI-distributionsprestanda valideras genom verkliga benchmark data. Under en avancerad GPU-testkonfiguration utvärderades QAI-h1290FX fullt ut med NVIDIA® RTX™ PRO 6000 Blackwell Max-Q Workstation GPU, vilket verifierar dess prestanda för AI-inferens på plats och företagsdistributioner.
Ollama LLM Inference Benchmark (snabb distribution)
Genom att utnyttja GPU-accelerationen i Blackwell-arkitekturen kan QAI-h1290FX köra ett brett utbud av stora språkmodeller lokalt via Ollama.
Ollama möjliggör snabb distribution och förenklad hantering, vilket gör det väl lämpat för proof-of-concept (PoC)-projekt, enanvändarmiljöer och små till medelstora användningsområden såsom RAG-baserad sökning, AI-assistenter och offline-inferens.
vLLM Concurrent Inference Benchmark (Enterprise-Grade Throughput)
För att möta AI-tjänstebehov med flera användare och hög samtidighet stöder även QAI-h1290FX distribution med vLLM-inferensmotorn.
Jämfört med inferensmetoder som är inriktade på enskilda förfrågningar förbättrar vLLM GPU-användningen och den totala genomströmningen avsevärt genom Paged Attention och effektiva schemaläggningsmekanismer. Detta gör den särskilt lämplig för AI-tjänster för företag, multi-användar RAG-system och API-baserade AI-applikationer.
Med samma GPU-konfiguration uppvisar vLLM mer konsekventa latensegenskaper och högre tokens per sekund-genomströmning vid samtidiga förfrågningar, vilket gör den idealisk för produktionsmiljöer och långvariga AI-distributioner för företag.
Testad Large Language Model: deepseek-ai/DeepSeek-R1-Distill-Qwen-7B (Hugging Face)
Testad Large Language Model: openai/gpt-oss-20b (Hugging Face)
Lås upp AI:s potential med praktiska användningsfall
Från dokumentautomation till kreativa arbetsflöden och systemövergripande automation ger QAI-h1290FX varje avdelning möjlighet att använda AI på meningsfulla och mätbara sätt—säkert hostat på din egen infrastruktur.
Ingen inlåsning i molnet, ingen komplicerad installation—bara verkliga resultat med lokala LLM:er, säkra containrar och integrerade QNAP-funktioner.
Smart HR-assistent – intern policy-chatbot
Bygg en intern Q&A-assistent med AnythingLLM + Ollama. Ladda upp HR-dokument som personalhandböcker, ledighetspolicys och förmåner till QAI-h1290FX. Anställda kan ställa naturliga frågor som:
”Hur ansöker jag om familjeledighet?”
Systemet gör en lokal RAG-sökning och svarar direkt, vilket minskar HR:s arbetsbelastning och förbättrar svarstiden.

Kreativt team AI-studio – bildgenereringsnav
Designteam använder Stable Diffusion och ComfyUI distribuerat på QAI-h1290FX för att generera reklambilder, mockups eller stiliserad grafik via promptinmatning.
Tack vare GPU-acceleration och beständig NAS Lagring får designers snabba och reproducerbara resultat—ingen mer omstart från början.

AI Co-Pilot för utvecklare – dokument, kod & sammanfattningar
Ingenjörsteam kör LLM:er som Qwen eller Llama i Ollama på QAI-h1290FX för att hjälpa till med specifikationsskrivning, kodgranskning och tekniska översättningar.
Ladda upp API-dokument eller whitepapers och chatta sedan med modellen för förtydliganden, sammanfattningar eller till och med markdown-formatering—helt offline och säkert.

n8n + NAS-automation – trigga AI varifrån som helst
Med n8n installerat på QAI-h1290FX kan du automatisera uppgifter som integrerar AI med affärsverksamheten. Till exempel:

AI Docker-applikationer på QAI-h1290FX
Kör kraftfulla AI-lösningar via Container Station & GPU-integration.

Förvandla din NAS till en AI-driven kunskapshubb
Ge företagsanvändare möjlighet att söka, förstå och hämta information snabbare än någonsin – med kraft från Qsirch och nästa generations RAG-sökning. QAI-h1290FX tillför intelligens till dina dokument samtidigt som allt hålls säkert och lokalt.

Qsirch – Smart fulltextsökning
Qsirch erbjuder blixtsnabb fulltextsökning i alla dina NAS-filer – PDF:er, Office-dokument, e-post och mer. Med avancerade filter, indexering och förhandsgranskning kan användare hitta relevanta dokument direkt bland terabyte av data. Läs mer

RAG-sökning – AI-drivna kontextuella svar
RAG (Retrieval-Augmented Generation) Search tar det ett steg längre genom att kombinera Qsirch med en lokal Large Language Model (LLM). När användare ställer en fråga hämtar systemet först relevanta filer via Qsirch och genererar sedan ett korrekt, naturligt språkbaserat svar med hjälp av den lokala AI:n. Läs mer
På QAI-h1290FX är RAG-sökning helt lokal:
Fem års garanti som standard
QAI-h1290FX har fem års kostnadsfri garanti som ger företaget mer sinnesro.

Edge AI Lagring Server-jämförelse:
QAI-h1290FX vs. andra AI-NAS vs. AI-arbetsstation
Behöver du hjälp?
Kontakta oss för fler rekommenderade nätverksprodukter eller nätverkslösningar som uppfyller dina behov och krav.
Valfria tillbehör
-

QM2-2P-244A
Dual M.2 22110/2280 PCIe SSD expansion card;
Dimension (L × W × H): 170.5 × 20.6 × 68.9 (mm)
Weight: 0.29 (kg)
Please check the M.2 SSD compatibility list and QM2 Installation Guide
-

QM2-2P-344A
Dual M.2 PCIe SSD expansion card; M.2 2280/22110 PCIe NVMe(Gen 3x4) SSDs; PCIe Gen3x4 host interface
Dimension (L × W × H): 170.5 × 19.3 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P-384A
Dual M.2 PCIe SSD expansion card; M.2 2280/22110 PCIe NVMe(Gen 3x4) SSDs; PCIe Gen3x8 host interface
Dimension (L × W × H): 170.5 × 19.3 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P10G1TB
QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen3 x 8 , 1 x Marvell AQC113C 10GbE NBASE-T port
Dimension (L × W × H): 152.65 × 18.9 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P2G2T
QNAP QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen3 x 4 , 2 x Intel I225LM 2.5GbE NBASE-T port
Dimension (L × W × H): 152.65 × 20.6 × 68.9 (mm)
Weight: 0.29 (kg)
-

QM2-2P410G1T (EOL)
QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen4 x 4 , 1 x AQC113C 10GbE NBASE-T port
Dimension (L × W × H): 187 × 19.35 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P410G2T (EOL)
QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen4 x 4 , 2 x AQC113C 10GbE NBASE-T port
Dimension (L × W × H): 187 × 19.35 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2S-220A
Dual M.2 22110/2280 SATA SSD expansion card;
Dimension (L × W × H): 147.15 × 20.6 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-4P-384
Quad M.2 PCIe SSD expansion card; supports up to four M.2 2280 formfactor M.2 PCIe (Gen3 x4) SSDs; PCIe Gen3 x8 host interface; Low-profile bracket pre-loaded, Low-profile flat and Full-height are bundled
Dimension (L × W × H): 204.95 × 68.9 × 20.6 (mm)
Weight: 0.32 (kg)
-

QM2-4S-240 (EOL)
Quad M.2 2280 SATA SSD expansion card
Dimension (L × W × H): 204.95 × 68.9 × 20.6 (mm)
Weight: 0.32 (kg)
-
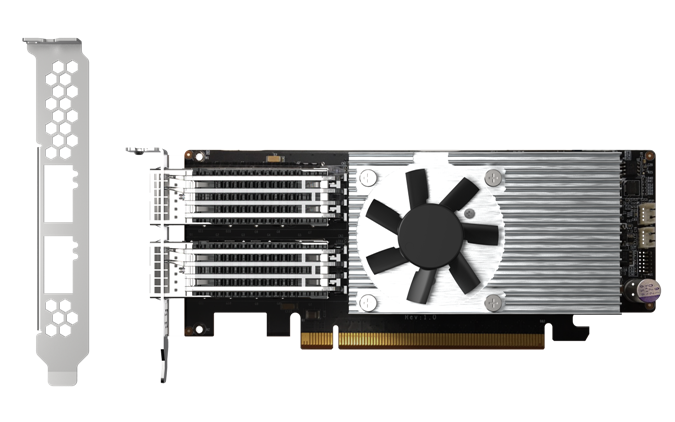
QXG-100G2SF-E810
Dual port 100GbE Network adapter; 2 x QSFP28; Intel E810 Ethernet controller
Dimension (L × W × H): 169.6 × 69 × 18.7 (mm)
Weight: 0.36 (kg)
-

QXG-10G1T
Single-port (10Gbase-T) 10GbE network expansion card, PCIe Gen3 x4, Low-profile bracket pre-loaded, Low-profile flat and Full-height are bundled
Dimension (L × W × H): 143 × 193 × 52 (mm)
Weight: 0.53 (kg)
-

QXG-10G2SF-X710
Dual-port SFP+ 10Gb network expansion card; low-profile formfactor; PCIe Gen3 x8
Dimension (L × W × H): 26 × 10.5 × 6 (mm)
Weight: 0.29 (kg)
-

QXG-10G2T
Dual-port 10GBASE-T 10Gb network expansion card; low-profile formfactor; PCIe Gen3 x4
Dimension (L × W × H): 54.5 × 39.5 × 18 (mm)
Weight: 0.24 (kg)
-

QXG-10G2T-X710
Dual-port 10GbE Network Adaptor, Intel 700 series Ethernet Controller
Dimension (L × W × H): 113.6 × 68.9 × 18.3 (mm)
Weight: 0.24 (kg)
-

QXG-10G2TB (EOL)
Dual-port 10GbE Network Adaptor, Aquantia AQC113C
Dimension (L × W × H): 104.7 × 16.1 × 68.9 (mm)
Weight: 0.28 (kg)
-

QXG-25G2SF-CX6
Dual-port SFP28 25Gb network expansion card; Mellanox ConnectX-6 Lx;low-profile formfactor; PCIe Gen4 x8
Dimension (L × W × H): 120 × 16.5 × 69 (mm)
Weight: 0.15 (kg)
-
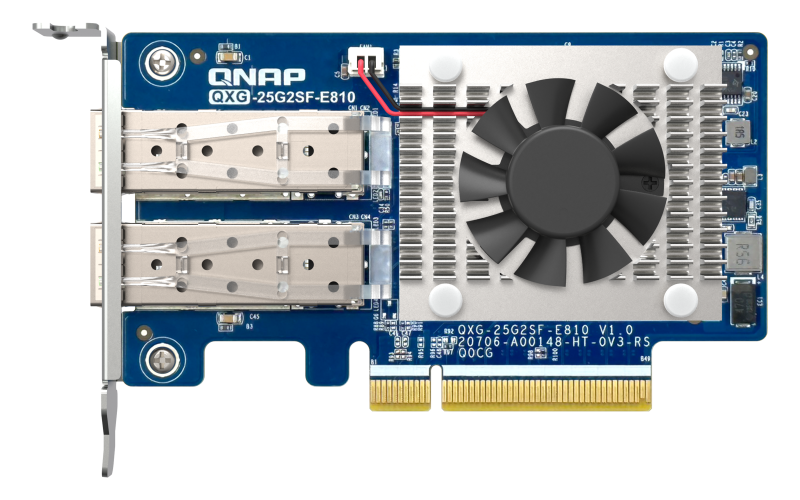
QXG-25G2SF-E810
2 port 25GbE(Intel E810-XXVAM2) Network Interface Cards (NIC)
Dimension (L × W × H): 119.3 × 68.9 × 18.1 (mm)
Weight: 0.23 (kg)
-

QXG-2G1T-I225
Single port 2.5GbE 4-speed Network card
Dimension (L × W × H): 67.3 × 68.9 × 25.2 (mm)
Weight: 0.19 (kg)
-

QXG-2G2T-I225
Dual port 2.5GbE 4-speed Network card
Dimension (L × W × H): 81.3 × 68.9 × 25.2 (mm)
Weight: 0.23 (kg)
-

QXG-2G4T-I225
Quad port 2.5GbE 4-speed Network card
Dimension (L × W × H): 104.6 × 68.9 × 24.1 (mm)
Weight: 0.24 (kg)
-

QXG-5G1T-111C
QNAP 5GbE multi-Gig expansion card;Aquantia AQC111C;Gen2 x 1;low profile
Dimension (L × W × H): 145 × 190 × 52 (mm)
Weight: 0.20 (kg)
-

QXG-5G2T-111C (EOL)
QNAP dual port 5GbE multi-Gig expansion card;Aquantia AQC111C;Gen2 x 2;low profile
Dimension (L × W × H): 145 × 190 × 52 (mm)
Weight: 0.20 (kg)
-
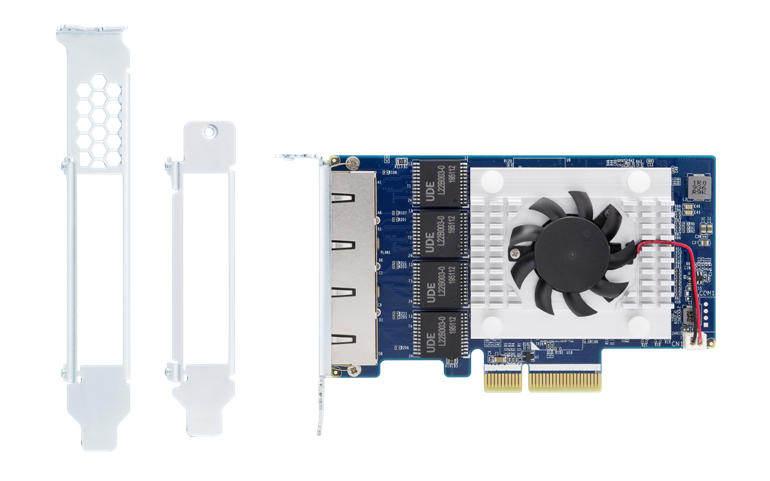
QXG-5G4T-111C (EOL)
QNAP Quad port 5GbE multi-Gig expansion card;Aquantia AQC111C;Gen2 x 4;low profile
Dimension (L × W × H): 145 × 190 × 52 (mm)
Weight: 0.23 (kg)
-

QXP-16G2FC
QNAP 2-port 16Gbps fiber channel adapter, PCIe 3.0 x8, SFP+, low profile, w/ SFP+ 16G transceivers
Dimension (L × W × H): 190 × 143 × 50 (mm)
Weight: 0.28 (kg)
-

QXP-32G2FC
QNAP 2-port 32Gbps fiber channel adapter, PCIe 3.0 x8, SFP+, low profile, w/ SFP+ 32G optical transceivers
Dimension (L × W × H): 190 × 143 × 50 (mm)
Weight: 0.28 (kg)
-
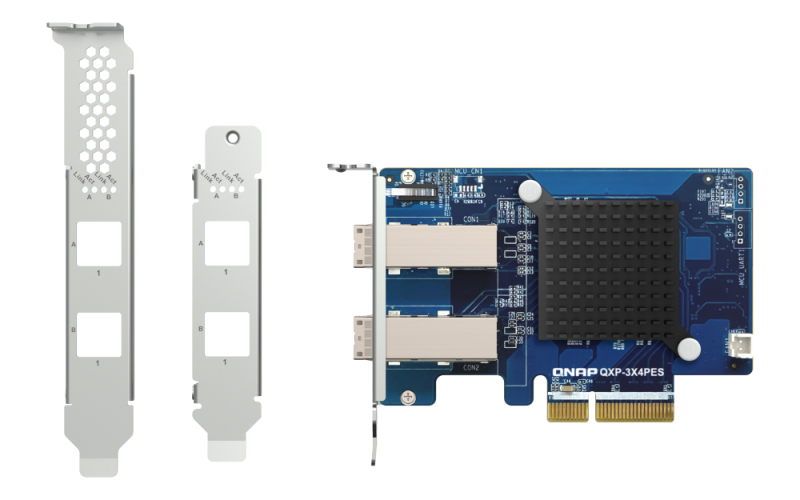
QXP-3X4PES
2 ports (SFF-8644) Expansion card; PCIe Gen3 x4 for QNAP PCIe JBOD series
Dimension (L × W × H): 102.65 × 68.9 × 19 (mm)
Weight: 0.11 (kg)
-
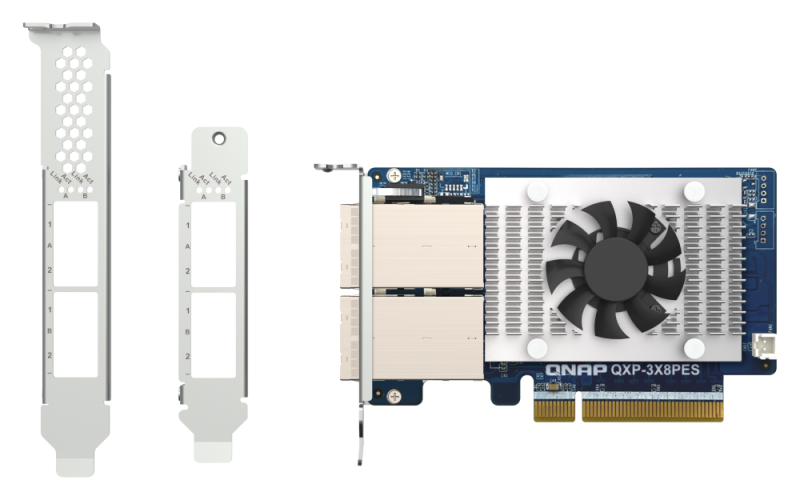
QXP-3X8PES
2 ports (SFF-8644 1x2) Expansion card; PCIe Gen3 x8 for QNAP PCIe JBOD series
Dimension (L × W × H): 112.65 × 68.9 × 18.26 (mm)
Weight: 0.17 (kg)
-
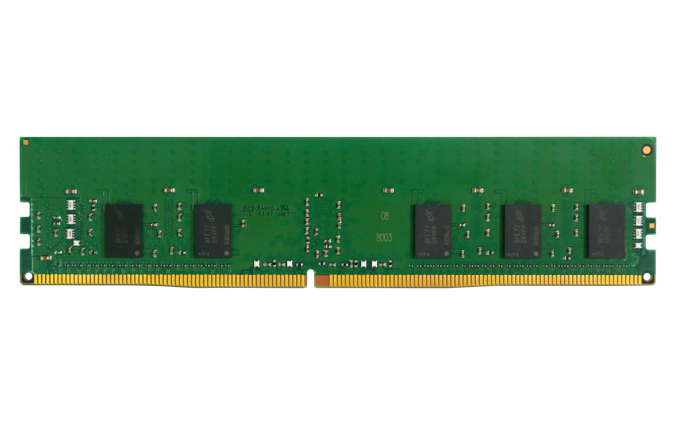
RAM-16GDR4ECT0-RD-3200
DDR type: DDR4(288PIN)
Capacity: 16GB
Spec: 1G X 8
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 2048M*72
Temperature: 0℃~85℃
Environmental Regulation: Halogen Free
-
RAM-32GDR4ECT0-RD-3200 (EOL)
DDR type: DDR4(288PIN)
Capacity: 32GB
Spec: 2G X 8
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 4G*72
Temperature: 0℃~85℃
Environmental Regulation: Halogen Free
-

RAM-32GDR4K0-RD-3200
32GB DDR4 RAM, 3200 MHz, RDIMM
-
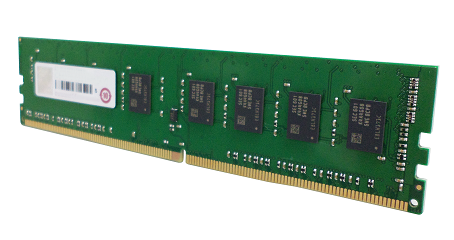
RAM-64GDR4ECK0-RD-3200 (EOL)
DDR type: DDR4(288PIN)
Capacity: 64GB
Spec: 4G X 4
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 8G*72
Temperature: 0℃~85℃
Environmental Regulation: RoHS
-
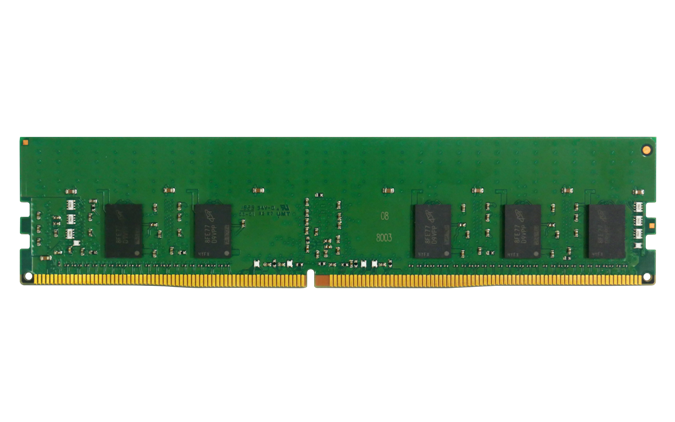
RAM-8GDR4ECT0-RD-3200
DDR type: DDR4(288PIN)
Capacity: 8GB
Spec: 1G X 8
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 1024M*72
Temperature: 0℃~85℃
Environmental Regulation: Halogen Free
-

CAB-PWR20M-C1314
Power Cord, 2M, C13-C14, 250V, 10A, IEC
Dimension (L × W × H): 180 × 29 × 21 (mm)
Weight: 0.19 (kg)


