


QAI-h1290FX
Een GPU-ready edge AI Opslag server die NVIDIA® GPU's, U.2 NVMe SSD en 25GbE-connectiviteit ondersteunt—ontworpen voor lokale AI, Virtualisatie en rekenintensieve workloads.
QAI-h1290FX is een edge compute server van desktopklasse en Opslag-convergentie die een high-performance computing architectuur combineert met ultrasnelle Opslag. Het ondersteunt configureerbare NVIDIA® RTX™ PRO Blackwell GPU's, waardoor het ideaal is voor lokale AI, LLM-inferentie, private RAG-zoekfunctie, Virtualisatie en andere veeleisende rekenworkloads.
Aangedreven door QuTS hero met het ZFS-bestandssysteem levert het platform enterprise-grade gegevens-integriteit en consistente prestaties. Of het nu gaat om AI-implementatie, onderzoek en ontwikkeling, high-performance computing of enterprise Virtualisatie omgevingen, QAI-h1290FX maakt flexibele configuratie en snelle implementatie mogelijk, zodat kritieke workloads veilig en efficiënt aan de edge draaien.


GPU-ready architectuur met RTX PRO Blackwell-ondersteuning
Gebouwd met een GPU-ready ontwerp, ondersteunt NVIDIA® RTX™ PRO Blackwell GPU's, waaronder opties zoals de RTX PRO 6000 Blackwell Max-Q Workstation, om te voldoen aan de eisen van AI-workloads, beeldgeneratie, inferentie en GPU-versnelde computing.
High-speed all-flash NVMe Opslag architectuur
Uitgerust met 12 U.2 NVMe SSD bays en ondersteuning voor SATA SSD, waardoor flexibele Opslag configuraties mogelijk zijn die geoptimaliseerd zijn voor prestaties, capaciteit of kosten. Ideaal voor AI-workloads, Virtualisatie en real-time gegevens verwerking.
On-premise LLM & RAG-zoekfunctie
Maakt lokale implementatie van private LLM's en RAG-gebaseerde zoekfunctie mogelijk, voor veilige semantische documentopvraging zonder gevoelige gegevens naar de cloud te sturen.
ZFS-gebaseerd QuTS hero OS
Aangedreven door QuTS hero met ZFS, met inline compressie, zelfherstel, snapshots en SnapSync voor enterprise-grade gegevens-integriteit.
GPU-versnelling & AI-appsjablonen
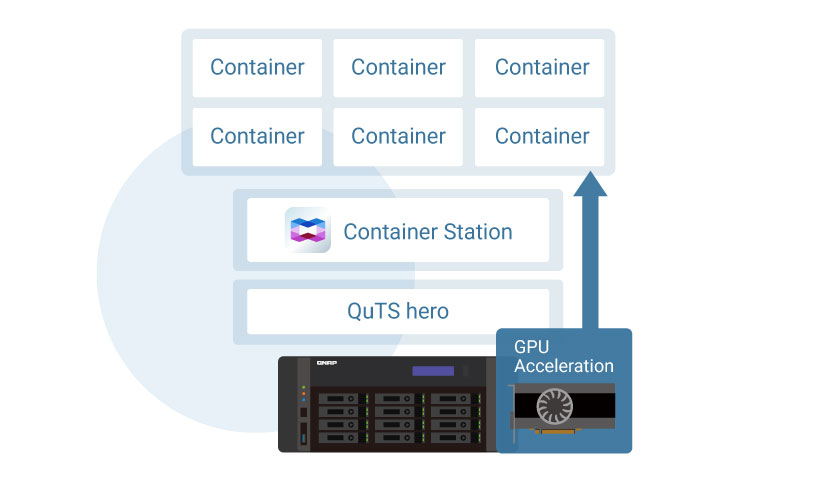
Maak gebruik van GPU-versnelling via Container Station. Met één klik Ollama, AnythingLLM, Stable Diffusion, enz. implementeren. Vereenvoudigt de uitrol van AI-toepassingen.
25GbE-connectiviteit & uitbreidingsklaar
Ingebouwde dual 25GbE- en 2.5GbE-poorten, en upgradebaar naar 100GbE. Schaal op met QNAP JBODs om te voldoen aan de groeiende AI gegevens Opslag-behoeften.


QuTS hero besturingssysteem
Bekroond met de 2026 MSP Today Product of the Year Award

QNAP QAI-h1290FX
Winnaar van de TechRadar Pro Picks Awards voor CES 2026
QAI Ideale toepassingen
-
Interne Chatbot & Knowledge Base
Implementeer privé ChatGPT-achtige bots met AnythingLLM of OpenWebUI. Verbind veilig met interne documenten voor Q&A, beleidszoekopdrachten en trainingsondersteuning voor medewerkers—geen internet vereist.

-
Privé RAG-zoekmachine
Draai Retrieval-Augmented Generation (RAG) lokaal met volledige controle over gegevens. Schakel zoeken in natuurlijke taal in documenten in, zoals contracten, rapporten en archieven—ideaal voor juridische, financiële en enterprise teams.

-
AI-inferentie & contentgeneratie
Gebruik Stable Diffusion of ComfyUI voor beeldgeneratie, of implementeer aangepaste modellen voor video-tagging, samenvattingen van documenten en medische analyse. Profiteer van GPU-versnelling en all-flash Opslag.

Enterprise-grade Edge AI en High-Performance Computing
QAI-h1290FX is meer dan een Opslag-systeem — het is een compute-ready, enterprise-grade edge computing platform. Gebouwd op een high-performance computing-architectuur, ondersteunt het configureerbare NVIDIA® RTX™ Pro Blackwell GPU's, waardoor het uitermate geschikt is voor inference van grote taalmodellen (LLM), beeldgeneratie, RAG-zoekopdrachten en een breed scala aan compute-intensieve en gevirtualiseerde workloads.
Of het nu gaat om AI-inferentie, onderzoek en ontwikkeling, gegevens-analyse of enterprise-applicaties die hoge core-aantallen en langdurige prestaties vereisen, één desktop-klasse enterprise-platform kan uitstekende compute-efficiëntie en gegevens Beveiliging volledig on-premises leveren.
Maximale AI Compute-prestaties (optionele GPU-configuratie)

GPU-Ready Architectuur — Ondersteunt NVIDIA® RTX™ Pro Blackwell
QAI-h1290FX beschikt over een GPU-ready architectuur die is ontworpen om NVIDIA® RTX™ Pro Blackwell GPU's te ondersteunen. Gebouwd op de Blackwell-architectuur, ondersteunt het versnellings-technologieën zoals CUDA, TensorRT en de Transformer Engine, waardoor het zeer geschikt is voor moderne AI- en GPU-versnelde computing-workloads.
Van inferentie van grote taalmodellen (LLM) en computervisie tot generatieve AI en andere GPU-versnelde professionele toepassingen, workloads kunnen volledig on-premises worden ingezet en uitgevoerd—met krachtige prestaties, behoud van gegevens privacy en volledige systeemcontrole. Het platform kan ook functioneren als een CPU-gecentreerd high-performance computing-systeem, met ondersteuning voor Virtualisatie en een breed scala aan zakelijke computertoepassingen.
-
 Flagship
NVIDIA® RTX™ Pro 6000 Blackwell Max-Q Workstation
- 96 GB GDDR7 ECC-geheugen
- 24.064 CUDA-cores, 752 Tensor-cores, 188 RT-cores
- 125 TFLOPS (FP32), tot 4000 AI TOPS
- 1.792 GB/s geheugenbandbreedte
- 300W stroomverbruik
- PCIe 5.0 x16-interface
-
 Prestaties
NVIDIA® RTX™ Pro 4500 Blackwell
- 32 GB GDDR7 ECC-geheugen
- 10.496 CUDA-cores, 328 Tensor-cores, 82 RT-cores
- 54,94 TFLOPS (FP32)
- 896 GB/s geheugendoorvoer
- 200W energieverbruik
- PCIe 5.0 x16-interface
NVIDIA® RTX™ Pro Blackwell-serie — Herdefinieert AI- en high-performance computing-workflows
De NVIDIA® RTX™ Pro Blackwell-serie GPU's zijn speciaal ontworpen voor intensieve AI-, reken- en creatieve workloads en combineren de next-generation Blackwell-architectuur met ultrasnel GDDR7 ECC-geheugen. Dit levert een niveau van rekenkracht en VRAM-capaciteit op één professionele GPU dat voorheen meerdere consumenten grafische kaarten vereiste.
Met ondersteuning tot 96GB VRAM en verbeterde AI-versnellingsmogelijkheden is de RTX™ Pro Blackwell-serie ideaal voor geavanceerde LLM's, generatieve modellen, gegevens analytics en complexe 3D-visualisatie en professionele rekenworkflows.

Aangedreven door server-klasse AMD EPYC™-processors voor high-performance computing
QAI-h1290FX is gebouwd op een server-klasse AMD EPYC-processorplatform en levert hoge core-aantallen en enorme multithreaded prestaties.
Ontworpen voor langdurige, stabiele werking onder sterk parallelle workloads, is het uitermate geschikt voor Virtualisatie, multithreaded computing, gegevens verwerking en edge computing-scenario's—en ondersteunt het ook AI-inferentie en een breed scala aan rekenintensieve toepassingen.

Besturingssysteem QuTS hero
Het besturingssysteem QuTS hero is ontworpen voor ondernemingen en gebruikt het uiterst betrouwbare bestandssysteem ZFS om de beste gegevensintegriteit en stabiliteit te bieden voor bedrijfskritische opslag. QuTS hero optimaliseert SSD-prestaties en duurzaamheid verder om te voldoen aan de strenge eisen van bedrijven op het gebied van prestaties en betrouwbaarheid. Ontdek het besturingssysteem QuTS heroBekijk de nieuwste functies van QuTS hero
Toegang op afstand tot on-prem AI – altijd en overal
Creëer een naadloze hybride werkomgeving met meerdere opties voor externe toegang die QNAP biedt. Of u nu AI-toepassingen beheert of bestanden opent, de QAI-h1290FX zorgt ervoor dat u altijd verbonden bent—zonder concessies te doen aan Beveiliging.
Directe of relay-toegangsopties
- myQNAPcloud DDNS:
Toegang tot uw QuTS hero-interface vanaf elke locatie via een eigen domein, zonder IP-adressen te hoeven onthouden. - myQNAPcloud Link:
Maakt een beveiligde relay-verbinding via QNAP-servers—geen noodzaak om Router-poorten te openen of firewall-instellingen aan te passen. - VPN Server-ondersteuning:
Stel een privé-VPN in met behulp van QVPN Service, waarmee veilige versleutelde tunnels voor volledige netwerktoegang mogelijk zijn.
Of u nu uw LLM-containerconfiguratie aan het fijnafstemmen bent, inferentielogs bekijkt of samenwerkt op verschillende locaties, de QAI-h1290FX biedt betrouwbare toegang tot uw on-prem AI-omgeving vanaf elk apparaat, op elk moment.

Een krachtigere Container Station: Een nieuwe ervaring in AI-applicatie-implementatie
Om praktische AI-adoptie te bevorderen, integreert de QAI-serie Container Station met een ruime selectie van AI-applicatiesjablonen. Deze sjablonen ondersteunen one-click deployment van populaire AI-tools en frameworks, met regelmatige updates van QNAP om toegang tot de nieuwste technologieën te garanderen.
Of je nu nieuw bent met AI of AI-werkbelastingen lokaal wilt draaien, QAI maakt het eenvoudig om AI te verkennen, kosten te verlagen, gegevens Beveiliging te verbeteren en zelfs aangepaste AI-tools te ontwikkelen om zakelijke innovatie te stimuleren.
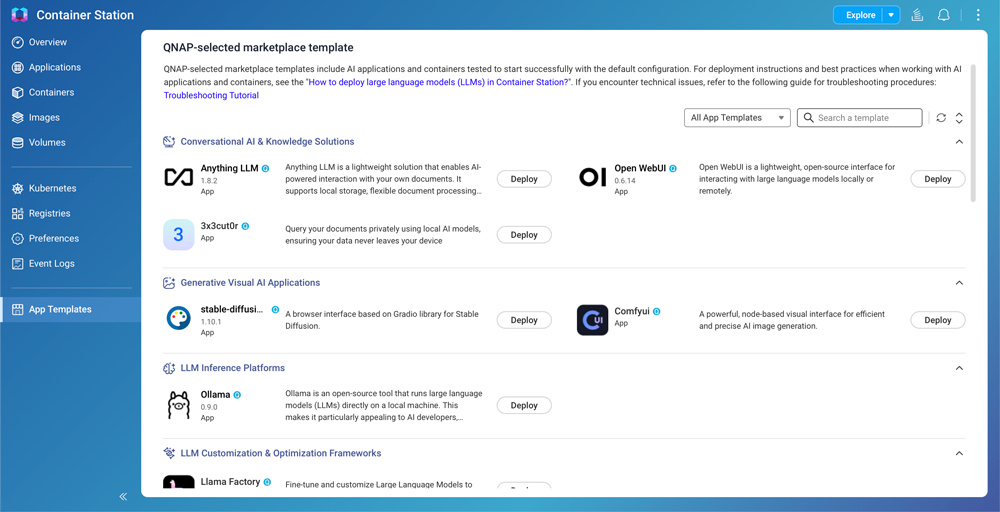
Container-gebaseerde AI-implementatie eenvoudig gemaakt
Versterk je AI-infrastructuur met naadloze containerintegratie. Ontdek Container Station
AI-gecentreerde containeromgeving
De QAI-h1290FX wordt geleverd met Container Station, waarmee de implementatie van Docker- en LXD-containers mogelijk is. Omdat de meeste AI-tools tegenwoordig als containerapplicaties worden geleverd, biedt QAI-h1290FX een directe en efficiënte manier om modellen zoals LLM, RAG Search, beeldgeneratie (bijv. Stable Diffusion) of kennisbank-engines zoals AnythingLLM te implementeren—alles zonder complexe installatie.
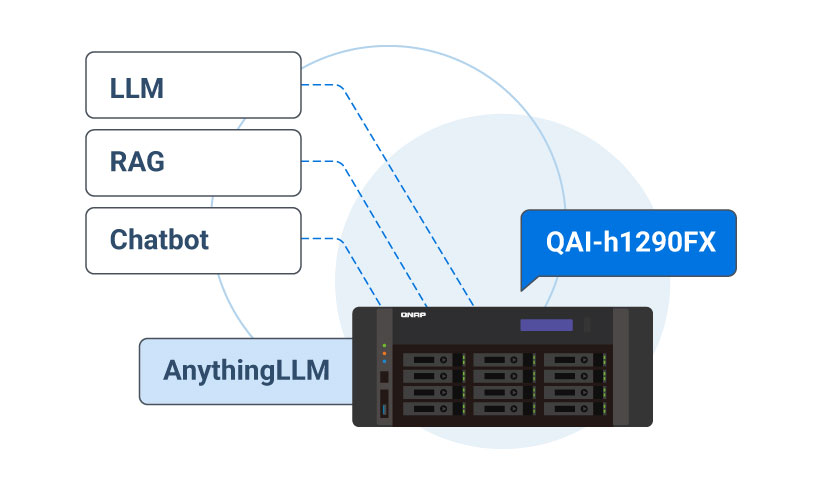
Persistente gegevens Opslag voor AI-modellen
Met ondersteuning voor Docker olume kan de QAI-h1290FX containers gedeelde mappen van de NAS laten koppelen, waardoor persistente Opslag behouden blijft, zelfs na het opnieuw bouwen van containers. Dit is vooral voordelig voor AI-werkbelastingen met grote modelbestanden, trainings-gegevens of logbestanden. Geen zorgen meer over het verliezen van belangrijke gegevens bij updates of het wisselen van versies.
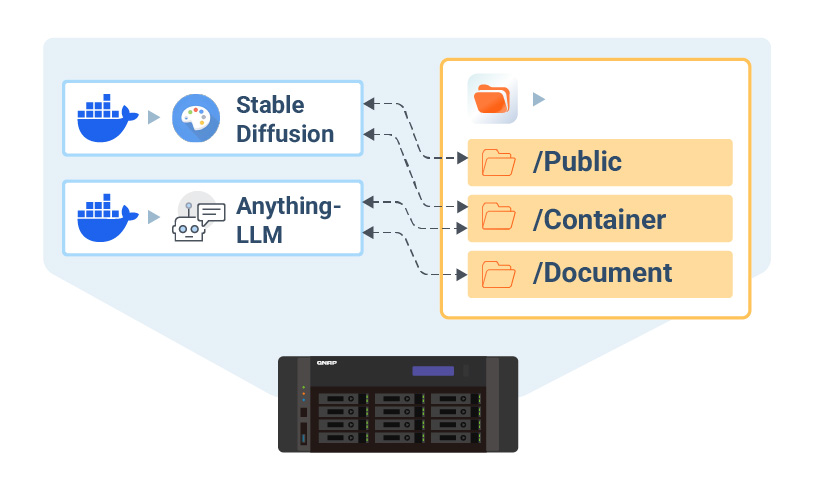
Maak GPU-versnelling eenvoudig en toegankelijk voor alle AI-werkbelastingen
De QAI-h1290FX verwijdert de complexiteit van het configureren van GPU-resources in Docker-omgevingen. Met de intuïtieve interface van Container Station selecteert u bij het aanmaken van een nieuwe container eenvoudig de gewenste NVIDIA® GPU uit het dropdownmenu, waarna de container direct toegang krijgt tot GPU-rekenkracht. Of u nu LLM's inzet, afbeeldingen genereert of deep learning-inferentie uitvoert, de QAI-h1290FX zorgt ervoor dat het proces naadloos en efficiënt verloopt.
Creativiteit herdefiniëren met AI-gedreven visueel ontwerp
ComfyUI geeft kunstenaars, ontwerpers en contentmakers een krachtige, modulaire interface voor AI-gestuurde beeld- en video-creatie. Dankzij het intuïtieve node-gebaseerde ontwerp en ondersteuning voor geavanceerde modellen zoals Stable Diffusion kunnen gebruikers moeiteloos visuele content genereren, transformeren en animeren. In combinatie met GPU-versnelling en flexibele workflows verlaagt ComfyUI de drempel voor complex visueel ontwerp—en biedt ongekende creatieve vrijheid.
AI-prestaties in de praktijk – gemeten op QAI-h1290FX
De prestaties van AI-implementatie worden gevalideerd via real-world benchmark gegevens. Onder een high-end GPU-testconfiguratie werd QAI-h1290FX volledig geëvalueerd met de NVIDIA® RTX™ PRO 6000 Blackwell Max-Q Workstation GPU, waarmee de prestaties voor on-premises AI-inferentie en enterprise-implementatiescenario's werden geverifieerd.
Ollama LLM Inference Benchmark (Snelle implementatie)
Dankzij de GPU-versnellingsmogelijkheden van de Blackwell-architectuur kan QAI-h1290FX lokaal een breed scala aan large language models draaien via Ollama.
Ollama maakt snelle implementatie en eenvoudig beheer mogelijk, waardoor het zeer geschikt is voor proof-of-concept (PoC)-projecten, single-user omgevingen en kleine tot middelgrote toepassingen zoals RAG-gebaseerd zoeken, AI-assistenten en offline inferentie.
vLLM gelijktijdige inferentie-benchmark (Enterprise-Grade Throughput)
Om te voldoen aan AI-diensten met meerdere gebruikers en hoge gelijktijdigheid, ondersteunt QAI-h1290FX ook implementatie met de vLLM-inferentie-engine.
In vergelijking met op één verzoek gerichte inferentie-methoden, verbetert vLLM het GPU-gebruik en de algehele doorvoer aanzienlijk door Paged Attention en efficiënte planningsmechanismen. Dit maakt het bijzonder geschikt voor enterprise AI-diensten, multi-user RAG-systemen en API-gebaseerde AI-toepassingen.
Bij dezelfde GPU-configuratie toont vLLM meer consistente latency-eigenschappen en een hogere tokens-per-seconde doorvoer in scenario's met gelijktijdige verzoeken, waardoor het ideaal is voor productieomgevingen en langdurige enterprise AI-implementaties.
Getest Large Language Model : deepseek-ai/DeepSeek-R1-Distill-Qwen-7B (Hugging Face)
Getest Large Language Model : openai/gpt-oss-20b (Hugging Face)
Ontgrendel AI-potentieel met praktische use-cases
Van documentautomatisering tot creatieve workflows en systeem-brede automatisering, de QAI-h1290FX stelt elke afdeling in staat om AI op zinvolle, meetbare manieren toe te passen—veilig gehost op uw eigen infrastructuur.
Geen cloud lock-in, geen complexe installatie—gewoon echte resultaten dankzij lokale LLM's, veilige containers en geïntegreerde QNAP-functies.
Smart HR Assistant – Interne Beleid Chatbot
Bouw een interne Q&A-assistent met AnythingLLM + Ollama. Upload HR-documenten zoals personeelshandboeken, verlofregelingen en voordelen naar de QAI-h1290FX. Medewerkers kunnen natuurlijke vragen stellen zoals:
“Hoe vraag ik gezinsverlof aan?”
Het systeem voert een lokale RAG-zoekopdracht uit en reageert direct, waardoor de HR-werkdruk vermindert en de responstijd verbetert.

Creative Team AI Studio – Image Generation Hub
Designteams gebruiken Stable Diffusion en ComfyUI, geïmplementeerd op de QAI-h1290FX, om promotieafbeeldingen, mockups of gestileerde kunstwerken te genereren via promptinvoer.
Dankzij GPU-versnelling en persistente NAS Opslag krijgen ontwerpers snelle en reproduceerbare resultaten—nooit meer opnieuw beginnen.

AI Co-Pilot voor Developers – Docs, Code & Samenvattingen
Engineeringteams draaien LLM's zoals Qwen of Llama in Ollama op de QAI-h1290FX om te helpen bij het schrijven van specificaties, code review en technische vertalingen.
Upload API-documentatie of whitepapers en chat vervolgens met het model voor verduidelijkingen, samenvattingen of zelfs markdown-opmaak—volledig offline en veilig.

n8n + NAS Automatisering – Trigger AI vanaf elke locatie
Met n8n geïnstalleerd op de QAI-h1290FX kun je taken automatiseren die AI integreren met bedrijfsprocessen. Bijvoorbeeld:

AI Docker-applicaties op QAI-h1290FX
Draai krachtige AI-oplossingen via Container Station & GPU-integratie.

Transformeer uw NAS tot een AI-gestuurde kennishub
Geef enterprise-gebruikers de mogelijkheid om sneller dan ooit te zoeken, begrijpen en informatie op te halen—mogelijk gemaakt door Qsirch en de next-generation RAG Search. De QAI-h1290FX brengt intelligentie naar uw documenten terwijl alles veilig en on-premises blijft.

Qsirch – Slimme Full-Text Search
Qsirch biedt razendsnelle full-text search over al uw NAS-bestanden—PDF's, Office-documenten, e-mails en meer. Met geavanceerde filters, indexering en previewfuncties kunnen gebruikers direct relevante documenten vinden in terabytes aan gegevens. Meer informatie

RAG Search – AI-gestuurde contextuele antwoorden
RAG (Retrieval-Augmented Generation) Search gaat nog verder door Qsirch te combineren met een lokaal Large Language Model (LLM). Wanneer gebruikers een vraag stellen, haalt het systeem eerst relevante bestanden op via Qsirch, waarna het een nauwkeurig, natuurlijk taalantwoord genereert met behulp van de on-device AI. Meer informatie
Op QAI-h1290FX is RAG Search volledig on-premises:
Standaard 5 jaar garantie
De QAI-h1290FX wordt ondersteund door een garantie van 5 jaar zonder extra kosten, wat voor uw bedrijfsorganisatie meer gemoedsrust betekent.

Edge AI Opslag Server Vergelijking:
QAI-h1290FX vs. andere AI NAS vs. AI Workstation
Hulp nodig?
Neem contact met ons op voor meer aanbevolen producten of oplossingen die zijn afgestemd op de behoeften en vereisten van uw organisatie!
Optionele accessoires
-

QM2-2P-244A
Dual M.2 22110/2280 PCIe SSD expansion card;
Dimension (L × W × H): 170.5 × 20.6 × 68.9 (mm)
Weight: 0.29 (kg)
Please check the M.2 SSD compatibility list and QM2 Installation Guide
-

QM2-2P-344A
Dual M.2 PCIe SSD expansion card; M.2 2280/22110 PCIe NVMe(Gen 3x4) SSDs; PCIe Gen3x4 host interface
Dimension (L × W × H): 170.5 × 19.3 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P-384A
Dual M.2 PCIe SSD expansion card; M.2 2280/22110 PCIe NVMe(Gen 3x4) SSDs; PCIe Gen3x8 host interface
Dimension (L × W × H): 170.5 × 19.3 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P10G1TB
QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen3 x 8 , 1 x Marvell AQC113C 10GbE NBASE-T port
Dimension (L × W × H): 152.65 × 18.9 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P2G2T
QNAP QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen3 x 4 , 2 x Intel I225LM 2.5GbE NBASE-T port
Dimension (L × W × H): 152.65 × 20.6 × 68.9 (mm)
Weight: 0.29 (kg)
-

QM2-2P410G1T (EOL)
QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen4 x 4 , 1 x AQC113C 10GbE NBASE-T port
Dimension (L × W × H): 187 × 19.35 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P410G2T (EOL)
QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen4 x 4 , 2 x AQC113C 10GbE NBASE-T port
Dimension (L × W × H): 187 × 19.35 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2S-220A
Dual M.2 22110/2280 SATA SSD expansion card;
Dimension (L × W × H): 147.15 × 20.6 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-4P-384
Quad M.2 PCIe SSD expansion card; supports up to four M.2 2280 formfactor M.2 PCIe (Gen3 x4) SSDs; PCIe Gen3 x8 host interface; Low-profile bracket pre-loaded, Low-profile flat and Full-height are bundled
Dimension (L × W × H): 204.95 × 68.9 × 20.6 (mm)
Weight: 0.32 (kg)
-

QM2-4S-240 (EOL)
Quad M.2 2280 SATA SSD expansion card
Dimension (L × W × H): 204.95 × 68.9 × 20.6 (mm)
Weight: 0.32 (kg)
-
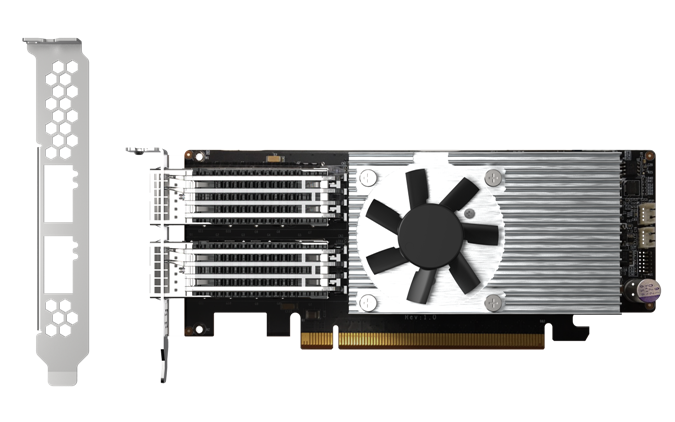
QXG-100G2SF-E810
Dual port 100GbE Network adapter; 2 x QSFP28; Intel E810 Ethernet controller
Dimension (L × W × H): 169.6 × 69 × 18.7 (mm)
Weight: 0.36 (kg)
-

QXG-10G1T
Single-port (10Gbase-T) 10GbE network expansion card, PCIe Gen3 x4, Low-profile bracket pre-loaded, Low-profile flat and Full-height are bundled
Dimension (L × W × H): 143 × 193 × 52 (mm)
Weight: 0.53 (kg)
-

QXG-10G2SF-X710
Dual-port SFP+ 10Gb network expansion card; low-profile formfactor; PCIe Gen3 x8
Dimension (L × W × H): 26 × 10.5 × 6 (mm)
Weight: 0.29 (kg)
-

QXG-10G2T
Dual-port 10GBASE-T 10Gb network expansion card; low-profile formfactor; PCIe Gen3 x4
Dimension (L × W × H): 54.5 × 39.5 × 18 (mm)
Weight: 0.24 (kg)
-

QXG-10G2T-X710
Dual-port 10GbE Network Adaptor, Intel 700 series Ethernet Controller
Dimension (L × W × H): 113.6 × 68.9 × 18.3 (mm)
Weight: 0.24 (kg)
-

QXG-10G2TB (EOL)
Dual-port 10GbE Network Adaptor, Aquantia AQC113C
Dimension (L × W × H): 104.7 × 16.1 × 68.9 (mm)
Weight: 0.28 (kg)
-

QXG-25G2SF-CX6
Dual-port SFP28 25Gb network expansion card; Mellanox ConnectX-6 Lx;low-profile formfactor; PCIe Gen4 x8
Dimension (L × W × H): 120 × 16.5 × 69 (mm)
Weight: 0.15 (kg)
-
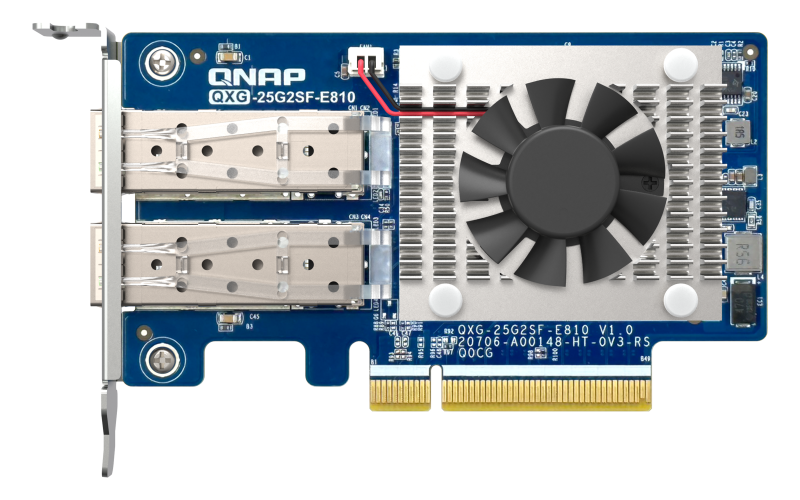
QXG-25G2SF-E810
2 port 25GbE(Intel E810-XXVAM2) Network Interface Cards (NIC)
Dimension (L × W × H): 119.3 × 68.9 × 18.1 (mm)
Weight: 0.23 (kg)
-

QXG-2G1T-I225
Single port 2.5GbE 4-speed Network card
Dimension (L × W × H): 67.3 × 68.9 × 25.2 (mm)
Weight: 0.19 (kg)
-

QXG-2G2T-I225
Dual port 2.5GbE 4-speed Network card
Dimension (L × W × H): 81.3 × 68.9 × 25.2 (mm)
Weight: 0.23 (kg)
-

QXG-2G4T-I225
Quad port 2.5GbE 4-speed Network card
Dimension (L × W × H): 104.6 × 68.9 × 24.1 (mm)
Weight: 0.24 (kg)
-

QXG-5G1T-111C
QNAP 5GbE multi-Gig expansion card;Aquantia AQC111C;Gen2 x 1;low profile
Dimension (L × W × H): 145 × 190 × 52 (mm)
Weight: 0.20 (kg)
-

QXG-5G2T-111C (EOL)
QNAP dual port 5GbE multi-Gig expansion card;Aquantia AQC111C;Gen2 x 2;low profile
Dimension (L × W × H): 145 × 190 × 52 (mm)
Weight: 0.20 (kg)
-
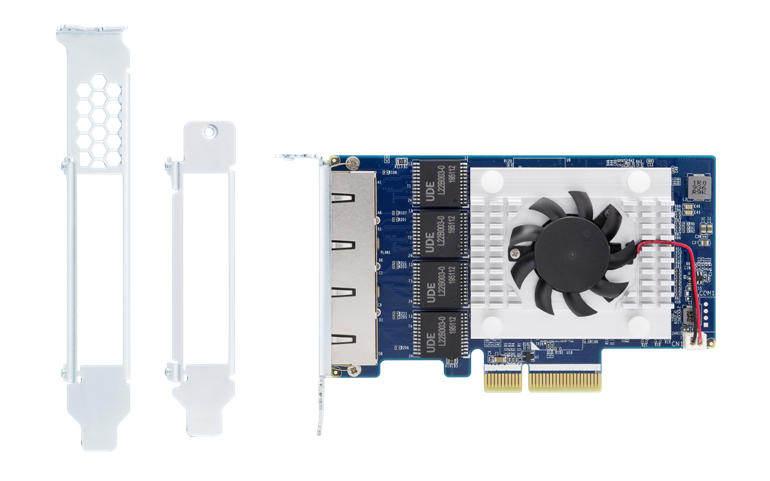
QXG-5G4T-111C (EOL)
QNAP Quad port 5GbE multi-Gig expansion card;Aquantia AQC111C;Gen2 x 4;low profile
Dimension (L × W × H): 145 × 190 × 52 (mm)
Weight: 0.23 (kg)
-

QXP-16G2FC
QNAP 2-port 16Gbps fiber channel adapter, PCIe 3.0 x8, SFP+, low profile, w/ SFP+ 16G transceivers
Dimension (L × W × H): 190 × 143 × 50 (mm)
Weight: 0.28 (kg)
-

QXP-32G2FC
QNAP 2-port 32Gbps fiber channel adapter, PCIe 3.0 x8, SFP+, low profile, w/ SFP+ 32G optical transceivers
Dimension (L × W × H): 190 × 143 × 50 (mm)
Weight: 0.28 (kg)
-
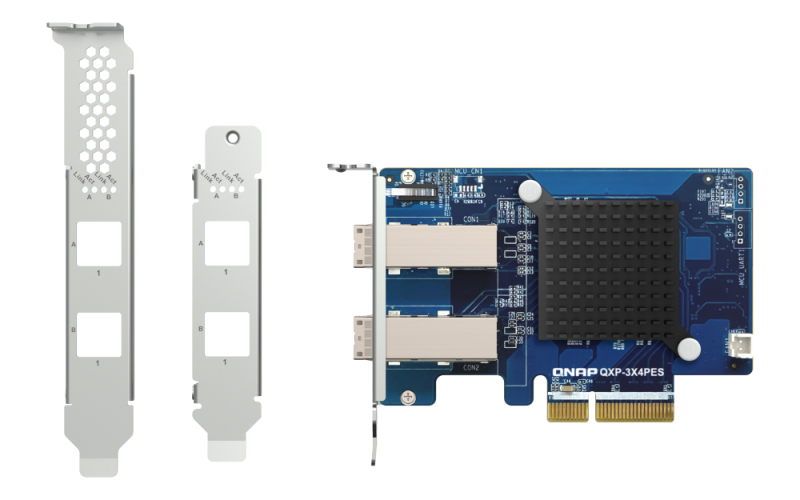
QXP-3X4PES
2 ports (SFF-8644) Expansion card; PCIe Gen3 x4 for QNAP PCIe JBOD series
Dimension (L × W × H): 102.65 × 68.9 × 19 (mm)
Weight: 0.11 (kg)
-
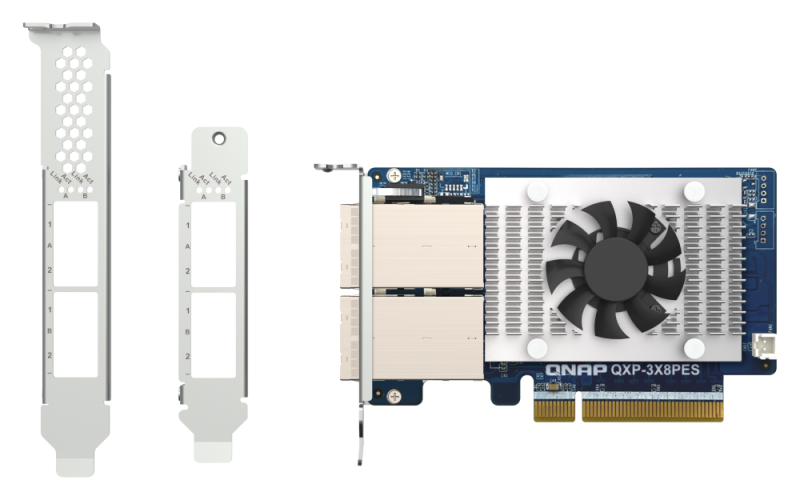
QXP-3X8PES
2 ports (SFF-8644 1x2) Expansion card; PCIe Gen3 x8 for QNAP PCIe JBOD series
Dimension (L × W × H): 112.65 × 68.9 × 18.26 (mm)
Weight: 0.17 (kg)
-
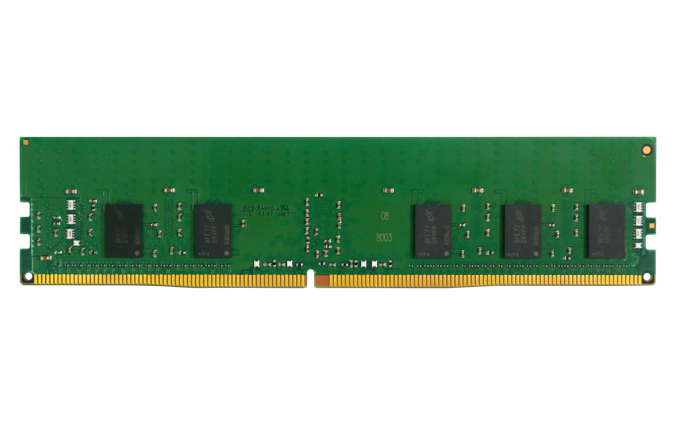
RAM-16GDR4ECT0-RD-3200
DDR type: DDR4(288PIN)
Capacity: 16GB
Spec: 1G X 8
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 2048M*72
Temperature: 0℃~85℃
Environmental Regulation: Halogen Free
-
RAM-32GDR4ECT0-RD-3200 (EOL)
DDR type: DDR4(288PIN)
Capacity: 32GB
Spec: 2G X 8
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 4G*72
Temperature: 0℃~85℃
Environmental Regulation: Halogen Free
-

RAM-32GDR4K0-RD-3200
32GB DDR4 RAM, 3200 MHz, RDIMM
-
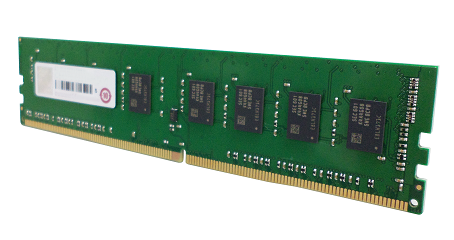
RAM-64GDR4ECK0-RD-3200 (EOL)
DDR type: DDR4(288PIN)
Capacity: 64GB
Spec: 4G X 4
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 8G*72
Temperature: 0℃~85℃
Environmental Regulation: RoHS
-
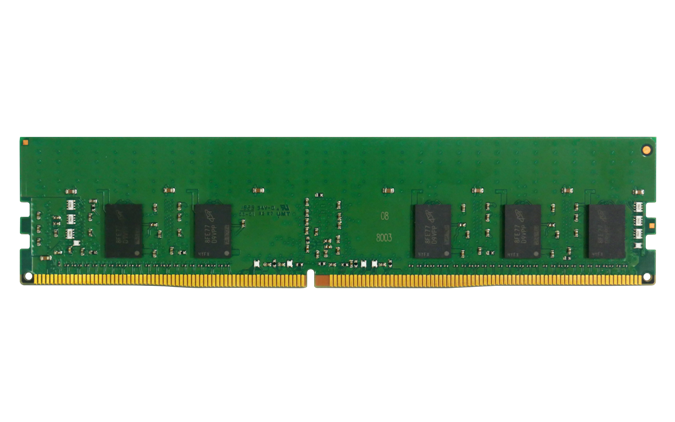
RAM-8GDR4ECT0-RD-3200
DDR type: DDR4(288PIN)
Capacity: 8GB
Spec: 1G X 8
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 1024M*72
Temperature: 0℃~85℃
Environmental Regulation: Halogen Free
-

CAB-PWR20M-C1314
Power Cord, 2M, C13-C14, 250V, 10A, IEC
Dimension (L × W × H): 180 × 29 × 21 (mm)
Weight: 0.19 (kg)


