


QAI-h1290FX
Um servidor de armazenamento Edge AI pronto para GPU, compatível com GPUs NVIDIA®, SSDs U.2 NVMe e conectividade 25GbE—projetado para IA local, virtualização e cargas de trabalho intensivas em computação.
QAI-h1290FX é um servidor de convergência de computação e armazenamento de classe desktop que combina arquitetura de computação de alto desempenho com armazenamento ultrarrápido. Ele suporta GPUs NVIDIA® RTX™ PRO Blackwell configuráveis, tornando-o ideal para IA local, inferência de LLM, pesquisa RAG privada, virtualização e outras cargas de trabalho exigentes de computação.
Com tecnologia QuTS hero e sistema de arquivos ZFS, a plataforma oferece integridade de dados em nível empresarial e desempenho consistente. Seja para implantação de IA, pesquisa e desenvolvimento, computação de alto desempenho ou ambientes de virtualização corporativa, o QAI-h1290FX permite configuração flexível e implantação rápida, garantindo que cargas de trabalho críticas rodem com segurança e eficiência na borda.


Arquitetura pronta para GPU com suporte a RTX PRO Blackwell
Projetado para uso com GPU, suporta GPUs NVIDIA® RTX™ PRO Blackwell, incluindo opções como a RTX PRO 6000 Blackwell Max-Q Workstation, para atender às demandas de cargas de trabalho de IA, geração de imagens, inferência e computação acelerada por GPU.
Arquitetura de armazenamento NVMe totalmente flash de alta velocidade
Equipado com 12 baias para SSD U.2 NVMe e suporte a SSDs SATA, permitindo configurações de armazenamento flexíveis otimizadas para desempenho, capacidade ou custo. Ideal para cargas de trabalho de IA, virtualização e processamento de dados em tempo real.
LLM local e pesquisa RAG
Permite a implantação local de LLMs privados e pesquisa baseada em RAG, proporcionando recuperação semântica segura de documentos sem enviar dados sensíveis para a nuvem.
Sistema operacional QuTS hero baseado em ZFS
Com tecnologia QuTS hero e ZFS, oferece compactação integrada, autorrecuperação, snapshots e SnapSync para integridade de dados em nível empresarial.
Aceleração por GPU e templates de aplicativos de IA
Aproveite a aceleração por GPU via Container Station. Implemente Ollama, AnythingLLM, Stable Diffusion, etc., com um clique. Simplificando o lançamento de aplicações de IA.
Conectividade 25GbE e pronto para expansão
Portas integradas duplas de 25GbE e 2,5GbE, com possibilidade de upgrade para 100GbE. Expanda com JBODs QNAP para atender às crescentes demandas de armazenamento de dados de IA.


Sistema Operacional QuTS hero
Premiado com o prêmio 2026 MSP Today Product of the Year

QNAP QAI-h1290FX
Vencedor do prêmio TechRadar Pro Picks Awards no CES 2026
Aplicações ideais do QAI
-
Chatbot interno e base de conhecimento
Implemente bots privados semelhantes ao ChatGPT usando AnythingLLM ou OpenWebUI. Conecte-se com segurança a documentos internos para perguntas e respostas de funcionários, busca de políticas e suporte a treinamentos—sem necessidade de internet.

-
Motor de busca RAG privado
Execute o Retrieval-Augmented Generation (RAG) localmente com controle total sobre os dados. Permita buscas em linguagem natural em contratos, relatórios e arquivos—ideal para equipes jurídicas, financeiras e corporativas.

-
Inferência de IA e geração de conteúdo
Use Stable Diffusion ou ComfyUI para geração de imagens, ou implemente modelos personalizados para marcação de vídeos, resumo de documentos e análise médica. Aproveite a aceleração por GPU e armazenamento all-flash.

Edge AI de nível empresarial e computação de alto desempenho
QAI-h1290FX é mais do que um sistema de armazenamento — é uma plataforma de edge computing pronta para computação e de nível empresarial. Construída sobre uma arquitetura de computação de alto desempenho, suporta GPUs NVIDIA® RTX™ Pro Blackwell configuráveis, tornando-a ideal para inferência de grandes modelos de linguagem (LLM), geração de imagens, busca RAG e uma ampla gama de cargas de trabalho virtualizadas e intensivas em computação.
Seja para inferência de IA, pesquisa e desenvolvimento, análise de dados ou aplicações empresariais que exigem alto número de núcleos e desempenho sustentado, uma única plataforma empresarial de classe desktop pode oferecer excelente eficiência computacional e segurança de dados totalmente on-premises.
Desempenho máximo de computação de IA (configuração opcional de GPU)

Arquitetura pronta para GPU — Compatível com NVIDIA® RTX™ Pro Blackwell
QAI-h1290FX possui uma arquitetura pronta para GPU projetada para suportar GPUs NVIDIA® RTX™ Pro Blackwell. Baseada na arquitetura Blackwell, oferece suporte a tecnologias de aceleração como CUDA, TensorRT e Transformer Engine, tornando-a ideal para cargas de trabalho modernas de IA e computação acelerada por GPU.
Desde inferência de grandes modelos de linguagem (LLM) e visão computacional até IA generativa e outras aplicações profissionais aceleradas por GPU, as cargas de trabalho podem ser implantadas e executadas totalmente on-premises—oferecendo alto desempenho enquanto mantém a privacidade dos dados e controle total do sistema. A plataforma também pode operar como um sistema de computação de alto desempenho centrado em CPU, suportando virtualização e uma ampla gama de cenários de computação corporativa.
-
 Flagship
Workstation NVIDIA® RTX™ Pro 6000 Blackwell Max-Q
- 96 GB de memória GDDR7 ECC
- 24.064 núcleos CUDA, 752 núcleos Tensor, 188 núcleos RT
- 125 TFLOPS (FP32), até 4000 AI TOPS
- Largura de banda de memória de 1.792 GB/s
- Consumo de energia de 300W
- Interface PCIe 5.0 x16
-
 Desempenho
NVIDIA® RTX™ Pro 4500 Blackwell
- 32 GB de memória GDDR7 ECC
- 10.496 núcleos CUDA, 328 núcleos Tensor, 82 núcleos RT
- 54,94 TFLOPS (FP32)
- Largura de banda de memória de 896 GB/s
- Consumo de energia de 200W
- Interface PCIe 5.0 x16
Série NVIDIA® RTX™ Pro Blackwell — Redefinindo fluxos de trabalho de IA e computação de alto desempenho
As GPUs da série NVIDIA® RTX™ Pro Blackwell são projetadas para cargas de trabalho intensas de IA, computação e criação, combinando a arquitetura Blackwell de próxima geração com memória GDDR7 ECC ultrarrápida. Isso oferece um nível de desempenho computacional e capacidade de VRAM em uma única GPU profissional que antes exigia múltiplas placas gráficas de consumo.
Com suporte para até 96GB de VRAM e capacidades aprimoradas de aceleração de IA, a série RTX™ Pro Blackwell é ideal para LLMs avançados, modelos generativos, análise de dados e fluxos de trabalho complexos de visualização 3D e computação profissional.

Equipado com processadores AMD EPYC™ de classe servidor para computação de alto desempenho
QAI-h1290FX é construído sobre uma plataforma de processador AMD EPYC de classe servidor, oferecendo alta contagem de núcleos e desempenho massivo em multithread.
Projetado para operação estável e de longo prazo sob cargas altamente paralelas, é ideal para virtualização, computação multithread, processamento de dados e cenários de edge computing—além de suportar inferência de IA e uma ampla gama de aplicações intensivas em computação.

Sistema operativo QuTS hero
Concebido para empresas, o sistema operativo QuTS hero adota o sistema de ficheiros ZFS altamente fiável que visa proporcionar a máxima integridade e estabilidade dos dados para armazenamento essencial. O QuTS hero otimiza ainda mais o desempenho e a capacidade de reescrita dos SSD a fim de satisfazer as exigências rigorosas das empresas em termos de desempenho e fiabilidade. Explore o sistema operativo QuTS hero Conheça as mais recentes funcionalidades do QuTS hero
Acesso remoto à IA local – a qualquer hora, em qualquer lugar
Crie um ambiente de trabalho híbrido perfeito com várias opções de acesso remoto oferecidas pela QNAP. Seja gerenciando aplicativos de IA ou acessando arquivos, o QAI-h1290FX garante que você esteja sempre conectado—sem comprometer a segurança.
Opções de acesso direto ou via relay
- myQNAPcloud DDNS:
Acesse sua interface QuTS hero de qualquer lugar via um domínio personalizado, sem precisar lembrar endereços IP. - myQNAPcloud Link:
Estabelece uma conexão relay segura através dos servidores QNAP—sem necessidade de abrir portas do roteador ou modificar configurações de firewall. - Suporte a servidor VPN:
Configure uma VPN privada usando o Serviço QVPN, permitindo túneis criptografados seguros para acesso total à rede.
Seja ajustando sua configuração de container LLM, revisando logs de inferência ou colaborando entre locais, o QAI-h1290FX oferece acesso confiável ao seu ambiente de IA local de qualquer dispositivo, a qualquer momento.

Uma Container Station mais poderosa: uma nova experiência na implantação de aplicações de IA
Para promover a adoção prática de IA, a série QAI integra o Container Station com uma ampla seleção de modelos de aplicativos de IA. Esses modelos permitem a implantação com um clique de ferramentas e frameworks de IA populares, com atualizações regulares da QNAP para garantir acesso às tecnologias mais recentes.
Se você está começando em IA ou deseja migrar cargas de trabalho para o local, o QAI facilita a exploração de IA, reduz custos, aumenta a segurança dos dados e até permite desenvolver ferramentas de IA personalizadas para impulsionar a inovação nos negócios.

Implantação de IA em contêineres simplificada
Aprimore sua infraestrutura de IA com integração perfeita de contêineres. Explorar o Container Station
Ambiente de contêineres centrado em IA
O QAI-h1290FX vem com o Container Station, permitindo a implantação de contêineres Docker e LXD. Como a maioria das ferramentas de IA hoje são entregues como aplicativos em contêiner, o QAI-h1290FX oferece uma maneira direta e eficiente de implantar modelos como LLM, RAG Search, geração de imagens (ex.: Stable Diffusion) ou motores de base de conhecimento como o AnythingLLM — tudo isso sem configurações complexas.

Armazenamento de dados persistente para modelos de IA
Com suporte ao Docker Volume, o QAI-h1290FX permite que os contêineres montem pastas compartilhadas do NAS, garantindo armazenamento persistente mesmo após a reconstrução dos contêineres. Isso é especialmente benéfico para cargas de trabalho de IA que envolvem grandes arquivos de modelos, dados de treinamento ou logs. Não se preocupe mais em perder dados importantes durante atualizações ou trocas de versão.

Torne a aceleração por GPU simples e acessível para todas as cargas de trabalho de IA
O QAI-h1290FX elimina a complexidade de configurar recursos de GPU em ambientes Docker. Com a interface intuitiva do Container Station, ao criar um novo contêiner, basta selecionar a GPU NVIDIA® desejada no menu suspenso e o contêiner terá acesso imediato às capacidades de computação da GPU. Seja para implantar LLMs, gerar imagens ou executar inferência de deep learning, o QAI-h1290FX garante que o processo seja simples e eficiente.

Redefinindo a criatividade com design visual impulsionado por IA
O ComfyUI capacita artistas, designers e criadores de conteúdo com uma interface poderosa e modular para criação de imagens e vídeos com IA. Por meio de seu design intuitivo baseado em nós e suporte a modelos avançados como o Stable Diffusion, os usuários podem gerar, transformar e animar conteúdos visuais com facilidade. Combinando aceleração por GPU e fluxos de trabalho flexíveis, o ComfyUI reduz a barreira para design visual complexo—liberando uma liberdade criativa sem precedentes.
Desempenho de IA no mundo real – medido em QAI-h1290FX
O desempenho de implantação de IA é validado por meio de dados de benchmark do mundo real. Em uma configuração de teste com GPU de alto desempenho, o QAI-h1290FX foi totalmente avaliado com a GPU NVIDIA® RTX™ PRO 6000 Blackwell Max-Q Workstation, comprovando seu desempenho em cenários de inferência de IA local e implantação corporativa.
Benchmark de Inferência LLM com Ollama (Implantação Rápida)
Aproveitando as capacidades de aceleração de GPU da arquitetura Blackwell, o QAI-h1290FX pode executar localmente uma ampla variedade de grandes modelos de linguagem via Ollama.
O Ollama permite implantação rápida e gerenciamento simplificado, tornando-o ideal para projetos de prova de conceito (PoC), ambientes de usuário único e casos de uso de pequeno a médio porte, como busca baseada em RAG, assistentes de IA e inferência offline.
Benchmark de Inferência Concorrente vLLM (Throughput de nível empresarial)
Para atender aos requisitos de serviços de IA multiusuário e de alta concorrência, QAI-h1290FX também suporta implantação com o mecanismo de inferência vLLM.
Comparado a abordagens de inferência orientadas a requisições únicas, o vLLM melhora significativamente a utilização da GPU e o throughput geral por meio do Paged Attention e mecanismos eficientes de agendamento. Isso o torna especialmente adequado para serviços de IA empresariais, sistemas RAG multiusuário e aplicações de IA baseadas em API.
Com a mesma configuração de GPU, o vLLM demonstra características de latência mais consistentes e maior throughput de tokens por segundo em cenários de requisições concorrentes, tornando-o ideal para ambientes de produção e implantações de IA empresariais de longa duração.
Modelo de Linguagem Extensa testado: deepseek-ai/DeepSeek-R1-Distill-Qwen-7B (Hugging Face)
Modelo de Linguagem de Grande Porte testado: openai/gpt-oss-20b (Hugging Face)
Desbloqueie o potencial da IA com casos de uso práticos
Da automação de documentos a fluxos de trabalho criativos e automação em todo o sistema, o QAI-h1290FX capacita todos os departamentos a aplicar IA de maneiras significativas e mensuráveis—hospedado com segurança na sua própria infraestrutura.
Sem dependência de nuvem, sem configuração complexa—apenas resultados reais impulsionados por LLMs locais, containers seguros e recursos integrados da QNAP.
Assistente de RH Inteligente – Chatbot de Políticas Internas
Crie um assistente interno de perguntas e respostas usando AnythingLLM + Ollama. Faça upload de documentos de RH, como manuais de funcionários, políticas de licença e benefícios no QAI-h1290FX. Os funcionários podem fazer perguntas naturais como:
“Como faço para solicitar licença para cuidados familiares?”
O sistema realiza busca RAG local e responde instantaneamente, reduzindo a carga de trabalho do RH e melhorando o tempo de resposta.

Estúdio de IA para Equipe Criativa – Hub de Geração de Imagens
As equipes de design usam Stable Diffusion e ComfyUI implantados no QAI-h1290FX para gerar imagens promocionais, mockups ou artes estilizadas via entrada de prompt.
Graças à aceleração por GPU e ao armazenamento persistente do NAS, os designers obtêm resultados rápidos e reproduzíveis—não é mais preciso começar do zero.

Co-Piloto de IA para Desenvolvedores – Documentos, Código e Resumos
As equipes de engenharia executam LLMs como Qwen ou Llama no Ollama no QAI-h1290FX para auxiliar na redação de especificações, revisão de código e traduções técnicas.
Envie documentos de API ou whitepapers e converse com o modelo para esclarecimentos, resumos ou até mesmo formatação em markdown—tudo offline e seguro.

n8n + Automação NAS – Acione IA de Qualquer Lugar
Com o n8n instalado no QAI-h1290FX, você pode automatizar tarefas que integram IA às operações de negócios. Por exemplo:

Aplicativos Docker de IA no QAI-h1290FX
Execute soluções de IA poderosas via Container Station e integração com GPU.

Transforme seu NAS em um hub de conhecimento com IA
Permita que usuários corporativos pesquisem, compreendam e recuperem informações mais rápido do que nunca—impulsionado por Qsirch e pela próxima geração da pesquisa RAG. O QAI-h1290FX traz inteligência para seus documentos mantendo tudo seguro e local.

Qsirch – Pesquisa inteligente de texto completo
Qsirch oferece pesquisa de texto completo ultrarrápida em todos os seus arquivos do NAS—PDFs, documentos do Office, e-mails e muito mais. Com filtros avançados, indexação e funções de visualização, os usuários localizam documentos relevantes instantaneamente em terabytes de dados. Saiba mais

Pesquisa RAG – Respostas contextuais com IA
A Pesquisa RAG (Retrieval-Augmented Generation) vai além ao combinar Qsirch com um modelo de linguagem grande local (LLM). Quando os usuários fazem uma pergunta, o sistema primeiro recupera arquivos relevantes via Qsirch e, em seguida, gera uma resposta precisa e natural usando a IA no dispositivo. Saiba mais
No QAI-h1290FX, a Pesquisa RAG é totalmente local:
5 anos de garantia padrão
O QAI-h1290FX possui uma garantia de 5 anos sem custos adicionais, proporcionando maior tranquilidade à sua organização empresarial.

Comparação de servidores de armazenamento Edge AI:
QAI-h1290FX vs. outros NAS de IA vs. estação de trabalho de IA
Precisa de ajuda?
Contacte-nos agora para obter mais recomendações de produtos ou soluções adaptadas às suas necessidades e exigências!
Acessórios opcionais
-

QM2-2P-244A
Dual M.2 22110/2280 PCIe SSD expansion card;
Dimension (L × W × H): 170.5 × 20.6 × 68.9 (mm)
Weight: 0.29 (kg)
Please check the M.2 SSD compatibility list and QM2 Installation Guide
-

QM2-2P-344A
Dual M.2 PCIe SSD expansion card; M.2 2280/22110 PCIe NVMe(Gen 3x4) SSDs; PCIe Gen3x4 host interface
Dimension (L × W × H): 170.5 × 19.3 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P-384A
Dual M.2 PCIe SSD expansion card; M.2 2280/22110 PCIe NVMe(Gen 3x4) SSDs; PCIe Gen3x8 host interface
Dimension (L × W × H): 170.5 × 19.3 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P10G1TB
QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen3 x 8 , 1 x Marvell AQC113C 10GbE NBASE-T port
Dimension (L × W × H): 152.65 × 18.9 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P2G2T
QNAP QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen3 x 4 , 2 x Intel I225LM 2.5GbE NBASE-T port
Dimension (L × W × H): 152.65 × 20.6 × 68.9 (mm)
Weight: 0.29 (kg)
-

QM2-2P410G1T (EOL)
QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen4 x 4 , 1 x AQC113C 10GbE NBASE-T port
Dimension (L × W × H): 187 × 19.35 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P410G2T (EOL)
QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen4 x 4 , 2 x AQC113C 10GbE NBASE-T port
Dimension (L × W × H): 187 × 19.35 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2S-220A
Dual M.2 22110/2280 SATA SSD expansion card;
Dimension (L × W × H): 147.15 × 20.6 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-4P-384
Quad M.2 PCIe SSD expansion card; supports up to four M.2 2280 formfactor M.2 PCIe (Gen3 x4) SSDs; PCIe Gen3 x8 host interface; Low-profile bracket pre-loaded, Low-profile flat and Full-height are bundled
Dimension (L × W × H): 204.95 × 68.9 × 20.6 (mm)
Weight: 0.32 (kg)
-

QM2-4S-240 (EOL)
Quad M.2 2280 SATA SSD expansion card
Dimension (L × W × H): 204.95 × 68.9 × 20.6 (mm)
Weight: 0.32 (kg)
-
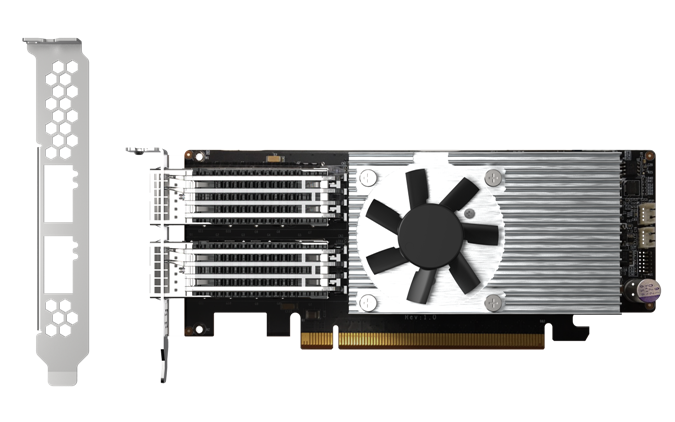
QXG-100G2SF-E810
Dual port 100GbE Network adapter; 2 x QSFP28; Intel E810 Ethernet controller
Dimension (L × W × H): 169.6 × 69 × 18.7 (mm)
Weight: 0.36 (kg)
-

QXG-10G1T
Single-port (10Gbase-T) 10GbE network expansion card, PCIe Gen3 x4, Low-profile bracket pre-loaded, Low-profile flat and Full-height are bundled
Dimension (L × W × H): 143 × 193 × 52 (mm)
Weight: 0.53 (kg)
-

QXG-10G2SF-X710
Dual-port SFP+ 10Gb network expansion card; low-profile formfactor; PCIe Gen3 x8
Dimension (L × W × H): 26 × 10.5 × 6 (mm)
Weight: 0.29 (kg)
-

QXG-10G2T
Dual-port 10GBASE-T 10Gb network expansion card; low-profile formfactor; PCIe Gen3 x4
Dimension (L × W × H): 54.5 × 39.5 × 18 (mm)
Weight: 0.24 (kg)
-

QXG-10G2T-X710
Dual-port 10GbE Network Adaptor, Intel 700 series Ethernet Controller
Dimension (L × W × H): 113.6 × 68.9 × 18.3 (mm)
Weight: 0.24 (kg)
-

QXG-10G2TB (EOL)
Dual-port 10GbE Network Adaptor, Aquantia AQC113C
Dimension (L × W × H): 104.7 × 16.1 × 68.9 (mm)
Weight: 0.28 (kg)
-

QXG-25G2SF-CX6
Dual-port SFP28 25Gb network expansion card; Mellanox ConnectX-6 Lx;low-profile formfactor; PCIe Gen4 x8
Dimension (L × W × H): 120 × 16.5 × 69 (mm)
Weight: 0.15 (kg)
-
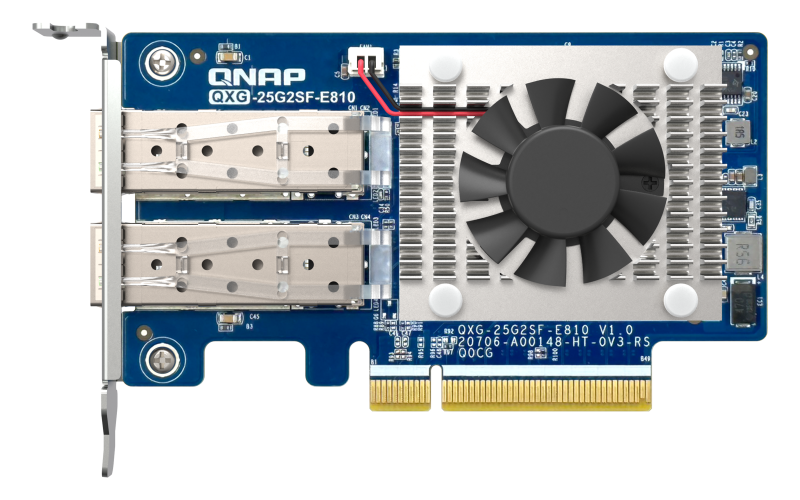
QXG-25G2SF-E810
2 port 25GbE(Intel E810-XXVAM2) Network Interface Cards (NIC)
Dimension (L × W × H): 119.3 × 68.9 × 18.1 (mm)
Weight: 0.23 (kg)
-

QXG-2G1T-I225
Single port 2.5GbE 4-speed Network card
Dimension (L × W × H): 67.3 × 68.9 × 25.2 (mm)
Weight: 0.19 (kg)
-

QXG-2G2T-I225
Dual port 2.5GbE 4-speed Network card
Dimension (L × W × H): 81.3 × 68.9 × 25.2 (mm)
Weight: 0.23 (kg)
-

QXG-2G4T-I225
Quad port 2.5GbE 4-speed Network card
Dimension (L × W × H): 104.6 × 68.9 × 24.1 (mm)
Weight: 0.24 (kg)
-

QXG-5G1T-111C
QNAP 5GbE multi-Gig expansion card;Aquantia AQC111C;Gen2 x 1;low profile
Dimension (L × W × H): 145 × 190 × 52 (mm)
Weight: 0.20 (kg)
-

QXG-5G2T-111C (EOL)
QNAP dual port 5GbE multi-Gig expansion card;Aquantia AQC111C;Gen2 x 2;low profile
Dimension (L × W × H): 145 × 190 × 52 (mm)
Weight: 0.20 (kg)
-
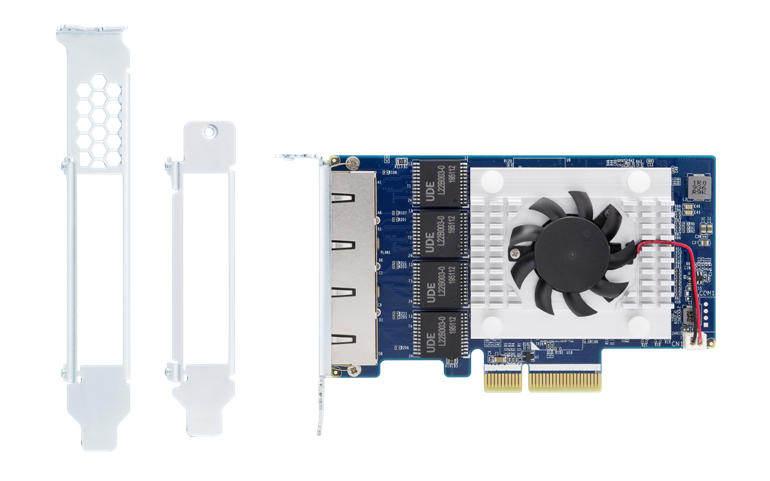
QXG-5G4T-111C (EOL)
QNAP Quad port 5GbE multi-Gig expansion card;Aquantia AQC111C;Gen2 x 4;low profile
Dimension (L × W × H): 145 × 190 × 52 (mm)
Weight: 0.23 (kg)
-

QXP-16G2FC
QNAP 2-port 16Gbps fiber channel adapter, PCIe 3.0 x8, SFP+, low profile, w/ SFP+ 16G transceivers
Dimension (L × W × H): 190 × 143 × 50 (mm)
Weight: 0.28 (kg)
-

QXP-32G2FC
QNAP 2-port 32Gbps fiber channel adapter, PCIe 3.0 x8, SFP+, low profile, w/ SFP+ 32G optical transceivers
Dimension (L × W × H): 190 × 143 × 50 (mm)
Weight: 0.28 (kg)
-
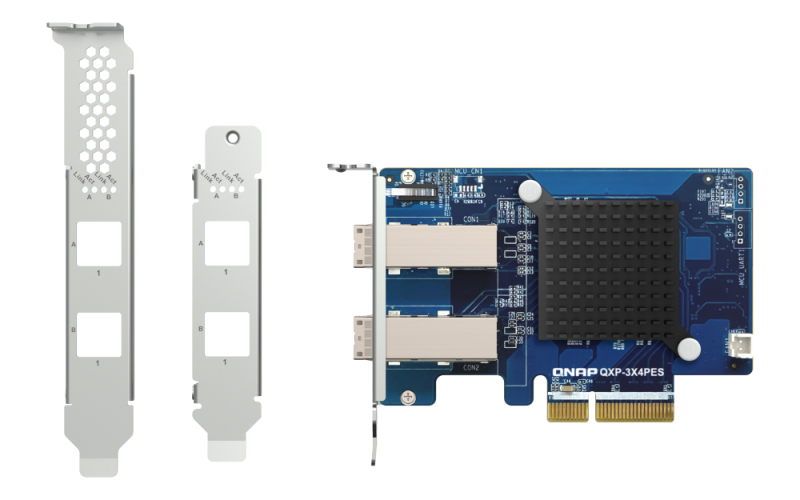
QXP-3X4PES
2 ports (SFF-8644) Expansion card; PCIe Gen3 x4 for QNAP PCIe JBOD series
Dimension (L × W × H): 102.65 × 68.9 × 19 (mm)
Weight: 0.11 (kg)
-
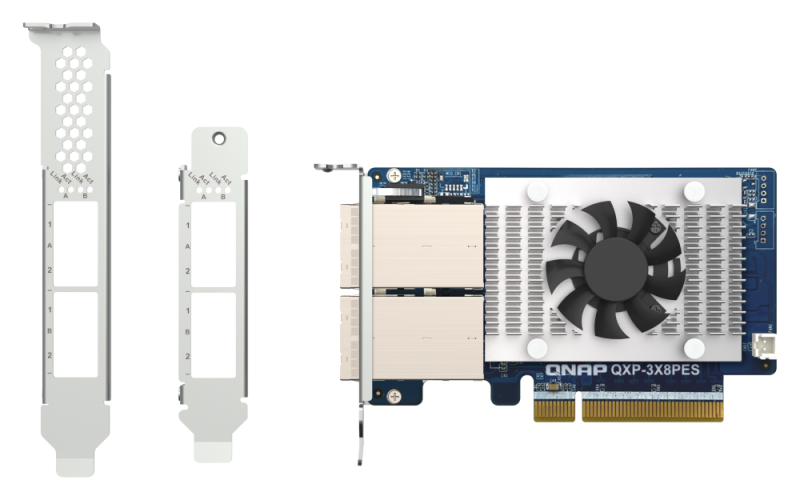
QXP-3X8PES
2 ports (SFF-8644 1x2) Expansion card; PCIe Gen3 x8 for QNAP PCIe JBOD series
Dimension (L × W × H): 112.65 × 68.9 × 18.26 (mm)
Weight: 0.17 (kg)
-
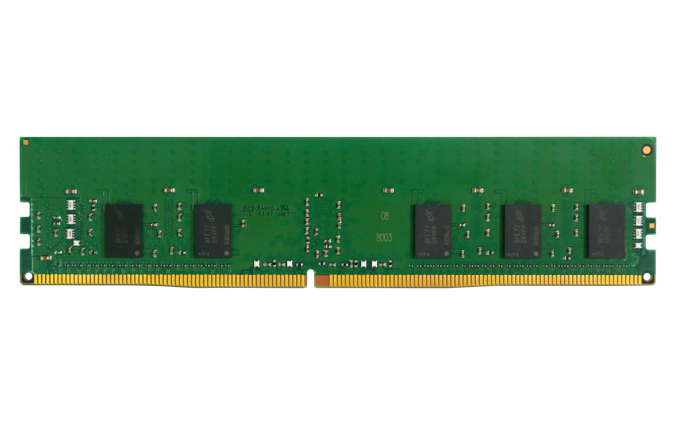
RAM-16GDR4ECT0-RD-3200
DDR type: DDR4(288PIN)
Capacity: 16GB
Spec: 1G X 8
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 2048M*72
Temperature: 0℃~85℃
Environmental Regulation: Halogen Free
-
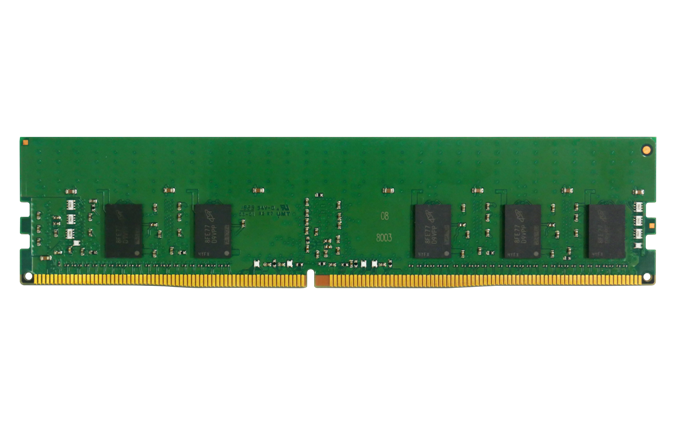
RAM-32GDR4ECT0-RD-3200 (EOL)
DDR type: DDR4(288PIN)
Capacity: 32GB
Spec: 2G X 8
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 4G*72
Temperature: 0℃~85℃
Environmental Regulation: Halogen Free
-

RAM-32GDR4K0-RD-3200
32GB DDR4 RAM, 3200 MHz, RDIMM
-
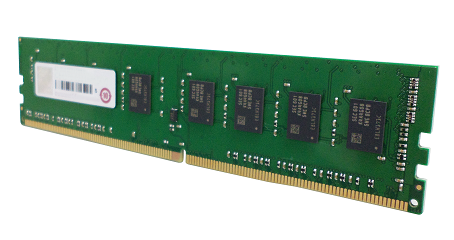
RAM-64GDR4ECK0-RD-3200 (EOL)
DDR type: DDR4(288PIN)
Capacity: 64GB
Spec: 4G X 4
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 8G*72
Temperature: 0℃~85℃
Environmental Regulation: RoHS
-
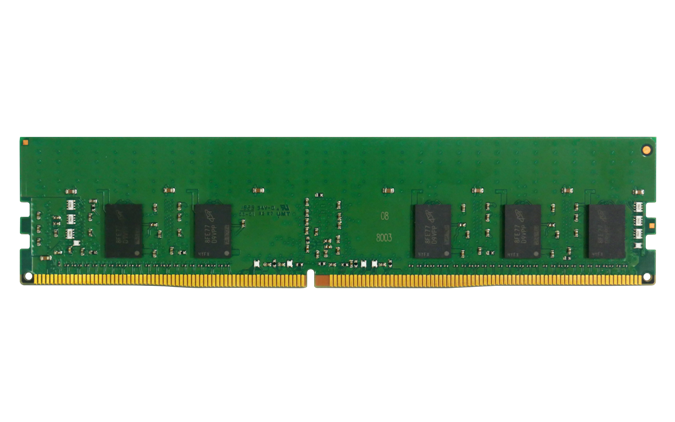
RAM-8GDR4ECT0-RD-3200
DDR type: DDR4(288PIN)
Capacity: 8GB
Spec: 1G X 8
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 1024M*72
Temperature: 0℃~85℃
Environmental Regulation: Halogen Free
-

CAB-PWR20M-C1314
Power Cord, 2M, C13-C14, 250V, 10A, IEC
Dimension (L × W × H): 180 × 29 × 21 (mm)
Weight: 0.19 (kg)


