


QAI-h1290FX
Egy GPU-képes edge AI tárolószerver, amely támogatja az NVIDIA® GPU-kat, U.2 NVMe SSD-ket és 25GbE csatlakozást—helyszíni AI, virtualizáció és számításigényes feladatokhoz tervezve.
QAI-h1290FX egy asztali kategóriás edge számítási és tároló konvergencia szerver, amely nagy teljesítményű számítási architektúrát ötvöz villámgyors tárolással. Támogatja a konfigurálható NVIDIA® RTX™ PRO Blackwell GPU-kat, így ideális helyszíni AI, LLM következtetés, privát RAG keresés, virtualizáció és egyéb nagy számítási igényű feladatokhoz.
A QuTS hero ZFS fájlrendszerrel vállalati szintű adatvédelmet és állandó teljesítményt nyújt. Legyen szó AI bevezetésről, K+F-ről, nagy teljesítményű számításról vagy vállalati virtualizációs környezetről, a QAI-h1290FX rugalmas konfigurációt és gyors bevezetést tesz lehetővé, biztosítva, hogy a kritikus feladatok biztonságosan és hatékonyan fussanak az edge-en.


GPU-képes architektúra RTX PRO Blackwell támogatással
GPU-képes kialakítással, amely támogatja az NVIDIA® RTX™ PRO Blackwell GPU-kat, beleértve az olyan opciókat, mint az RTX PRO 6000 Blackwell Max-Q munkaállomás, hogy megfeleljen az AI feladatok, képgenerálás, következtetés és GPU-gyorsított számítás igényeinek.
Nagy sebességű, teljesen flash NVMe tárolóarchitektúra
12 U.2 NVMe SSD fiókkal és SATA SSD támogatással felszerelve, lehetővé téve a teljesítményre, kapacitásra vagy költségre optimalizált rugalmas tárolókonfigurációkat. Ideális AI feladatokhoz, virtualizációhoz és valós idejű adatfeldolgozáshoz.
Helyszíni LLM & RAG keresés
Lehetővé teszi privát LLM-ek és RAG-alapú keresés helyi telepítését, biztonságos szemantikus dokumentumlekérdezést biztosítva anélkül, hogy érzékeny adatokat küldene a felhőbe.
ZFS-alapú QuTS hero operációs rendszer
A QuTS hero ZFS-szel működik, amely inline tömörítést, önjavítást, pillanatképeket és SnapSync-et kínál vállalati szintű adatvédelemhez.
GPU-gyorsítás és AI alkalmazás sablonok
Használja ki a GPU-gyorsítást a Container Station segítségével. Egy kattintással telepíthető az Ollama, AnythingLLM, Stable Diffusion stb. Egyszerűsíti az AI alkalmazások bevezetését.
25GbE csatlakozás és bővíthetőség
Beépített dupla 25GbE és 2,5GbE portok, valamint bővíthető 100GbE-re. Bővíthető QNAP JBOD-okkal a növekvő AI adattárolási igények kielégítésére.


QuTS hero operációs rendszer
A 2026 MSP Today Product of the Year díjjal kitüntetve

QNAP QAI-h1290FX
TechRadar Pro Picks Awards győztes a CES 2026-on
QAI Ideális alkalmazások
-
Belső chatbot és tudásbázis
Telepítsen privát ChatGPT-szerű botokat az AnythingLLM vagy OpenWebUI segítségével. Biztonságosan csatlakoztassa a belső dokumentumokat dolgozói kérdésekhez, szabályzatkereséshez és képzési támogatáshoz – internetkapcsolat nélkül.

-
Privát RAG keresőmotor
Futtassa a Retrieval-Augmented Generation (RAG) megoldást helyben, teljes adatkontrollal. Tegye lehetővé a természetes nyelvű dokumentumkeresést szerződések, jelentések és archívumok között – ideális jogi, pénzügyi és vállalati csapatok számára.

-
AI következtetés és tartalomgenerálás
Használja a Stable Diffusion-t vagy a ComfyUI-t képgeneráláshoz, vagy telepítsen egyedi modelleket videócímkézéshez, dokumentum-összefoglaláshoz és orvosi elemzéshez. Élvezze a GPU-gyorsítást és a teljesen flash alapú tárolást.

Vállalati szintű Edge AI és nagy teljesítményű számítástechnika
QAI-h1290FX több, mint egy tárolórendszer — egy számításra kész, vállalati szintű edge számítástechnikai platform. Nagy teljesítményű számítási architektúrára épül, támogatja a konfigurálható NVIDIA® RTX™ Pro Blackwell GPU-kat, így kiválóan alkalmas nagy nyelvi modellek (LLM) következtetésére, képgenerálásra, RAG keresésre és számos számításigényes, virtualizált munkafolyamatra.
Legyen szó AI következtetésről, kutatás-fejlesztésről, adatelemzésről vagy olyan vállalati alkalmazásokról, amelyek magas magszámot és tartós teljesítményt igényelnek, egyetlen asztali vállalati platform is kiemelkedő számítási hatékonyságot és teljesen helyben történő adatbiztonságot nyújt.
Maximális AI számítási teljesítmény (opcionális GPU konfiguráció)

GPU-kész architektúra — NVIDIA® RTX™ Pro Blackwell támogatással
A QAI-h1290FX egy GPU-kész architektúrával rendelkezik, amelyet az NVIDIA® RTX™ Pro Blackwell GPU-k támogatására terveztek. A Blackwell architektúrára épül, és támogatja az olyan gyorsítási technológiákat, mint a CUDA, a TensorRT és a Transformer Engine, így kiválóan alkalmas a modern AI és GPU-gyorsított számítási feladatokra.
A nagy nyelvi modellek (LLM) következtetéseitől és a számítógépes látástól a generatív AI-ig és más GPU-gyorsított professzionális alkalmazásokig a munkaterhelések teljes egészében helyben futtathatók—magas teljesítményt nyújtva, miközben biztosítva marad az adatok védelme és a teljes rendszerkontroll. A platform CPU-központú nagy teljesítményű számítógépes rendszerként is működhet, virtualizációt és széles körű vállalati számítási forgatókönyveket támogatva.
-
 Zászlóshajó
NVIDIA® RTX™ Pro 6000 Blackwell Max-Q munkaállomás
- 96 GB GDDR7 ECC memória
- 24 064 CUDA mag, 752 Tensor mag, 188 RT mag
- 125 TFLOPS (FP32), akár 4000 AI TOPS
- 1 792 GB/s memória-sávszélesség
- 300 W fogyasztás
- PCIe 5.0 x16 interfész
-
 Teljesítmény
NVIDIA® RTX™ Pro 4500 Blackwell
- 32 GB GDDR7 ECC memória
- 10 496 CUDA mag, 328 Tensor mag, 82 RT mag
- 54,94 TFLOPS (FP32)
- 896 GB/s memória sávszélesség
- 200W energiafogyasztás
- PCIe 5.0 x16 interfész
NVIDIA® RTX™ Pro Blackwell sorozat — Az AI és a nagy teljesítményű számítási munkafolyamatok újradefiniálása
Az NVIDIA® RTX™ Pro Blackwell sorozatú GPU-kat kifejezetten nagy intenzitású AI, számítási és kreatív munkafolyamatokra tervezték, ötvözve a következő generációs Blackwell architektúrát az ultragyors GDDR7 ECC memóriával. Ez olyan számítási teljesítményt és VRAM kapacitást biztosít egyetlen professzionális GPU-n, amelyhez korábban több fogyasztói grafikus kártya volt szükséges.
Akár 96 GB VRAM támogatásával és továbbfejlesztett AI gyorsítási képességekkel az RTX™ Pro Blackwell sorozat ideális fejlett LLM-ekhez, generatív modellekhez, adatelemzéshez, valamint összetett 3D vizualizációs és professzionális számítási munkafolyamatokhoz.

Szerverosztályú AMD EPYC™ processzorok hajtják a nagy teljesítményű számításokhoz
QAI-h1290FX szerverosztályú AMD EPYC processzor platformra épül, amely magas magszámot és hatalmas többszálú teljesítményt nyújt.
Hosszú távú, stabil működésre tervezték erősen párhuzamos munkaterhelések alatt, így ideális virtualizációhoz, többszálú számításhoz, adatfeldolgozáshoz és edge computing szcenáriókhoz—miközben támogatja az AI következtetést és a számításigényes alkalmazások széles körét is.

QuTS hero operációs rendszer
A vállalatoknak tervezett QuTS hero operációs rendszer a rendkívül megbízható ZFS-fájlrendszert alkalmazza, hogy a lehető legnagyobb adatintegritást és stabilitást biztosítsa a kritikus fontosságú tároláshoz. A QuTS hero tovább optimalizálja az SSD teljesítményét és tartósságát, hogy megfeleljen a vállalkozások szigorú teljesítmény- és megbízhatósági igényeinek. Fedezd fel a QuTS hero operációs rendszert! Nézd meg a QuTS hero legújabb funkcióit!
Távoli hozzáférés a helyszíni AI-hoz – bármikor, bárhonnan
Hozzon létre zökkenőmentes hibrid munkakörnyezetet a QNAP által kínált többféle távoli elérési lehetőséggel. Legyen szó AI alkalmazások kezeléséről vagy fájlok eléréséről, a QAI-h1290FX biztosítja a folyamatos kapcsolatot – a biztonság veszélyeztetése nélkül.
Közvetlen vagy átirányított elérési lehetőségek
- myQNAPcloud DDNS:
A QuTS hero felület elérése bárhonnan egyedi domainen keresztül, IP-címek megjegyzése nélkül. - myQNAPcloud Link:
Biztonságos átirányított kapcsolatot hoz létre a QNAP szerverein keresztül – nincs szükség a router portjainak megnyitására vagy a tűzfal beállításainak módosítására. - VPN szerver támogatás:
Állítson be privát VPN-t a QVPN Service segítségével, amely biztonságos, titkosított alagutakat biztosít a teljes hálózati hozzáféréshez.
Akár az LLM konténer beállításait finomhangolja, akár következtetési naplókat tekint át, vagy több helyszínen működik együtt, a QAI-h1290FX megbízható hozzáférést kínál a helyszíni AI környezethez bármilyen eszközről, bármikor.

Egy erőteljesebb Container Station: Új élmény az AI alkalmazások telepítésében
Az AI gyakorlati alkalmazásának elősegítése érdekében a QAI sorozat integrálja a Container Station-t egy széles körű AI alkalmazás sablon választékkal. Ezek a sablonok lehetővé teszik a népszerű AI eszközök és keretrendszerek egykattintásos telepítését, a QNAP rendszeres frissítéseivel, hogy mindig a legújabb technológiákhoz férhessen hozzá.
Akár most ismerkedik az AI-jal, akár a munkafolyamatokat szeretné helyben futtatni, a QAI egyszerűvé teszi az AI felfedezését, a költségek csökkentését, az adatok biztonságának növelését, sőt, akár egyedi AI eszközök fejlesztését is az üzleti innováció elősegítésére.

Konténerizált AI telepítés egyszerűen
Fejlessze AI infrastruktúráját zökkenőmentes konténer integrációval. Fedezze fel a Container Station
AI-központú konténer környezet
A QAI-h1290FX tartalmazza a Container Station-t, amely lehetővé teszi Docker és LXD konténerek telepítését. Mivel a legtöbb AI eszköz ma már konténerizált alkalmazásként érhető el, a QAI-h1290FX közvetlen és hatékony módot kínál olyan modellek telepítésére, mint az LLM, RAG Search, képgenerálás (pl. Stable Diffusion), vagy tudásbázis motorok, mint az AnythingLLM – mindezt bonyolult beállítás nélkül.

Tartós adattárolás AI modellekhez
A Docker Volume támogatásnak köszönhetően a QAI-h1290FX lehetővé teszi, hogy a konténerek a NAS megosztott mappáit csatolják, így az adatok a konténer újraépítése után is megmaradnak. Ez különösen előnyös nagy modellfájlokat, tanító adatokat vagy naplókat tartalmazó AI munkafolyamatok esetén. Többé nem kell aggódnia a fontos adatok elvesztése miatt frissítések vagy verzióváltás során.

Tegye egyszerűvé és mindenki számára elérhetővé a GPU-gyorsítást minden AI munkafolyamathoz
A QAI-h1290FX leegyszerűsíti a GPU-erőforrások Docker környezetben történő konfigurálásának bonyolultságát. A Container Station intuitív felületén új konténer létrehozásakor egyszerűen válassza ki a kívánt NVIDIA® GPU-t a legördülő menüből, és a konténer azonnal hozzáférést kap a GPU számítási képességeihez. Legyen szó LLM-ek telepítéséről, képgenerálásról vagy mélytanulási következtetés futtatásáról, a QAI-h1290FX zökkenőmentessé és hatékonnyá teszi a folyamatot.

Az alkotás újradefiniálása mesterséges intelligenciával támogatott vizuális tervezéssel
A ComfyUI hatékony, moduláris felületet biztosít művészek, tervezők és tartalomkészítők számára AI-alapú kép- és videókészítéshez. Intuitív, csomópont-alapú kialakításával és fejlett modellek, például a Stable Diffusion támogatásával a felhasználók könnyedén generálhatnak, alakíthatnak és animálhatnak vizuális tartalmakat. A GPU-gyorsítással és rugalmas munkafolyamatokkal kombinálva a ComfyUI csökkenti az összetett vizuális tervezés belépési küszöbét – példátlan kreatív szabadságot nyitva meg.
Valós AI teljesítmény – mérve a QAI-h1290FX rendszeren
Az AI telepítési teljesítményét valós benchmark adatok igazolják. Egy csúcskategóriás GPU tesztkonfigurációban a QAI-h1290FX teljes körűen ki lett értékelve az NVIDIA® RTX™ PRO 6000 Blackwell Max-Q Workstation GPU-val, igazolva teljesítményét helyszíni AI következtetés és vállalati telepítési forgatókönyvekben.
Ollama LLM következtetési benchmark (gyors telepítés)
A Blackwell architektúra GPU-gyorsítási képességeit kihasználva a QAI-h1290FX számos nagy nyelvi modellt képes helyben futtatni az Ollama segítségével.
Az Ollama gyors telepítést és egyszerűsített menedzsmentet tesz lehetővé, így ideális PoC projektekhez, egyfelhasználós környezetekhez, valamint kis- és közepes méretű felhasználási esetekhez, például RAG-alapú kereséshez, AI asszisztensekhez és offline következtetéshez.
vLLM párhuzamos következtetési benchmark (vállalati szintű áteresztőképesség)
A többfelhasználós és nagy egyidejűséget igénylő AI szolgáltatásokhoz a QAI-h1290FX támogatja a vLLM következtetési motorral való telepítést is.
Az egykéréses következtetési megközelítésekkel szemben a vLLM jelentősen javítja a GPU kihasználtságát és az össz-áteresztőképességet a Paged Attention és a hatékony ütemezési mechanizmusok révén. Ez különösen alkalmassá teszi vállalati AI szolgáltatásokhoz, többfelhasználós RAG rendszerekhez és API-alapú AI alkalmazásokhoz.
Azonos GPU konfiguráció mellett a vLLM egyidejű kérések esetén egyenletesebb késleltetési jellemzőket és magasabb token/másodperc áteresztőképességet mutat, így ideális termelési környezetekhez és hosszú távú vállalati AI bevetésekhez.
Tesztelt nagy nyelvi modell: deepseek-ai/DeepSeek-R1-Distill-Qwen-7B (Hugging Face)
Tesztelt nagy nyelvi modell: openai/gpt-oss-20b (Hugging Face)
Szabadítsa fel az AI lehetőségeit gyakorlati felhasználási esetekkel
A dokumentumautomatizálástól a kreatív munkafolyamatokon és rendszer-szintű automatizáción át a QAI-h1290FX minden részleg számára lehetővé teszi, hogy az AI-t értelmes, mérhető módon alkalmazzák – biztonságosan, saját infrastruktúráján tárolva.
Nincs felhőhöz kötöttség, nincs bonyolult beállítás – csak valódi eredmények helyi LLM-ekkel, biztonságos konténerekkel és integrált QNAP funkciókkal.
Intelligens HR asszisztens – Belső szabályzat chatbot
Építsen belső kérdezz-felelek asszisztenst az AnythingLLM + Ollama segítségével. Töltsön fel HR dokumentumokat, például munkavállalói kézikönyveket, szabadságpolitikákat és juttatásokat a QAI-h1290FX-ba. Az alkalmazottak természetes kérdéseket tehetnek fel, például:
„Hogyan igényelhetek családi gondozási szabadságot?”
A rendszer helyi RAG keresést végez és azonnal válaszol, csökkentve a HR terhelését és javítva a válaszidőt.

Kreatív csapat AI stúdió – Képgeneráló központ
A tervezőcsapatok a Stable Diffusion-t és a ComfyUI-t használják, amelyeket a QAI-h1290FX-ra telepítettek, hogy promóciós képeket, mockupokat vagy stilizált műalkotásokat generáljanak prompt megadásával.
A GPU-gyorsításnak és a tartós NAS tárhelynek köszönhetően a tervezők gyors és reprodukálható eredményeket kapnak – nincs többé nulláról indulás.

AI társfejlesztő fejlesztőknek – Dokumentáció, kód és összefoglalók
A mérnöki csapatok Qwen vagy Llama típusú LLM-eket futtatnak Ollama-ban a QAI-h1290FX-on, hogy segítsék a specifikációírást, kódellenőrzést és technikai fordításokat.
Tölts fel API dokumentációkat vagy tanulmányokat, majd beszélgess a modellel tisztázás, összefoglalás vagy akár markdown formázás céljából – teljesen offline és biztonságosan.

n8n + NAS automatizálás – Indíts AI-t bárhonnan
Az n8n telepítésével a QAI-h1290FX-ra automatizálhatod azokat a feladatokat, amelyek az AI-t üzleti folyamatokkal integrálják. Például:

AI Docker alkalmazások a QAI-h1290FX-on
Futtass erőteljes AI megoldásokat a Container Station és GPU integrációval.

Alakítsa NAS-át AI-alapú tudásközponttá
Tegye lehetővé a vállalati felhasználók számára, hogy gyorsabban keressenek, értsenek és találjanak információkat, mint valaha – a Qsirch és a következő generációs RAG Search erejével. A QAI-h1290FX intelligenciát ad a dokumentumaihoz, miközben mindent biztonságban és helyben tart.

Qsirch – Intelligens teljes szöveges keresés
A Qsirch villámgyors teljes szöveges keresést kínál minden NAS fájlja között – PDF-ek, Office dokumentumok, e-mailek és még sok más. Fejlett szűrőkkel, indexeléssel és előnézeti funkciókkal a felhasználók azonnal megtalálhatják a releváns dokumentumokat terabájtnyi adat között. Tudjon meg többet

RAG Search – AI-alapú kontextuális válaszok
A RAG (Retrieval-Augmented Generation) Search tovább lép: ötvözi a Qsirch-et egy helyi Nagy Nyelvi Modellel (LLM). Amikor a felhasználók kérdést tesznek fel, a rendszer először a Qsirch segítségével keres releváns fájlokat, majd a helyi AI-val pontos, természetes nyelvű választ generál. Tudjon meg többet
A QAI-h1290FX rendszeren a RAG Search teljesen helyben fut:
5 év garancia alapszolgáltatásként
A QAI-h1290FX 5 év garanciával érkezik plusz költségek nélkül – nagyobb nyugalmat biztosítva üzleti szervezetednek.

Edge AI Storage Server összehasonlítás:
QAI-h1290FX vs. Egyéb AI NAS vs. AI munkaállomás
Segítségre van szükséged?
Vedd fel velünk a kapcsolatot, hogy további termékekkel vagy megoldásokkal kapcsolatos ajánlást kapj az igényeidnek és követelményeidnek megfelelően!
Opcionális kiegészítők
-

QM2-2P-244A
Dual M.2 22110/2280 PCIe SSD expansion card;
Dimension (L × W × H): 170.5 × 20.6 × 68.9 (mm)
Weight: 0.29 (kg)
Please check the M.2 SSD compatibility list and QM2 Installation Guide
-

QM2-2P-344A
Dual M.2 PCIe SSD expansion card; M.2 2280/22110 PCIe NVMe(Gen 3x4) SSDs; PCIe Gen3x4 host interface
Dimension (L × W × H): 170.5 × 19.3 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P-384A
Dual M.2 PCIe SSD expansion card; M.2 2280/22110 PCIe NVMe(Gen 3x4) SSDs; PCIe Gen3x8 host interface
Dimension (L × W × H): 170.5 × 19.3 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P10G1TB
QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen3 x 8 , 1 x Marvell AQC113C 10GbE NBASE-T port
Dimension (L × W × H): 152.65 × 18.9 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P2G2T
QNAP QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen3 x 4 , 2 x Intel I225LM 2.5GbE NBASE-T port
Dimension (L × W × H): 152.65 × 20.6 × 68.9 (mm)
Weight: 0.29 (kg)
-

QM2-2P410G1T (EOL)
QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen4 x 4 , 1 x AQC113C 10GbE NBASE-T port
Dimension (L × W × H): 187 × 19.35 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P410G2T (EOL)
QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen4 x 4 , 2 x AQC113C 10GbE NBASE-T port
Dimension (L × W × H): 187 × 19.35 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2S-220A
Dual M.2 22110/2280 SATA SSD expansion card;
Dimension (L × W × H): 147.15 × 20.6 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-4P-384
Quad M.2 PCIe SSD expansion card; supports up to four M.2 2280 formfactor M.2 PCIe (Gen3 x4) SSDs; PCIe Gen3 x8 host interface; Low-profile bracket pre-loaded, Low-profile flat and Full-height are bundled
Dimension (L × W × H): 204.95 × 68.9 × 20.6 (mm)
Weight: 0.32 (kg)
-

QM2-4S-240 (EOL)
Quad M.2 2280 SATA SSD expansion card
Dimension (L × W × H): 204.95 × 68.9 × 20.6 (mm)
Weight: 0.32 (kg)
-
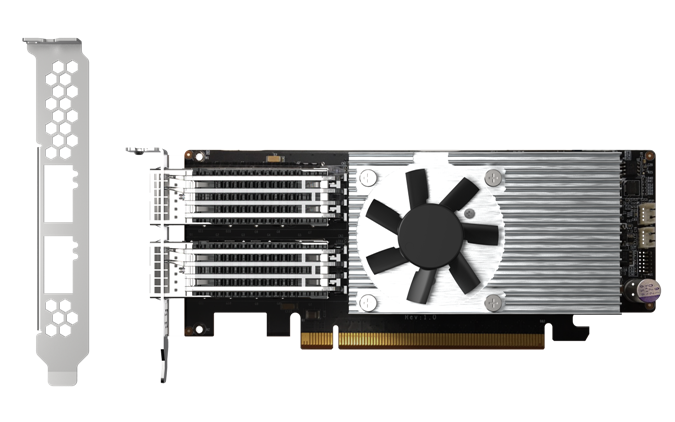
QXG-100G2SF-E810
Dual port 100GbE Network adapter; 2 x QSFP28; Intel E810 Ethernet controller
Dimension (L × W × H): 169.6 × 69 × 18.7 (mm)
Weight: 0.36 (kg)
-

QXG-10G1T
Single-port (10Gbase-T) 10GbE network expansion card, PCIe Gen3 x4, Low-profile bracket pre-loaded, Low-profile flat and Full-height are bundled
Dimension (L × W × H): 143 × 193 × 52 (mm)
Weight: 0.53 (kg)
-

QXG-10G2SF-X710
Dual-port SFP+ 10Gb network expansion card; low-profile formfactor; PCIe Gen3 x8
Dimension (L × W × H): 26 × 10.5 × 6 (mm)
Weight: 0.29 (kg)
-

QXG-10G2T
Dual-port 10GBASE-T 10Gb network expansion card; low-profile formfactor; PCIe Gen3 x4
Dimension (L × W × H): 54.5 × 39.5 × 18 (mm)
Weight: 0.24 (kg)
-

QXG-10G2T-X710
Dual-port 10GbE Network Adaptor, Intel 700 series Ethernet Controller
Dimension (L × W × H): 113.6 × 68.9 × 18.3 (mm)
Weight: 0.24 (kg)
-

QXG-10G2TB (EOL)
Dual-port 10GbE Network Adaptor, Aquantia AQC113C
Dimension (L × W × H): 104.7 × 16.1 × 68.9 (mm)
Weight: 0.28 (kg)
-

QXG-25G2SF-CX6
Dual-port SFP28 25Gb network expansion card; Mellanox ConnectX-6 Lx;low-profile formfactor; PCIe Gen4 x8
Dimension (L × W × H): 120 × 16.5 × 69 (mm)
Weight: 0.15 (kg)
-
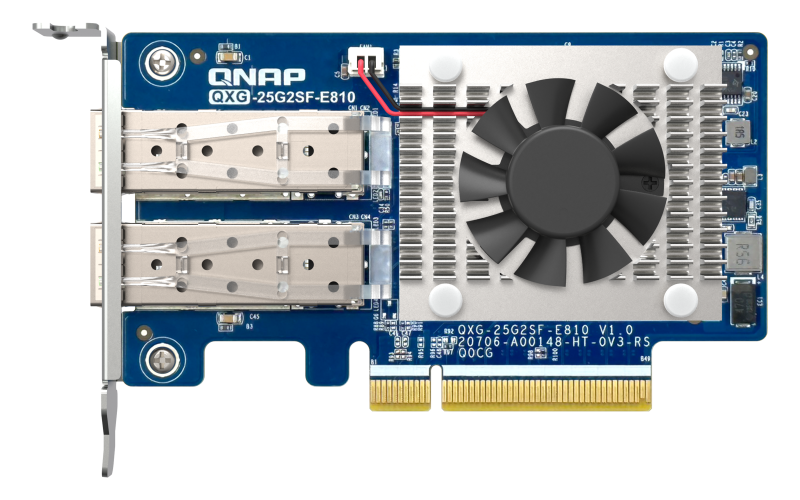
QXG-25G2SF-E810
2 port 25GbE(Intel E810-XXVAM2) Network Interface Cards (NIC)
Dimension (L × W × H): 119.3 × 68.9 × 18.1 (mm)
Weight: 0.23 (kg)
-

QXG-2G1T-I225
Single port 2.5GbE 4-speed Network card
Dimension (L × W × H): 67.3 × 68.9 × 25.2 (mm)
Weight: 0.19 (kg)
-

QXG-2G2T-I225
Dual port 2.5GbE 4-speed Network card
Dimension (L × W × H): 81.3 × 68.9 × 25.2 (mm)
Weight: 0.23 (kg)
-

QXG-2G4T-I225
Quad port 2.5GbE 4-speed Network card
Dimension (L × W × H): 104.6 × 68.9 × 24.1 (mm)
Weight: 0.24 (kg)
-

QXG-5G1T-111C
QNAP 5GbE multi-Gig expansion card;Aquantia AQC111C;Gen2 x 1;low profile
Dimension (L × W × H): 145 × 190 × 52 (mm)
Weight: 0.20 (kg)
-

QXG-5G2T-111C (EOL)
QNAP dual port 5GbE multi-Gig expansion card;Aquantia AQC111C;Gen2 x 2;low profile
Dimension (L × W × H): 145 × 190 × 52 (mm)
Weight: 0.20 (kg)
-
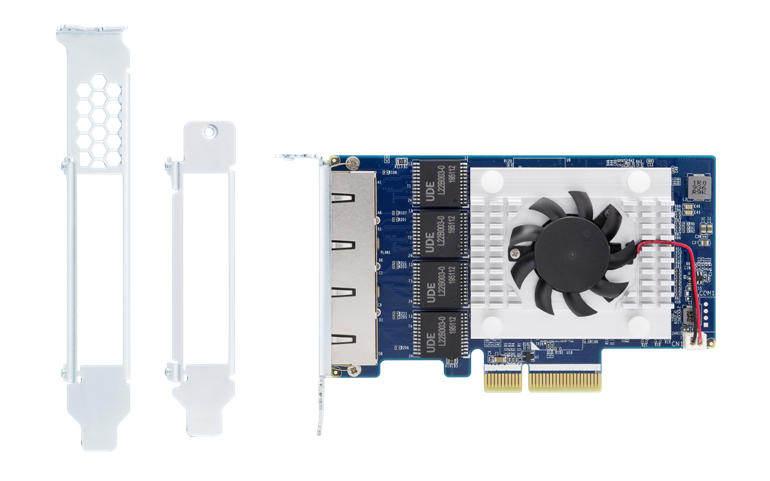
QXG-5G4T-111C (EOL)
QNAP Quad port 5GbE multi-Gig expansion card;Aquantia AQC111C;Gen2 x 4;low profile
Dimension (L × W × H): 145 × 190 × 52 (mm)
Weight: 0.23 (kg)
-

QXP-16G2FC
QNAP 2-port 16Gbps fiber channel adapter, PCIe 3.0 x8, SFP+, low profile, w/ SFP+ 16G transceivers
Dimension (L × W × H): 190 × 143 × 50 (mm)
Weight: 0.28 (kg)
-

QXP-32G2FC
QNAP 2-port 32Gbps fiber channel adapter, PCIe 3.0 x8, SFP+, low profile, w/ SFP+ 32G optical transceivers
Dimension (L × W × H): 190 × 143 × 50 (mm)
Weight: 0.28 (kg)
-
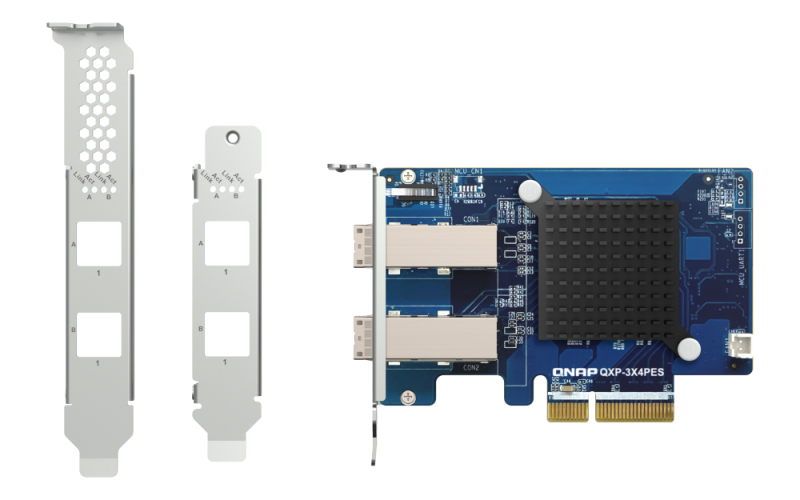
QXP-3X4PES
2 ports (SFF-8644) Expansion card; PCIe Gen3 x4 for QNAP PCIe JBOD series
Dimension (L × W × H): 102.65 × 68.9 × 19 (mm)
Weight: 0.11 (kg)
-
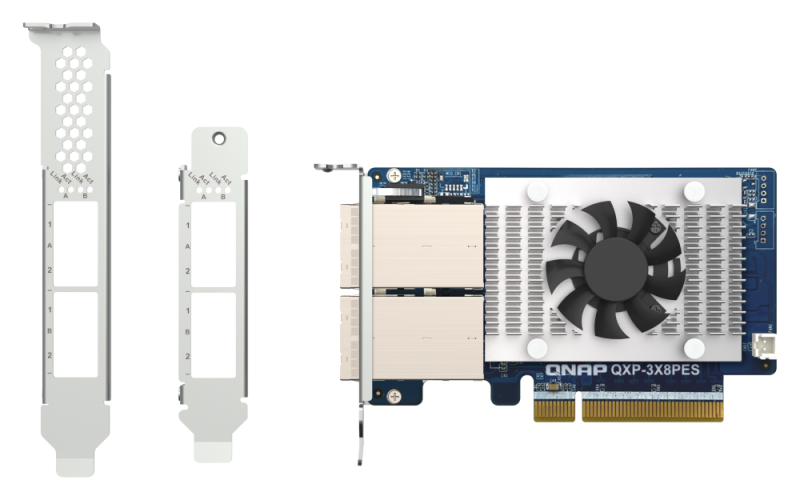
QXP-3X8PES
2 ports (SFF-8644 1x2) Expansion card; PCIe Gen3 x8 for QNAP PCIe JBOD series
Dimension (L × W × H): 112.65 × 68.9 × 18.26 (mm)
Weight: 0.17 (kg)
-
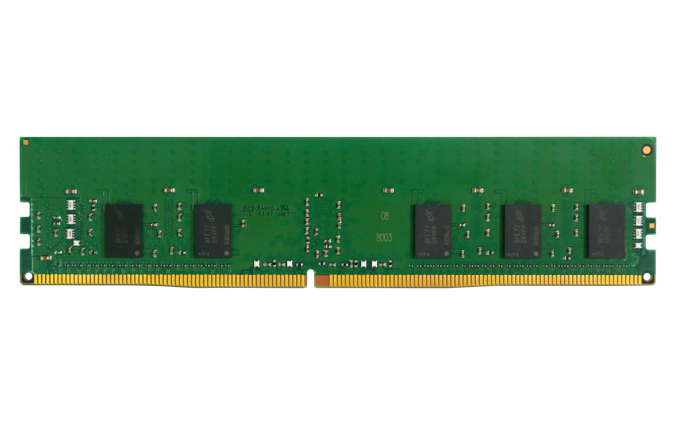
RAM-16GDR4ECT0-RD-3200
DDR type: DDR4(288PIN)
Capacity: 16GB
Spec: 1G X 8
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 2048M*72
Temperature: 0℃~85℃
Environmental Regulation: Halogen Free
-
RAM-32GDR4ECT0-RD-3200 (EOL)
DDR type: DDR4(288PIN)
Capacity: 32GB
Spec: 2G X 8
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 4G*72
Temperature: 0℃~85℃
Environmental Regulation: Halogen Free
-

RAM-32GDR4K0-RD-3200
32GB DDR4 RAM, 3200 MHz, RDIMM
-
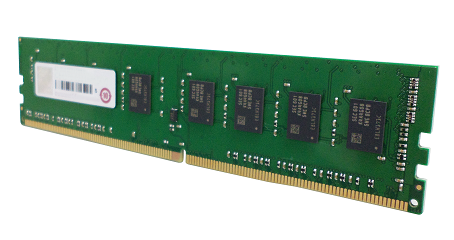
RAM-64GDR4ECK0-RD-3200 (EOL)
DDR type: DDR4(288PIN)
Capacity: 64GB
Spec: 4G X 4
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 8G*72
Temperature: 0℃~85℃
Environmental Regulation: RoHS
-
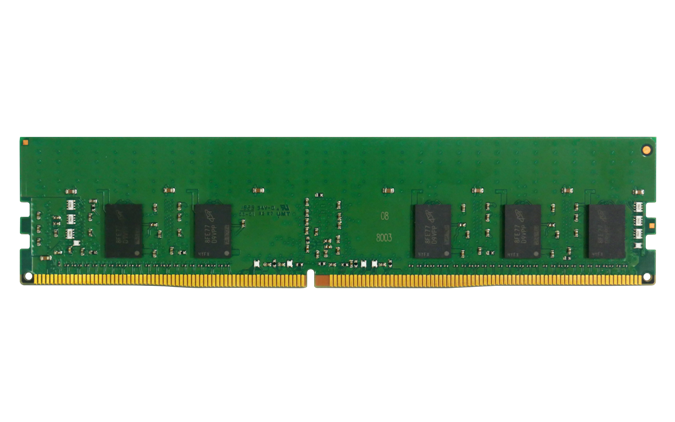
RAM-8GDR4ECT0-RD-3200
DDR type: DDR4(288PIN)
Capacity: 8GB
Spec: 1G X 8
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 1024M*72
Temperature: 0℃~85℃
Environmental Regulation: Halogen Free
-

CAB-PWR20M-C1314
Power Cord, 2M, C13-C14, 250V, 10A, IEC
Dimension (L × W × H): 180 × 29 × 21 (mm)
Weight: 0.19 (kg)


