


QAI-h1290FX
Un server edge AI Archiviazione pronto per GPU che supporta GPU NVIDIA®, U.2 NVMe SSD e connettività 25GbE—progettato per AI on-premises, Virtualizzazione e workload ad alta intensità di calcolo.
QAI-h1290FX è un server edge di classe desktop per il calcolo e la convergenza Archiviazione che combina un'architettura di calcolo ad alte prestazioni con Archiviazione ultra-veloce. Supporta GPU NVIDIA® RTX™ PRO Blackwell configurabili, rendendolo ideale per AI on-premises, inferenza LLM, ricerca RAG privata, Virtualizzazione e altri workload di calcolo impegnativi.
Basato su QuTS hero con file system ZFS, la piattaforma offre integrità dati di livello enterprise e prestazioni costanti. Che si tratti di implementazione AI, ricerca e sviluppo, calcolo ad alte prestazioni o ambienti Virtualizzazione aziendali, QAI-h1290FX consente una configurazione flessibile e un'implementazione rapida, garantendo che i workload critici vengano eseguiti in modo sicuro ed efficiente all'edge.


Architettura pronta per GPU con supporto RTX PRO Blackwell
Progettato con un design pronto per GPU, supporta GPU NVIDIA® RTX™ PRO Blackwell, inclusa l'opzione RTX PRO 6000 Blackwell Max-Q Workstation, per soddisfare le esigenze di workload AI, generazione di immagini, inferenza e calcolo accelerato da GPU.
Architettura NVMe All-Flash Archiviazione ad alta velocità
Dotato di 12 alloggiamenti U.2 NVMe SSD e supporto per SSD SATA, consente configurazioni Archiviazione flessibili ottimizzate per prestazioni, capacità o costo. Ideale per workload AI, Virtualizzazione e elaborazione dati in tempo reale.
LLM & Ricerca RAG On-Premises
Consente l'implementazione locale di LLM privati e ricerca basata su RAG, offrendo un recupero sicuro di documenti semantici senza inviare dati sensibili al cloud.
Sistema operativo QuTS hero basato su ZFS
Basato su QuTS hero con ZFS, offre compressione inline, auto-riparazione, snapshot e SnapSync per garantire l'integrità dati di livello enterprise.
Accelerazione GPU e template app AI
Sfrutta l'accelerazione GPU tramite Container Station. Distribuzione con un clic di Ollama, AnythingLLM, Stable Diffusion, ecc. Semplifica il rollout delle applicazioni AI.
Connettività 25GbE e pronto per l'espansione
2 porte integrate 25GbE e 2.5GbE, aggiornabili fino a 100GbE. Espandi con QNAP JBODs per soddisfare le crescenti esigenze di dati Archiviazione AI.


Sistema operativo QuTS hero
Premiato con il 2026 MSP Today Product of the Year Award

QNAP QAI-h1290FX
Vincitore del TechRadar Pro Picks Awards per il CES 2026
Applicazioni ideali QAI
-
Chatbot interno & Knowledge Base
Distribuisci bot privati simili a ChatGPT utilizzando AnythingLLM o OpenWebUI. Collegati in modo sicuro ai documenti interni per Q&A dei dipendenti, ricerca di policy e supporto alla formazione—senza necessità di internet.

-
Motore di ricerca RAG privato
Esegui Retrieval-Augmented Generation (RAG) localmente con pieno controllo su dati. Abilita la ricerca documentale in linguaggio naturale su contratti, report e archivi—ideale per team legali, finanziari ed enterprise.

-
Inferenza AI & Generazione di contenuti
Usa Stable Diffusion o ComfyUI per la generazione di immagini, oppure distribuisci modelli personalizzati per il tagging video, la sintesi di documenti e l’analisi medica. Approfitta dell’accelerazione GPU e dello storage all-flash Archiviazione.

Edge AI di livello enterprise e High-Performance Computing
QAI-h1290FX è più di un sistema Archiviazione — è una piattaforma edge computing di livello enterprise pronta per il calcolo. Basata su un’architettura di calcolo ad alte prestazioni, supporta GPU NVIDIA® RTX™ Pro Blackwell configurabili, rendendola ideale per inferenza di modelli linguistici di grandi dimensioni (LLM), generazione di immagini, ricerca RAG e una vasta gamma di carichi di lavoro intensivi e virtualizzati.
Che si tratti di inferenza AI, ricerca e sviluppo, analisi dati o applicazioni enterprise che richiedono un elevato numero di core e prestazioni costanti, una singola piattaforma enterprise desktop può offrire un’efficienza di calcolo eccezionale e dati Sicurezza completamente on-premises.
Massime prestazioni di calcolo AI (Configurazione GPU opzionale)

Architettura GPU-Ready — Supporto per NVIDIA® RTX™ Pro Blackwell
QAI-h1290FX presenta un'architettura GPU-ready progettata per supportare le GPU NVIDIA® RTX™ Pro Blackwell. Basata sull'architettura Blackwell, supporta tecnologie di accelerazione come CUDA, TensorRT e Transformer Engine, rendendola ideale per workload AI moderni e calcolo accelerato dalla GPU.
Dall'inferenza di modelli linguistici di grandi dimensioni (LLM) e visione artificiale all'AI generativa e altre applicazioni professionali accelerate dalla GPU, i workload possono essere distribuiti ed eseguiti interamente on-premises—offrendo prestazioni elevate mantenendo la privacy dati e il pieno controllo del sistema. La piattaforma può anche operare come sistema di calcolo ad alte prestazioni centrato sulla CPU, supportando Virtualizzazione e una vasta gamma di scenari di calcolo aziendali.
-
 Di punta
Workstation NVIDIA® RTX™ Pro 6000 Blackwell Max-Q
- 96 GB di memoria GDDR7 ECC
- 24.064 core CUDA, 752 core Tensor, 188 core RT
- 125 TFLOPS (FP32), fino a 4000 AI TOPS
- 1.792 GB/s di larghezza di banda della memoria
- Consumo energetico di 300W
- Interfaccia PCIe 5.0 x16
-
 Prestazioni
NVIDIA® RTX™ Pro 4500 Blackwell
- 32 GB di memoria GDDR7 ECC
- 10.496 core CUDA, 328 core Tensor, 82 core RT
- 54,94 TFLOPS (FP32)
- Larghezza di banda della memoria di 896 GB/s
- Consumo energetico di 200W
- Interfaccia PCIe 5.0 x16
Serie NVIDIA® RTX™ Pro Blackwell — Ridefinisce i workflow di AI e High-Performance Computing
Le GPU della serie NVIDIA® RTX™ Pro Blackwell sono progettate appositamente per carichi di lavoro AI, computazionali e creativi ad alta intensità, combinando l’architettura Blackwell di nuova generazione con memoria GDDR7 ECC ultra-veloce. Questo offre un livello di prestazioni di calcolo e capacità VRAM su una singola GPU professionale che in precedenza richiedeva più schede grafiche consumer.
Con supporto fino a 96GB di VRAM e capacità di accelerazione AI migliorate, la serie RTX™ Pro Blackwell è ideale per LLM avanzati, modelli generativi, dati analytics e workflow di visualizzazione 3D complessa e calcolo professionale.

Alimentato da processori AMD EPYC™ di classe server per calcolo ad alte prestazioni
QAI-h1290FX è basato su una piattaforma di processori AMD EPYC di classe server, offrendo un elevato numero di core e prestazioni multithread massicce.
Progettato per un funzionamento stabile e a lungo termine sotto carichi altamente paralleli, è ideale per Virtualizzazione, calcolo multithread, elaborazione dati e scenari di edge computing—supportando anche l’inferenza AI e una vasta gamma di applicazioni ad alta intensità di calcolo.

Sistema operativo QuTS hero
Progettato per le aziende, il sistema operativo QuTS hero adotta il filesystem ZFS ad alta affidabilità per garantire la massima integrità e stabilità dei dati per lo storage mission-critical. QuTS hero ottimizza ulteriormente le prestazioni e la durata dei dischi SSD per soddisfare i severi requisiti di prestazioni e affidabilità delle aziende. Esplora il sistema operativo QuTS hero Vedi le ultime funzioni di QuTS hero
Accesso remoto all’AI on-prem – sempre e ovunque
Crea un ambiente di lavoro ibrido senza interruzioni con le molteplici opzioni di accesso remoto offerte da QNAP. Che tu stia gestendo applicazioni AI o accedendo ai file, il QAI-h1290FX garantisce una connessione costante—senza compromettere Sicurezza.
Opzioni di accesso diretto o relay
- myQNAPcloud DDNS:
Accedi all’interfaccia QuTS hero da qualsiasi luogo tramite un dominio personalizzato, senza dover ricordare gli indirizzi IP. - myQNAPcloud Link:
Stabilisce una connessione relay sicura tramite i server QNAP—non è necessario aprire le porte Router o modificare le impostazioni del firewall. - Supporto Server VPN:
Configura una VPN privata utilizzando il servizio QVPN, abilitando tunnel criptati sicuri per l’accesso completo alla rete.
Che tu stia ottimizzando la configurazione del container LLM, esaminando i log di inferenza o collaborando tra sedi diverse, il QAI-h1290FX offre accesso affidabile al tuo ambiente AI on-prem da qualsiasi dispositivo, in qualsiasi momento.

Un Container Station più potente: una nuova esperienza nel deployment delle applicazioni AI
Per favorire l’adozione pratica dell’AI, la serie QAI integra Container Station con un’ampia selezione di template di applicazioni AI. Questi template supportano il deployment con un solo clic di strumenti e framework AI popolari, con aggiornamenti regolari da QNAP per garantire l’accesso alle tecnologie più recenti.
Che tu sia alle prime armi con l’AI o desideri spostare i workload on-premises, QAI rende facile esplorare l’AI, ridurre i costi, migliorare dati Sicurezza e persino sviluppare strumenti AI personalizzati per favorire l’innovazione aziendale.

Deployment AI containerizzato semplificato
Potenzia la tua infrastruttura AI con un’integrazione container senza soluzione di continuità. Esplora Container Station
Ambiente container centrato sull’AI
Il QAI-h1290FX è dotato di Container Station, consentendo il deployment di container Docker e LXD. Poiché la maggior parte degli strumenti AI oggi viene fornita come applicazioni containerizzate, QAI-h1290FX offre un modo diretto ed efficiente per distribuire modelli come LLM, RAG Search, generazione di immagini (ad esempio Stable Diffusion) o motori di knowledge base come AnythingLLM—tutto senza configurazioni complesse.

Persistenza di dati Archiviazione per i modelli AI
Con il supporto di volume Docker, il QAI-h1290FX consente ai container di montare cartelle condivise dal NAS, garantendo la persistenza di Archiviazione anche dopo la ricostruzione dei container. Questo è particolarmente utile per workload AI che coinvolgono file di modello di grandi dimensioni, training di dati o log. Non dovrai più preoccuparti di perdere dati chiave durante aggiornamenti o cambi di versione.

Rendi l’accelerazione GPU semplice e accessibile per tutti i workload AI
Il QAI-h1290FX elimina la complessità della configurazione delle risorse GPU negli ambienti Docker. Grazie all’interfaccia intuitiva di Container Station, quando si crea un nuovo container basta selezionare la GPU NVIDIA® desiderata dal menu a tendina e il container avrà immediatamente accesso alle capacità di calcolo GPU. Che tu stia distribuendo LLM, generando immagini o eseguendo inferenze di deep learning, il QAI-h1290FX garantisce un processo fluido ed efficiente.

Ridefinire la creatività con il design visivo potenziato dall’AI
ComfyUI offre ad artisti, designer e creatori di contenuti un’interfaccia potente e modulare per la creazione di immagini e video guidata dall’AI. Grazie al suo design intuitivo basato su nodi e al supporto per modelli avanzati come Stable Diffusion, gli utenti possono generare, trasformare e animare contenuti visivi con facilità. Combinando l’accelerazione GPU e flussi di lavoro flessibili, ComfyUI abbassa la barriera al design visivo complesso—liberando una libertà creativa senza precedenti.
Prestazioni AI reali – misurate su QAI-h1290FX
Le prestazioni di implementazione AI sono validate tramite benchmark reali dati. In una configurazione di test con GPU di fascia alta, QAI-h1290FX è stato completamente valutato con la GPU NVIDIA® RTX™ PRO 6000 Blackwell Max-Q Workstation, verificando le sue prestazioni nell'inferenza AI on-premises e negli scenari di implementazione aziendale.
Benchmark di inferenza Ollama LLM (Rapid Deployment)
Sfruttando le capacità di accelerazione GPU dell'architettura Blackwell, QAI-h1290FX può eseguire localmente una vasta gamma di modelli linguistici di grandi dimensioni tramite Ollama.
Ollama consente una distribuzione rapida e una gestione semplificata, rendendolo ideale per progetti proof-of-concept (PoC), ambienti a utente singolo e casi d'uso da piccoli a medi come ricerca basata su RAG, assistenti AI e inferenza offline.
Benchmark di inferenza concorrente vLLM (Throughput di livello enterprise)
Per soddisfare le esigenze di servizi AI multiutente e ad alta concorrenza, QAI-h1290FX supporta anche il deployment con il motore di inferenza vLLM.
Rispetto agli approcci di inferenza orientati alla singola richiesta, vLLM migliora significativamente l’utilizzo della GPU e il throughput complessivo grazie a Paged Attention e meccanismi di scheduling efficienti. Questo lo rende particolarmente adatto per servizi AI aziendali, sistemi RAG multiutente e applicazioni AI basate su API.
Con la stessa configurazione GPU, vLLM mostra caratteristiche di latenza più costanti e un throughput di token al secondo più elevato negli scenari di richieste concorrenti, rendendolo ideale per ambienti di produzione e deployment AI aziendali di lunga durata.
Modello linguistico di grandi dimensioni testato: deepseek-ai/DeepSeek-R1-Distill-Qwen-7B (Hugging Face)
Modello linguistico di grandi dimensioni testato: openai/gpt-oss-20b (Hugging Face)
Sblocca il potenziale dell'AI con casi d'uso pratici
Dall'automazione dei documenti ai flussi di lavoro creativi e all'automazione di sistema, il QAI-h1290FX consente a ogni reparto di applicare l'AI in modi significativi e misurabili—ospitato in modo sicuro sulla propria infrastruttura.
Nessun vincolo cloud, nessuna configurazione complessa—solo risultati concreti grazie a LLM locali, container sicuri e funzionalità QNAP integrate.
Assistente HR intelligente – Chatbot per policy interne
Crea un assistente Q&A interno usando AnythingLLM + Ollama. Carica documenti HR come manuali dei dipendenti, policy sui permessi e benefit nel QAI-h1290FX. I dipendenti possono porre domande naturali come:
«Come posso richiedere il congedo per assistenza familiare?»
Il sistema esegue una ricerca RAG locale e risponde istantaneamente, riducendo il carico di lavoro HR e migliorando i tempi di risposta.

Studio AI per team creativi – Hub di generazione immagini
I team di design utilizzano Stable Diffusion e ComfyUI distribuiti sul QAI-h1290FX per generare immagini promozionali, mockup o artwork stilizzati tramite input di prompt.
Grazie all'accelerazione GPU e alla persistenza di NAS Archiviazione, i designer ottengono risultati rapidi e riproducibili—niente più ripartenze da zero.

AI Co-Pilot per sviluppatori – Documenti, codice e riepiloghi
I team di ingegneria eseguono LLM come Qwen o Llama in Ollama sul QAI-h1290FX per supportare la scrittura di specifiche, la revisione del codice e le traduzioni tecniche.
Carica documentazione API o whitepaper, poi chatta con il modello per chiarimenti, riepiloghi o anche formattazione markdown—completamente offline e sicuro.

n8n + NAS Automazione – Attiva l'AI da qualsiasi luogo
Con n8n installato su QAI-h1290FX, puoi automatizzare attività che integrano l'AI con le operazioni aziendali. Ad esempio:

Applicazioni AI Docker su QAI-h1290FX
Esegui soluzioni AI potenti tramite Container Station e integrazione GPU.

Trasforma il tuo NAS in un hub di conoscenza potenziato dall’AI
Permetti agli utenti aziendali di cercare, comprendere e recuperare informazioni più rapidamente che mai—grazie a Qsirch e alla Ricerca RAG di nuova generazione. Il QAI-h1290FX porta intelligenza ai tuoi documenti mantenendo tutto sicuro e on-premises.

Qsirch – Ricerca full-text intelligente
Qsirch offre una ricerca full-text rapidissima su tutti i tuoi file NAS—PDF, documenti Office, email e altro. Con filtri avanzati, funzioni di indicizzazione e anteprima, gli utenti possono trovare documenti rilevanti istantaneamente su terabyte di dati. Scopri di più

Ricerca RAG – Risposte contestuali potenziate dall’AI
La Ricerca RAG (Retrieval-Augmented Generation) va oltre combinando Qsirch con un Large Language Model (LLM) locale. Quando gli utenti pongono una domanda, il sistema recupera prima i file rilevanti tramite Qsirch, poi genera una risposta accurata e naturale usando l’AI sul dispositivo. Scopri di più
Su QAI-h1290FX, la Ricerca RAG è completamente on-premises:
Garanzia standard di 5 anni
Il QAI-h1290FX è coperto da una garanzia di 5 anni senza costi aggiuntivi - per garantire alla tua azienda una maggiore tranquillità.

Confronto Server Edge AI Archiviazione:
QAI-h1290FX vs. altri NAS AI vs. AI Workstation
Hai bisogno di aiuto?
Contattaci subito per scoprire prodotti e soluzioni su misura, pensati per soddisfare al meglio le tue esigenze e richieste!
Accessori opzionali
-

QM2-2P-244A
Dual M.2 22110/2280 PCIe SSD expansion card;
Dimension (L × W × H): 170.5 × 20.6 × 68.9 (mm)
Weight: 0.29 (kg)
Please check the M.2 SSD compatibility list and QM2 Installation Guide
-

QM2-2P-344A
Dual M.2 PCIe SSD expansion card; M.2 2280/22110 PCIe NVMe(Gen 3x4) SSDs; PCIe Gen3x4 host interface
Dimension (L × W × H): 170.5 × 19.3 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P-384A
Dual M.2 PCIe SSD expansion card; M.2 2280/22110 PCIe NVMe(Gen 3x4) SSDs; PCIe Gen3x8 host interface
Dimension (L × W × H): 170.5 × 19.3 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P10G1TB
QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen3 x 8 , 1 x Marvell AQC113C 10GbE NBASE-T port
Dimension (L × W × H): 152.65 × 18.9 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P2G2T
QNAP QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen3 x 4 , 2 x Intel I225LM 2.5GbE NBASE-T port
Dimension (L × W × H): 152.65 × 20.6 × 68.9 (mm)
Weight: 0.29 (kg)
-

QM2-2P410G1T (EOL)
QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen4 x 4 , 1 x AQC113C 10GbE NBASE-T port
Dimension (L × W × H): 187 × 19.35 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P410G2T (EOL)
QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen4 x 4 , 2 x AQC113C 10GbE NBASE-T port
Dimension (L × W × H): 187 × 19.35 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2S-220A
Dual M.2 22110/2280 SATA SSD expansion card;
Dimension (L × W × H): 147.15 × 20.6 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-4P-384
Quad M.2 PCIe SSD expansion card; supports up to four M.2 2280 formfactor M.2 PCIe (Gen3 x4) SSDs; PCIe Gen3 x8 host interface; Low-profile bracket pre-loaded, Low-profile flat and Full-height are bundled
Dimension (L × W × H): 204.95 × 68.9 × 20.6 (mm)
Weight: 0.32 (kg)
-

QM2-4S-240 (EOL)
Quad M.2 2280 SATA SSD expansion card
Dimension (L × W × H): 204.95 × 68.9 × 20.6 (mm)
Weight: 0.32 (kg)
-
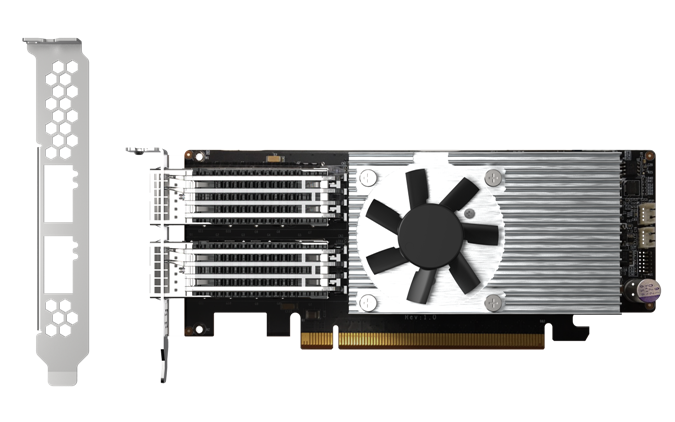
QXG-100G2SF-E810
Dual port 100GbE Network adapter; 2 x QSFP28; Intel E810 Ethernet controller
Dimension (L × W × H): 169.6 × 69 × 18.7 (mm)
Weight: 0.36 (kg)
-

QXG-10G1T
Single-port (10Gbase-T) 10GbE network expansion card, PCIe Gen3 x4, Low-profile bracket pre-loaded, Low-profile flat and Full-height are bundled
Dimension (L × W × H): 143 × 193 × 52 (mm)
Weight: 0.53 (kg)
-

QXG-10G2SF-X710
Dual-port SFP+ 10Gb network expansion card; low-profile formfactor; PCIe Gen3 x8
Dimension (L × W × H): 26 × 10.5 × 6 (mm)
Weight: 0.29 (kg)
-

QXG-10G2T
Dual-port 10GBASE-T 10Gb network expansion card; low-profile formfactor; PCIe Gen3 x4
Dimension (L × W × H): 54.5 × 39.5 × 18 (mm)
Weight: 0.24 (kg)
-

QXG-10G2T-X710
Dual-port 10GbE Network Adaptor, Intel 700 series Ethernet Controller
Dimension (L × W × H): 113.6 × 68.9 × 18.3 (mm)
Weight: 0.24 (kg)
-

QXG-10G2TB (EOL)
Dual-port 10GbE Network Adaptor, Aquantia AQC113C
Dimension (L × W × H): 104.7 × 16.1 × 68.9 (mm)
Weight: 0.28 (kg)
-

QXG-25G2SF-CX6
Dual-port SFP28 25Gb network expansion card; Mellanox ConnectX-6 Lx;low-profile formfactor; PCIe Gen4 x8
Dimension (L × W × H): 120 × 16.5 × 69 (mm)
Weight: 0.15 (kg)
-
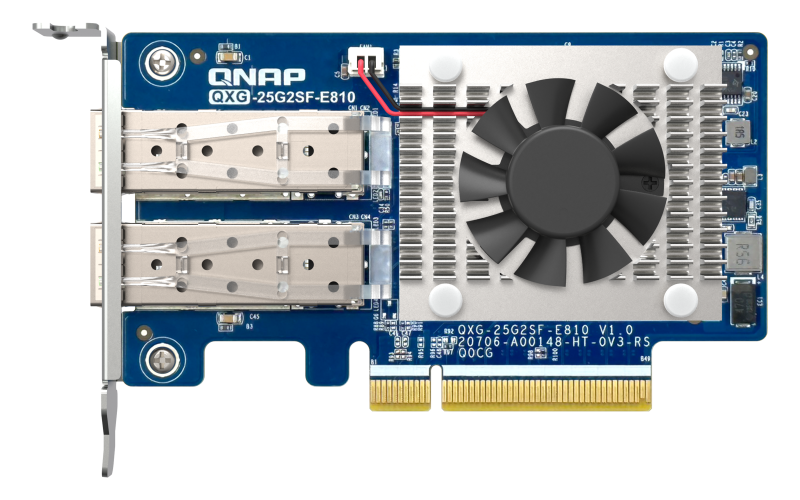
QXG-25G2SF-E810
2 port 25GbE(Intel E810-XXVAM2) Network Interface Cards (NIC)
Dimension (L × W × H): 119.3 × 68.9 × 18.1 (mm)
Weight: 0.23 (kg)
-

QXG-2G1T-I225
Single port 2.5GbE 4-speed Network card
Dimension (L × W × H): 67.3 × 68.9 × 25.2 (mm)
Weight: 0.19 (kg)
-

QXG-2G2T-I225
Dual port 2.5GbE 4-speed Network card
Dimension (L × W × H): 81.3 × 68.9 × 25.2 (mm)
Weight: 0.23 (kg)
-

QXG-2G4T-I225
Quad port 2.5GbE 4-speed Network card
Dimension (L × W × H): 104.6 × 68.9 × 24.1 (mm)
Weight: 0.24 (kg)
-

QXG-5G1T-111C
QNAP 5GbE multi-Gig expansion card;Aquantia AQC111C;Gen2 x 1;low profile
Dimension (L × W × H): 145 × 190 × 52 (mm)
Weight: 0.20 (kg)
-

QXG-5G2T-111C (EOL)
QNAP dual port 5GbE multi-Gig expansion card;Aquantia AQC111C;Gen2 x 2;low profile
Dimension (L × W × H): 145 × 190 × 52 (mm)
Weight: 0.20 (kg)
-
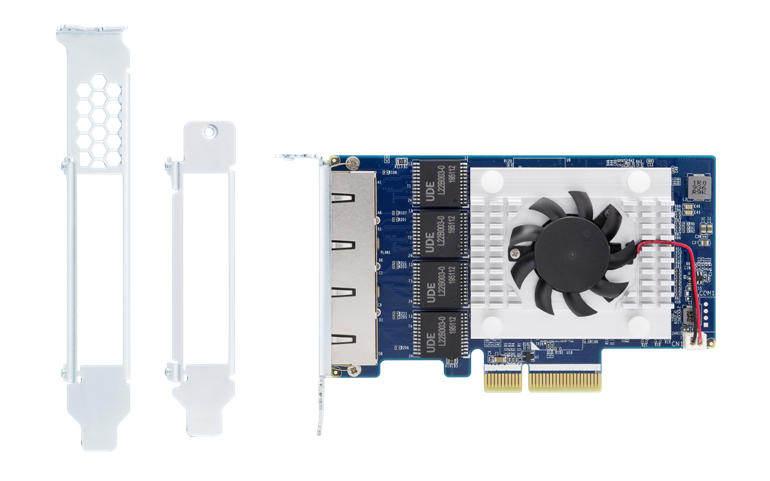
QXG-5G4T-111C (EOL)
QNAP Quad port 5GbE multi-Gig expansion card;Aquantia AQC111C;Gen2 x 4;low profile
Dimension (L × W × H): 145 × 190 × 52 (mm)
Weight: 0.23 (kg)
-

QXP-16G2FC
QNAP 2-port 16Gbps fiber channel adapter, PCIe 3.0 x8, SFP+, low profile, w/ SFP+ 16G transceivers
Dimension (L × W × H): 190 × 143 × 50 (mm)
Weight: 0.28 (kg)
-

QXP-32G2FC
QNAP 2-port 32Gbps fiber channel adapter, PCIe 3.0 x8, SFP+, low profile, w/ SFP+ 32G optical transceivers
Dimension (L × W × H): 190 × 143 × 50 (mm)
Weight: 0.28 (kg)
-
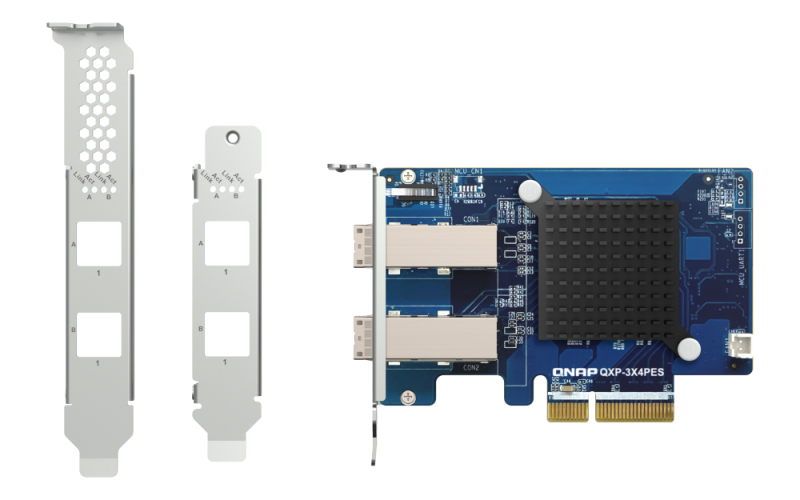
QXP-3X4PES
2 ports (SFF-8644) Expansion card; PCIe Gen3 x4 for QNAP PCIe JBOD series
Dimension (L × W × H): 102.65 × 68.9 × 19 (mm)
Weight: 0.11 (kg)
-
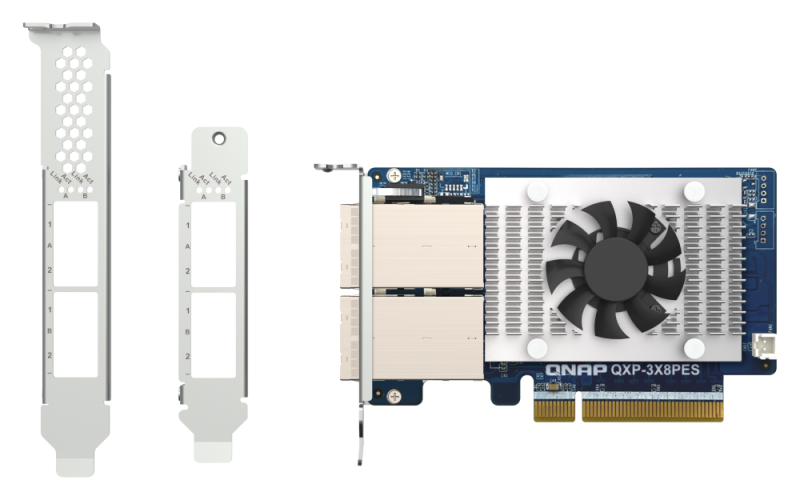
QXP-3X8PES
2 ports (SFF-8644 1x2) Expansion card; PCIe Gen3 x8 for QNAP PCIe JBOD series
Dimension (L × W × H): 112.65 × 68.9 × 18.26 (mm)
Weight: 0.17 (kg)
-
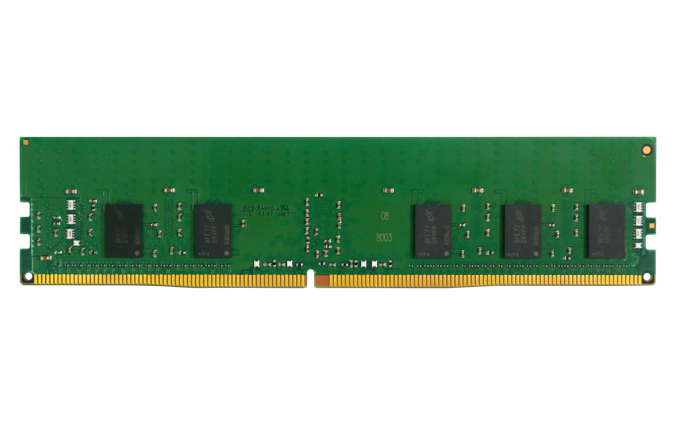
RAM-16GDR4ECT0-RD-3200
DDR type: DDR4(288PIN)
Capacity: 16GB
Spec: 1G X 8
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 2048M*72
Temperature: 0℃~85℃
Environmental Regulation: Halogen Free
-
RAM-32GDR4ECT0-RD-3200 (EOL)
DDR type: DDR4(288PIN)
Capacity: 32GB
Spec: 2G X 8
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 4G*72
Temperature: 0℃~85℃
Environmental Regulation: Halogen Free
-

RAM-32GDR4K0-RD-3200
32GB DDR4 RAM, 3200 MHz, RDIMM
-
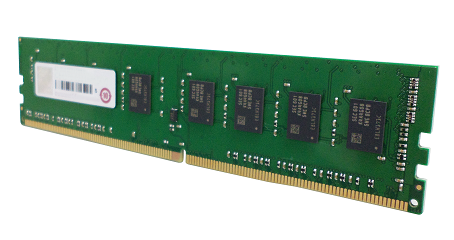
RAM-64GDR4ECK0-RD-3200 (EOL)
DDR type: DDR4(288PIN)
Capacity: 64GB
Spec: 4G X 4
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 8G*72
Temperature: 0℃~85℃
Environmental Regulation: RoHS
-
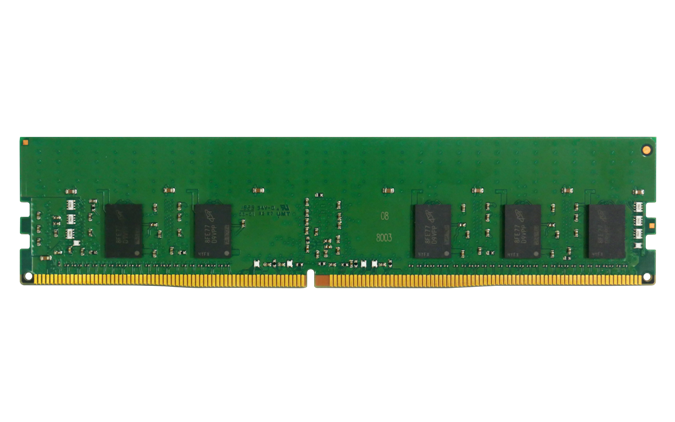
RAM-8GDR4ECT0-RD-3200
DDR type: DDR4(288PIN)
Capacity: 8GB
Spec: 1G X 8
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 1024M*72
Temperature: 0℃~85℃
Environmental Regulation: Halogen Free
-

CAB-PWR20M-C1314
Power Cord, 2M, C13-C14, 250V, 10A, IEC
Dimension (L × W × H): 180 × 29 × 21 (mm)
Weight: 0.19 (kg)


