


QAI-h1290FX
Edge AI úložný server připravený pro GPU, podporující NVIDIA® GPU, U.2 NVMe SSD a připojení 25GbE – navržený pro lokální AI, virtualizaci a výpočetně náročné pracovní zátěže.
QAI-h1290FX je edge server pro výpočetní a úložné konvergence desktopové třídy, který kombinuje architekturu vysokého výkonu s ultra rychlým úložištěm. Podporuje konfigurovatelné NVIDIA® RTX™ PRO Blackwell GPU, což z něj činí ideální volbu pro lokální AI, inferenci LLM, soukromé vyhledávání RAG, virtualizaci a další náročné výpočetní pracovní zátěže.
Platforma poháněná QuTS hero se souborovým systémem ZFS poskytuje integritu dat na podnikové úrovni a konzistentní výkon. Ať už jde o nasazení AI, výzkum a vývoj, vysokovýkonné výpočty nebo podnikové virtualizační prostředí, QAI-h1290FX umožňuje flexibilní konfiguraci a rychlé nasazení, zajišťuje bezpečný a efektivní běh kritických pracovních zátěží na okraji sítě.


Architektura připravená pro GPU s podporou RTX PRO Blackwell
Navrženo s podporou GPU, umožňuje použití NVIDIA® RTX™ PRO Blackwell GPU, včetně možností jako RTX PRO 6000 Blackwell Max-Q Workstation, pro splnění požadavků AI pracovních zátěží, generování obrázků, inference a výpočtů akcelerovaných GPU.
Architektura all-flash NVMe úložiště vysoké rychlosti
Vybaveno 12 pozicemi pro U.2 NVMe SSD a podporou SATA SSD, umožňuje flexibilní konfigurace úložiště optimalizované pro výkon, kapacitu nebo náklady. Ideální pro AI pracovní zátěže, virtualizaci a zpracování dat v reálném čase.
Lokální LLM a RAG vyhledávání
Umožňuje lokální nasazení soukromých LLM a vyhledávání založeného na RAG, poskytuje bezpečné sémantické vyhledávání dokumentů bez odesílání citlivých dat do cloudu.
QuTS hero OS na bázi ZFS
Poháněno QuTS hero se ZFS, nabízí inline kompresi, samoopravné funkce, snímky a SnapSync pro integritu dat na podnikové úrovni.
GPU akcelerace a šablony AI aplikací
Využijte akceleraci GPU prostřednictvím Container Station. Jedním kliknutím nasadíte Ollama, AnythingLLM, Stable Diffusion atd. Zjednodušení nasazení AI aplikací.
Připojení 25GbE a připraveno na rozšíření
Vestavěné duální porty 25GbE a 2.5GbE, možnost rozšíření na 100GbE. Rozšiřujte kapacitu pomocí QNAP JBOD pro splnění rostoucích požadavků na úložiště AI dat.


QuTS hero operační systém
Oceněno cenou 2026 MSP Today Product of the Year

QNAP QAI-h1290FX
Vítěz ocenění TechRadar Pro Picks Awards na CES 2026
Ideální aplikace QAI
-
Interní chatbot a znalostní báze
Nasazujte soukromé chatboty podobné ChatGPT pomocí AnythingLLM nebo OpenWebUI. Bezpečně propojte s interními dokumenty pro dotazy zaměstnanců, vyhledávání zásad a podporu školení – není potřeba internet.

-
Soukromý vyhledávač RAG
Spouštějte Retrieval-Augmented Generation (RAG) lokálně s plnou kontrolou nad daty. Umožněte vyhledávání dokumentů v přirozeném jazyce napříč smlouvami, zprávami a archivy – ideální pro právní, finanční a podnikové týmy.

-
Inference AI a generování obsahu
Použijte Stable Diffusion nebo ComfyUI pro generování obrázků, nebo nasazujte vlastní modely pro označování videí, shrnutí dokumentů a lékařskou analýzu. Využijte akceleraci GPU a all-flash úložiště.

Edge AI podnikové úrovně a vysoký výkon výpočtů
QAI-h1290FX není jen úložný systém – je to platforma pro edge computing podnikové úrovně připravená na výpočty. Postavená na architektuře vysokého výkonu, podporuje konfigurovatelné GPU NVIDIA® RTX™ Pro Blackwell, což ji činí vhodnou pro inference velkých jazykových modelů (LLM), generování obrázků, vyhledávání RAG a širokou škálu výpočetně náročných a virtualizovaných úloh.
Ať už jde o inference AI, výzkum a vývoj, analýzu dat nebo podnikové aplikace vyžadující vysoký počet jader a trvalý výkon, jedna platforma podnikové třídy typu desktop může zajistit vynikající efektivitu výpočtů a bezpečnost dat zcela lokálně.
Maximální výkon AI výpočtů (volitelná konfigurace GPU)

Architektura připravená na GPU — Podpora NVIDIA® RTX™ Pro Blackwell
QAI-h1290FX nabízí architekturu připravenou na GPU navrženou pro podporu GPU NVIDIA® RTX™ Pro Blackwell. Postavena na architektuře Blackwell, podporuje akcelerační technologie jako CUDA, TensorRT a Transformer Engine, což ji činí vhodnou pro moderní AI a výpočetně náročné úlohy akcelerované GPU.
Od inferencí velkých jazykových modelů (LLM) a počítačového vidění až po generativní AI a další profesionální aplikace akcelerované GPU lze pracovní zátěže nasadit a provozovat plně lokálně—s vysokým výkonem, zachováním soukromí dat a plnou kontrolou nad systémem. Platforma může také fungovat jako výkonný výpočetní systém zaměřený na CPU s podporou virtualizace a široké škály podnikových scénářů.
-
 Vlajková loď
NVIDIA® RTX™ Pro 6000 Blackwell Max-Q pracovní stanice
- 96 GB GDDR7 ECC paměti
- 24 064 CUDA jader, 752 Tensor jader, 188 RT jader
- 125 TFLOPS (FP32), až 4000 AI TOPS
- 1 792 GB/s šířka pásma paměti
- Spotřeba energie 300 W
- Rozhraní PCIe 5.0 x16
-
 Výkon
NVIDIA® RTX™ Pro 4500 Blackwell
- 32 GB paměti GDDR7 ECC
- 10 496 CUDA jader, 328 Tensor jader, 82 RT jader
- 54,94 TFLOPS (FP32)
- 896 GB/s šířka pásma paměti
- Spotřeba energie 200 W
- Rozhraní PCIe 5.0 x16
NVIDIA® RTX™ Pro Blackwell Series – redefinuje pracovní postupy AI a výkonného výpočetního zpracování
Grafické procesory NVIDIA® RTX™ Pro Blackwell Series jsou speciálně navrženy pro intenzivní AI, výpočetní a kreativní pracovní zátěže, kombinují architekturu Blackwell nové generace s ultra rychlou pamětí GDDR7 ECC. To poskytuje úroveň výpočetního výkonu a kapacity VRAM na jednom profesionálním GPU, která dříve vyžadovala několik spotřebitelských grafických karet.
S podporou až 96 GB VRAM a vylepšenými možnostmi akcelerace AI je řada RTX™ Pro Blackwell ideální pro pokročilé LLM, generativní modely, analýzu dat a komplexní 3D vizualizaci a profesionální výpočetní pracovní postupy.

Poháněno serverovými procesory AMD EPYC™ pro výkonné výpočetní zpracování
QAI-h1290FX je postaven na serverové platformě procesoru AMD EPYC, která poskytuje vysoký počet jader a masivní multithreadový výkon.
Navržen pro dlouhodobý, stabilní provoz při vysoce paralelních úlohách, je vhodný pro virtualizaci, multithreadové výpočty, zpracování dat a edge computing – a zároveň podporuje AI inferenci a širokou škálu výpočetně náročných aplikací.

Operační systém QuTS hero
Operační systém QuTS hero je určen pro podniky a využívá vysoce spolehlivý souborový systém ZFS, který zajišťuje maximální integritu a stabilitu dat pro kritická úložiště. QuTS hero dále optimalizuje výkon a odolnost SSD, aby splňoval náročné požadavky firem na výkon a spolehlivost. Prozkoumejte operační systém QuTS hero Podívejte se na nejnovější funkce QuTS hero
Vzdálený přístup k on-prem AI – kdykoli a odkudkoli
Vytvořte plynulé hybridní pracovní prostředí s několika možnostmi vzdáleného přístupu od QNAP. Ať už spravujete AI aplikace nebo přistupujete k souborům, QAI-h1290FX zajišťuje, že jste vždy připojeni – bez kompromisů v oblasti zabezpečení.
Možnosti přímého nebo reléového přístupu
- myQNAPcloud DDNS:
Přistupujte ke svému rozhraní QuTS hero odkudkoli přes vlastní doménu, bez nutnosti pamatovat si IP adresy. - myQNAPcloud Link:
Zajišťuje bezpečné reléové připojení přes servery QNAP – není třeba otevírat porty routeru ani měnit nastavení firewallu. - Podpora VPN serveru:
Nastavte si soukromou VPN pomocí QVPN Service a umožněte bezpečné šifrované tunely pro plný přístup k síti.
Ať už ladíte nastavení LLM kontejneru, kontrolujete inference logy nebo spolupracujete napříč lokalitami, QAI-h1290FX nabízí spolehlivý přístup k vašemu on-prem AI prostředí z jakéhokoli zařízení, kdykoli.

Výkonnější Container Station: Nová zkušenost s nasazováním AI aplikací
Pro podporu praktického využití AI integruje řada QAI aplikaci Container Station s širokým výběrem šablon AI aplikací. Tyto šablony umožňují jedním kliknutím nasadit oblíbené AI nástroje a frameworky, přičemž QNAP pravidelně poskytuje aktualizace, aby byl zajištěn přístup k nejnovějším technologiím.
Ať už s AI začínáte, nebo chcete přesunout pracovní zátěže do vlastního prostředí, QAI vám usnadní objevování AI, snížení nákladů, zvýšení bezpečnosti dat a dokonce i vývoj vlastních AI nástrojů pro podporu inovací ve firmě.

Jednoduché nasazení AI pomocí kontejnerů
Vylepšete svou AI infrastrukturu bezproblémovou integrací kontejnerů. Prozkoumat Container Station
Kontejnerové prostředí zaměřené na AI
QAI-h1290FX je dodáván s aplikací Container Station, která umožňuje nasazení kontejnerů Docker a LXD. Vzhledem k tomu, že většina dnešních AI nástrojů je dodávána jako kontejnerové aplikace, QAI-h1290FX poskytuje přímý a efektivní způsob nasazení modelů, jako jsou LLM, RAG Search, generování obrázků (např. Stable Diffusion) nebo znalostní databáze jako AnythingLLM – a to vše bez složitého nastavování.

Trvalé ukládání dat pro AI modely
S podporou Docker Volume umožňuje QAI-h1290FX kontejnerům připojit sdílené složky z NAS, což zajišťuje trvalé úložiště i po opětovném vytvoření kontejneru. To je obzvláště užitečné pro AI pracovní zátěže zahrnující velké soubory modelů, trénovací data nebo logy. Už žádné obavy ze ztráty klíčových dat při aktualizacích nebo změnách verzí.

Zjednodušte a zpřístupněte akceleraci pomocí GPU pro všechny AI pracovní zátěže
QAI-h1290FX odstraňuje složitost konfigurace GPU zdrojů v prostředí Docker. Díky intuitivnímu rozhraní Container Station stačí při vytváření nového kontejneru jednoduše vybrat požadovanou NVIDIA® GPU z rozbalovacího menu a kontejner okamžitě získá přístup k výpočetním schopnostem GPU. Ať už nasazujete LLM, generujete obrázky nebo provádíte inference hlubokého učení, QAI-h1290FX zajišťuje, že proces je bezproblémový a efektivní.

Předefinování kreativity pomocí vizuálního designu poháněného AI
ComfyUI poskytuje umělcům, designérům a tvůrcům obsahu výkonné, modulární rozhraní pro tvorbu obrázků a videí řízenou AI. Díky intuitivnímu návrhu založenému na uzlech a podpoře pokročilých modelů, jako je Stable Diffusion, mohou uživatelé snadno generovat, transformovat a animovat vizuální obsah. V kombinaci s akcelerací GPU a flexibilními pracovními postupy ComfyUI snižuje bariéru ke komplexnímu vizuálnímu designu – a odemyká bezprecedentní tvůrčí svobodu.
Skutečný výkon AI – měřeno na QAI-h1290FX
Výkon nasazení AI je ověřen skutečnými benchmarkovými daty. V konfiguraci testu s high-end GPU byl QAI-h1290FX plně vyhodnocen s NVIDIA® RTX™ PRO 6000 Blackwell Max-Q Workstation GPU, což ověřilo jeho výkon v on-premises AI inference a podnikových nasazovacích scénářích.
Ollama LLM Benchmark inference (Rychlé nasazení)
Díky akceleračním schopnostem GPU architektury Blackwell může QAI-h1290FX lokálně spouštět širokou škálu velkých jazykových modelů prostřednictvím Ollama.
Ollama umožňuje rychlé nasazení a zjednodušenou správu, což ji činí vhodnou pro PoC projekty, prostředí s jedním uživatelem a malé až střední případy použití, jako je vyhledávání založené na RAG, AI asistenti a offline inference.
vLLM Benchmark souběžné inference (podniková úroveň propustnosti)
Pro splnění požadavků na AI služby pro více uživatelů a vysokou souběžnost podporuje QAI-h1290FX také nasazení s inferenčním enginem vLLM.
Ve srovnání s přístupy zaměřenými na jednotlivé požadavky vLLM výrazně zlepšuje využití GPU a celkovou propustnost díky Paged Attention a efektivním mechanismům plánování. To je obzvláště vhodné pro podnikové AI služby, systémy RAG pro více uživatelů a AI aplikace založené na API.
Při stejné konfiguraci GPU vLLM vykazuje konzistentnější charakteristiky latence a vyšší propustnost tokenů za sekundu v souběžných scénářích požadavků, což je ideální pro produkční prostředí a dlouhodobé podnikové AI nasazení.
Testovaný model velkého jazyka: deepseek-ai/DeepSeek-R1-Distill-Qwen-7B (Hugging Face)
Testovaný model velkého jazykového modelu: openai/gpt-oss-20b (Hugging Face)
Odemkněte potenciál AI pomocí praktických případů použití
Od automatizace dokumentů po kreativní pracovní postupy a automatizaci napříč systémem, QAI-h1290FX umožňuje každému oddělení využívat AI smysluplně a měřitelně – bezpečně hostováno na vaší vlastní infrastruktuře.
Žádné uzamčení v cloudu, žádné složité nastavení – pouze skutečné výsledky díky lokálním LLM, bezpečným kontejnerům a integrovaným funkcím QNAP.
Chytrý HR asistent – interní chatbot pro firemní politiku
Vytvořte interní Q&A asistenta pomocí AnythingLLM + Ollama. Nahrajte HR dokumenty, jako jsou zaměstnanecké příručky, pravidla pro dovolenou a benefity, do QAI-h1290FX. Zaměstnanci mohou klást přirozené otázky jako:
„Jak mohu požádat o rodinnou péči?“
Systém provádí lokální RAG vyhledávání a odpovídá okamžitě, čímž snižuje pracovní zátěž HR a zlepšuje dobu odezvy.

Kreativní tým AI Studio – centrum pro generování obrázků
Týmy designérů používají Stable Diffusion a ComfyUI nasazené na QAI-h1290FX ke generování propagačních obrázků, maket nebo stylizovaných děl pomocí zadání promptu.
Díky akceleraci pomocí GPU a trvalému úložišti NAS získávají designéři rychlé a opakovatelné výsledky—už žádné začínání od nuly.

AI Co-Pilot pro vývojáře – dokumentace, kód a shrnutí
Technické týmy spouštějí LLM jako Qwen nebo Llama v Ollama na QAI-h1290FX pro pomoc s psaním specifikací, kontrolou kódu a technickými překlady.
Nahrajte API dokumentaci nebo whitepapery a poté komunikujte s modelem pro upřesnění, shrnutí nebo dokonce formátování v markdownu—zcela offline a bezpečně.

n8n + NAS automatizace – spouštějte AI odkudkoli
S n8n nainstalovaným na QAI-h1290FX můžete automatizovat úkoly, které propojují AI s firemními procesy. Například:

AI Docker aplikace na QAI-h1290FX
Spouštějte výkonná AI řešení přes Container Station a integraci GPU.

Přeměňte svůj NAS na znalostní centrum s AI
Umožněte firemním uživatelům vyhledávat, porozumět a získávat informace rychleji než kdy dříve – díky Qsirch a nové generaci Vyhledávání RAG. QAI-h1290FX přináší inteligenci do vašich dokumentů a zároveň vše udržuje bezpečné a v místním prostředí.

Qsirch – chytré fulltextové vyhledávání
Qsirch nabízí bleskově rychlé fulltextové vyhledávání ve všech souborech NAS – PDF, Office dokumentech, e-mailech a dalších. Díky pokročilým filtrům, indexaci a funkcím náhledu mohou uživatelé okamžitě najít relevantní dokumenty v terabajtech dat. Zjistit více

Vyhledávání RAG – kontextové odpovědi s AI
Vyhledávání RAG (Retrieval-Augmented Generation) posouvá možnosti dál tím, že kombinuje Qsirch s lokálním velkým jazykovým modelem (LLM). Když uživatelé položí otázku, systém nejprve vyhledá relevantní soubory pomocí Qsirch a poté vygeneruje přesnou odpověď v přirozeném jazyce pomocí AI přímo na zařízení. Zjistit více
Na QAI-h1290FX je vyhledávání RAG plně lokální:
Standardní záruka 5 let
Na model QAI-h1290FX se vztahuje pětiletá záruka bez dalších poplatků – vaše obchodní organizace tak bude mít větší jistotu.

Srovnání Edge AI Storage Serverů:
QAI-h1290FX vs. jiné AI NAS vs. AI pracovní stanice
Potřebujete pomoc?
Kontaktujte nás a získejte další doporučené produkty nebo řešení, která odpovídají vašim potřebám a požadavkům!
Dokoupitelné vybavení
-

QM2-2P-244A
Dual M.2 22110/2280 PCIe SSD expansion card;
Dimension (L × W × H): 170.5 × 20.6 × 68.9 (mm)
Weight: 0.29 (kg)
Please check the M.2 SSD compatibility list and QM2 Installation Guide
-

QM2-2P-344A
Dual M.2 PCIe SSD expansion card; M.2 2280/22110 PCIe NVMe(Gen 3x4) SSDs; PCIe Gen3x4 host interface
Dimension (L × W × H): 170.5 × 19.3 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P-384A
Dual M.2 PCIe SSD expansion card; M.2 2280/22110 PCIe NVMe(Gen 3x4) SSDs; PCIe Gen3x8 host interface
Dimension (L × W × H): 170.5 × 19.3 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P10G1TB
QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen3 x 8 , 1 x Marvell AQC113C 10GbE NBASE-T port
Dimension (L × W × H): 152.65 × 18.9 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P2G2T
QNAP QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen3 x 4 , 2 x Intel I225LM 2.5GbE NBASE-T port
Dimension (L × W × H): 152.65 × 20.6 × 68.9 (mm)
Weight: 0.29 (kg)
-

QM2-2P410G1T (EOL)
QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen4 x 4 , 1 x AQC113C 10GbE NBASE-T port
Dimension (L × W × H): 187 × 19.35 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P410G2T (EOL)
QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen4 x 4 , 2 x AQC113C 10GbE NBASE-T port
Dimension (L × W × H): 187 × 19.35 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2S-220A
Dual M.2 22110/2280 SATA SSD expansion card;
Dimension (L × W × H): 147.15 × 20.6 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-4P-384
Quad M.2 PCIe SSD expansion card; supports up to four M.2 2280 formfactor M.2 PCIe (Gen3 x4) SSDs; PCIe Gen3 x8 host interface; Low-profile bracket pre-loaded, Low-profile flat and Full-height are bundled
Dimension (L × W × H): 204.95 × 68.9 × 20.6 (mm)
Weight: 0.32 (kg)
-

QM2-4S-240 (EOL)
Quad M.2 2280 SATA SSD expansion card
Dimension (L × W × H): 204.95 × 68.9 × 20.6 (mm)
Weight: 0.32 (kg)
-
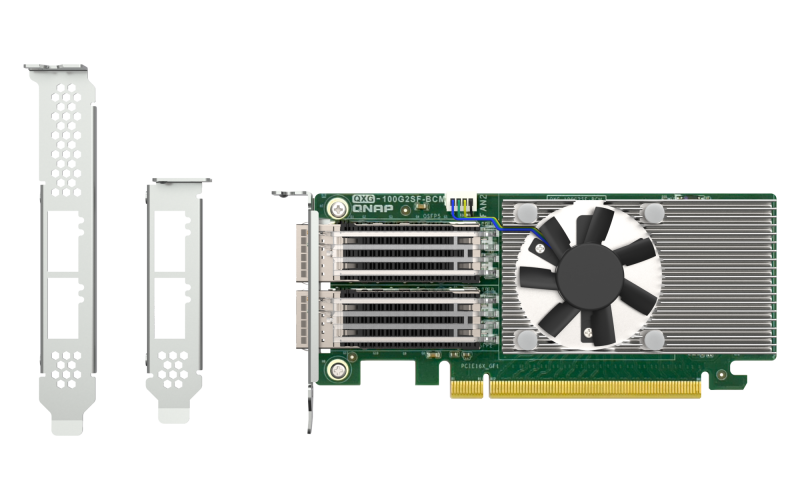
QXG-100G2SF-BCM
Dual-port QSFP28 100Gb network expansion card; Broadcom 57508; PCIe Gen4 x16
Dimension (L × W × H): 156.5 × 18.5 × 68.9 (mm)
Weight: 0.28 (kg)
-
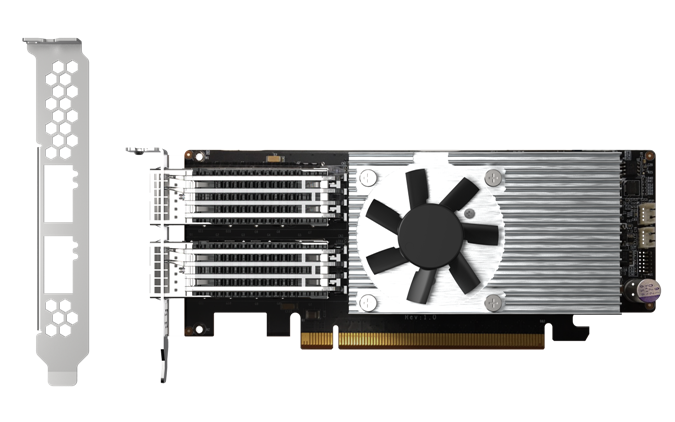
QXG-100G2SF-E810
Dual port 100GbE Network adapter; 2 x QSFP28; Intel E810 Ethernet controller
Dimension (L × W × H): 169.6 × 69 × 18.7 (mm)
Weight: 0.36 (kg)
-

QXG-10G1T
Single-port (10Gbase-T) 10GbE network expansion card, PCIe Gen3 x4, Low-profile bracket pre-loaded, Low-profile flat and Full-height are bundled
Dimension (L × W × H): 143 × 193 × 52 (mm)
Weight: 0.53 (kg)
-

QXG-10G2SF-NXE
Dual-port SFP+ 10Gb network expansion card; low-profile formfactor; PCIe Gen3 x8
Dimension (L × W × H): 110 × 18.3 × 68.9 (mm)
Weight: 0.23 (kg)
-

QXG-10G2SF-X710
Dual-port SFP+ 10Gb network expansion card; low-profile formfactor; PCIe Gen3 x8
Dimension (L × W × H): 26 × 10.5 × 6 (mm)
Weight: 0.29 (kg)
-

QXG-10G2T
Dual-port 10GBASE-T 10Gb network expansion card; low-profile formfactor; PCIe Gen3 x4
Dimension (L × W × H): 54.5 × 39.5 × 18 (mm)
Weight: 0.24 (kg)
-

QXG-10G2T-X710
Dual-port 10GbE Network Adaptor, Intel 700 series Ethernet Controller
Dimension (L × W × H): 113.6 × 68.9 × 18.3 (mm)
Weight: 0.24 (kg)
-

QXG-10G2TB (EOL)
Dual-port 10GbE Network Adaptor, Aquantia AQC113C
Dimension (L × W × H): 104.7 × 16.1 × 68.9 (mm)
Weight: 0.28 (kg)
-

QXG-25G2SF-CX6
Dual-port SFP28 25Gb network expansion card; Mellanox ConnectX-6 Lx;low-profile formfactor; PCIe Gen4 x8
Dimension (L × W × H): 120 × 16.5 × 69 (mm)
Weight: 0.15 (kg)
-
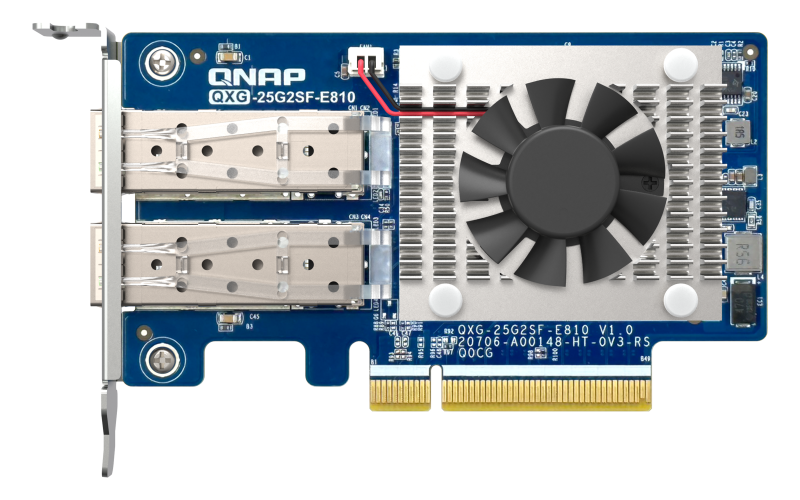
QXG-25G2SF-E810
2 port 25GbE(Intel E810-XXVAM2) Network Interface Cards (NIC)
Dimension (L × W × H): 119.3 × 68.9 × 18.1 (mm)
Weight: 0.23 (kg)
-

QXG-2G1T-I225
Single port 2.5GbE 4-speed Network card
Dimension (L × W × H): 67.3 × 68.9 × 25.2 (mm)
Weight: 0.19 (kg)
-

QXG-2G2T-I225
Dual port 2.5GbE 4-speed Network card
Dimension (L × W × H): 54 × 39.5 × 17 (mm)
Weight: 0.33 (kg)
-

QXG-2G4T-I225
Quad port 2.5GbE 4-speed Network card
Dimension (L × W × H): 104.6 × 68.9 × 24.1 (mm)
Weight: 0.24 (kg)
-

QXG-5G1T-111C
QNAP 5GbE multi-Gig expansion card;Aquantia AQC111C;Gen2 x 1;low profile
Dimension (L × W × H): 145 × 190 × 52 (mm)
Weight: 0.20 (kg)
-

QXG-5G2T-111C (EOL)
QNAP dual port 5GbE multi-Gig expansion card;Aquantia AQC111C;Gen2 x 2;low profile
Dimension (L × W × H): 145 × 190 × 52 (mm)
Weight: 0.20 (kg)
-
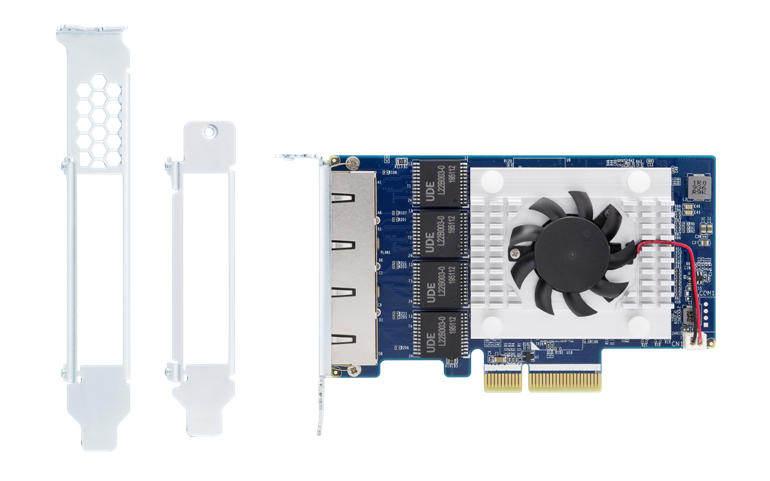
QXG-5G4T-111C (EOL)
QNAP Quad port 5GbE multi-Gig expansion card;Aquantia AQC111C;Gen2 x 4;low profile
Dimension (L × W × H): 145 × 190 × 52 (mm)
Weight: 0.23 (kg)
-

QXP-16G2FC
QNAP 2-port 16Gbps fiber channel adapter, PCIe 3.0 x8, SFP+, low profile, w/ SFP+ 16G transceivers
Dimension (L × W × H): 190 × 143 × 50 (mm)
Weight: 0.28 (kg)
-

QXP-32G2FC
QNAP 2-port 32Gbps fiber channel adapter, PCIe 3.0 x8, SFP+, low profile, w/ SFP+ 32G optical transceivers
Dimension (L × W × H): 190 × 143 × 50 (mm)
Weight: 0.28 (kg)
-
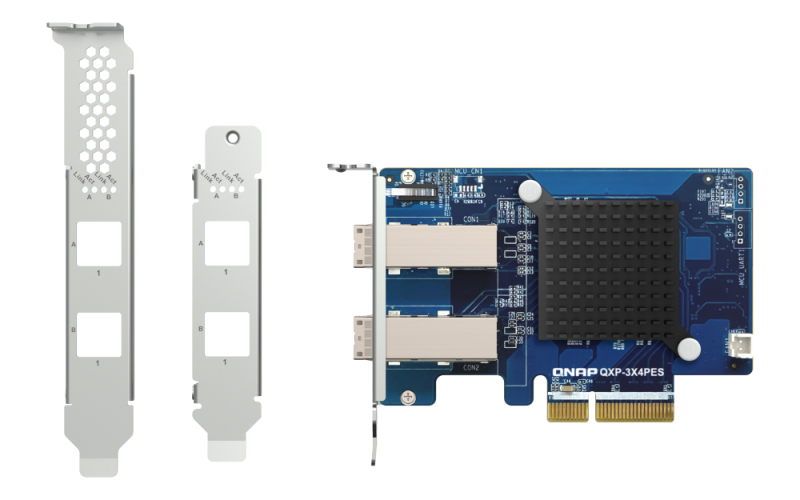
QXP-3X4PES
2 ports (SFF-8644) Expansion card; PCIe Gen3 x4 for QNAP PCIe JBOD series
Dimension (L × W × H): 102.65 × 68.9 × 19 (mm)
Weight: 0.11 (kg)
-
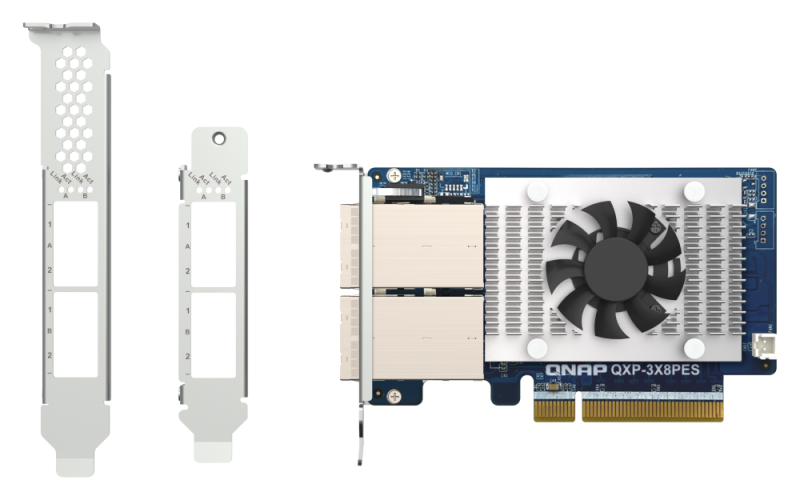
QXP-3X8PES
2 ports (SFF-8644 1x2) Expansion card; PCIe Gen3 x8 for QNAP PCIe JBOD series
Dimension (L × W × H): 112.65 × 68.9 × 18.26 (mm)
Weight: 0.17 (kg)
-
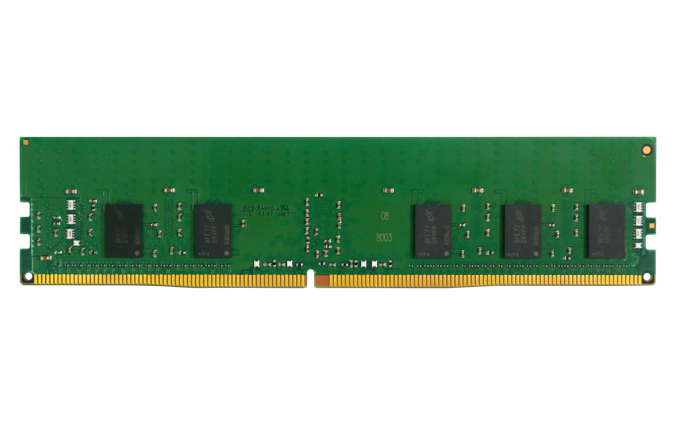
RAM-16GDR4ECT0-RD-3200
DDR type: DDR4(288PIN)
Capacity: 16GB
Spec: 1G X 8
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 2048M*72
Temperature: 0℃~85℃
Environmental Regulation: Halogen Free
-
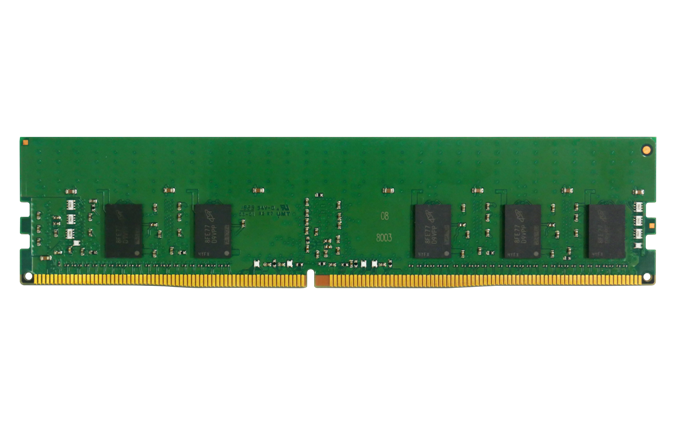
RAM-32GDR4ECT0-RD-3200 (EOL)
DDR type: DDR4(288PIN)
Capacity: 32GB
Spec: 2G X 8
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 4G*72
Temperature: 0℃~85℃
Environmental Regulation: Halogen Free
-

RAM-32GDR4K0-RD-3200
32GB DDR4 RAM, 3200 MHz, RDIMM
-
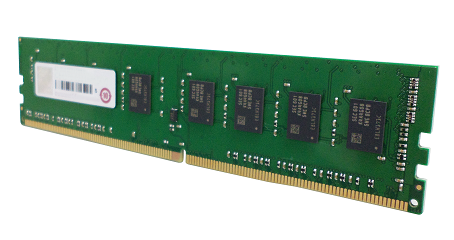
RAM-64GDR4ECK0-RD-3200 (EOL)
DDR type: DDR4(288PIN)
Capacity: 64GB
Spec: 4G X 4
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 8G*72
Temperature: 0℃~85℃
Environmental Regulation: RoHS
-
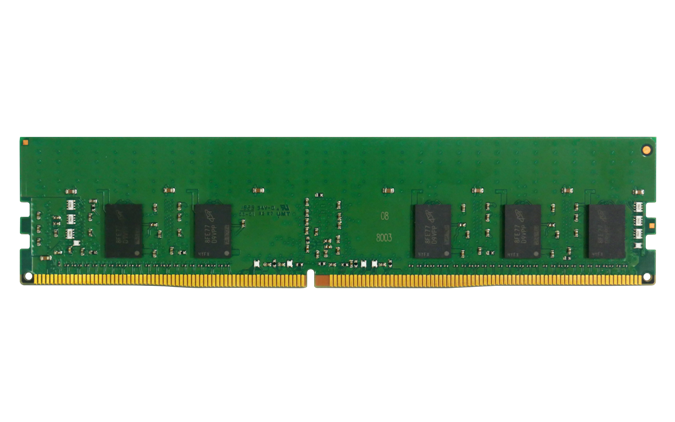
RAM-8GDR4ECT0-RD-3200
DDR type: DDR4(288PIN)
Capacity: 8GB
Spec: 1G X 8
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 1024M*72
Temperature: 0℃~85℃
Environmental Regulation: Halogen Free
-
CAB-PWR20M-C1314
Power Cord, 2M, C13-C14, 250V, 10A, IEC
Dimension (L × W × H): 180 × 29 × 21 (mm)
Weight: 0.19 (kg)


