


QAI-h1290FX
Máy chủ lưu trữ Edge AI sẵn sàng cho GPU, hỗ trợ GPU NVIDIA®, SSD U.2 NVMe và kết nối 25GbE—được thiết kế cho AI tại chỗ, ảo hóa và các tác vụ tính toán chuyên sâu.
QAI-h1290FX là máy chủ hội tụ lưu trữ và tính toán edge chuẩn desktop, kết hợp kiến trúc tính toán hiệu năng cao với lưu trữ siêu nhanh. Hỗ trợ GPU NVIDIA® RTX™ PRO Blackwell cấu hình linh hoạt, lý tưởng cho AI tại chỗ, suy luận LLM, tìm kiếm RAG riêng tư, ảo hóa và các tác vụ tính toán chuyên sâu khác.
Được vận hành bởi QuTS hero với hệ thống tệp ZFS, nền tảng này mang lại tính toàn vẹn dữ liệu cấp doanh nghiệp và hiệu suất ổn định. Dù là triển khai AI, nghiên cứu & phát triển, tính toán hiệu năng cao hay môi trường ảo hóa doanh nghiệp, QAI-h1290FX cho phép cấu hình linh hoạt và triển khai nhanh, đảm bảo các tác vụ quan trọng được vận hành an toàn và hiệu quả tại edge.


Kiến trúc sẵn sàng cho GPU với hỗ trợ RTX PRO Blackwell
Được thiết kế sẵn sàng cho GPU, hỗ trợ GPU NVIDIA® RTX™ PRO Blackwell, bao gồm các tùy chọn như RTX PRO 6000 Blackwell Max-Q Workstation, đáp ứng nhu cầu khối lượng công việc AI, tạo hình ảnh, suy luận và tính toán tăng tốc bằng GPU.
Kiến trúc lưu trữ NVMe all-flash tốc độ cao
Trang bị 12 khay SSD U.2 NVMe và hỗ trợ SSD SATA, cho phép cấu hình lưu trữ linh hoạt tối ưu về hiệu suất, dung lượng hoặc chi phí. Lý tưởng cho khối lượng công việc AI, ảo hóa và xử lý dữ liệu thời gian thực.
LLM & Tìm kiếm RAG tại chỗ
Cho phép triển khai cục bộ các mô hình LLM riêng tư và tìm kiếm dựa trên RAG, cung cấp khả năng truy xuất tài liệu ngữ nghĩa an toàn mà không cần gửi dữ liệu nhạy cảm lên đám mây.
Hệ điều hành QuTS hero dựa trên ZFS
Vận hành bởi QuTS hero với ZFS, cung cấp nén dữ liệu trực tuyến, tự phục hồi, ảnh chụp nhanh và SnapSync đảm bảo tính toàn vẹn dữ liệu cấp doanh nghiệp.
Tăng tốc GPU & Mẫu ứng dụng AI
Tận dụng tăng tốc GPU qua Container Station. Triển khai Ollama, AnythingLLM, Stable Diffusion... chỉ với một cú nhấp chuột. Đơn giản hóa việc triển khai ứng dụng AI.
Kết nối 25GbE & sẵn sàng mở rộng
Cổng tích hợp sẵn 25GbE kép và 2.5GbE, có thể nâng cấp lên 100GbE. Mở rộng dung lượng với QNAP JBOD để đáp ứng nhu cầu lưu trữ dữ liệu AI ngày càng tăng.


Hệ điều hành QuTS hero
Vinh dự nhận Giải thưởng 2026 MSP Today Product of the Year

QNAP QAI-h1290FX
Đạt giải thưởng TechRadar Pro Picks tại CES 2026
Ứng dụng lý tưởng cho QAI
-
Chatbot nội bộ & Cơ sở kiến thức
Triển khai chatbot riêng tư giống ChatGPT bằng AnythingLLM hoặc OpenWebUI. Kết nối an toàn với tài liệu nội bộ để hỗ trợ hỏi đáp cho nhân viên, tìm kiếm chính sách và đào tạo—không cần internet.

-
Công cụ tìm kiếm RAG riêng tư
Chạy Retrieval-Augmented Generation (RAG) tại chỗ với toàn quyền kiểm soát dữ liệu. Cho phép tìm kiếm tài liệu bằng ngôn ngữ tự nhiên trên hợp đồng, báo cáo và lưu trữ—lý tưởng cho các nhóm pháp lý, tài chính và doanh nghiệp.

-
Suy luận AI & Tạo nội dung
Sử dụng Stable Diffusion hoặc ComfyUI để tạo hình ảnh, hoặc triển khai mô hình tùy chỉnh cho gắn thẻ video, tóm tắt tài liệu và phân tích y tế. Tận dụng tăng tốc GPU và lưu trữ all-flash.

AI Edge cấp doanh nghiệp và Điện toán hiệu năng cao
QAI-h1290FX không chỉ là một hệ thống lưu trữ — mà còn là nền tảng điện toán biên cấp doanh nghiệp sẵn sàng tính toán. Được xây dựng trên kiến trúc điện toán hiệu năng cao, thiết bị hỗ trợ GPU NVIDIA® RTX™ Pro Blackwell cấu hình linh hoạt, phù hợp cho suy luận mô hình ngôn ngữ lớn (LLM), tạo hình ảnh, tìm kiếm RAG và nhiều tác vụ tính toán chuyên sâu hoặc ảo hóa.
Dù là cho suy luận AI, nghiên cứu & phát triển, phân tích dữ liệu hay các ứng dụng doanh nghiệp cần số lượng nhân cao và hiệu suất bền vững, một nền tảng doanh nghiệp dạng desktop duy nhất có thể mang lại hiệu quả tính toán vượt trội và bảo mật dữ liệu hoàn toàn tại chỗ.
Hiệu suất tính toán AI tối đa (Cấu hình GPU tùy chọn)

Kiến trúc sẵn sàng cho GPU — Hỗ trợ NVIDIA® RTX™ Pro Blackwell
QAI-h1290FX sở hữu kiến trúc sẵn sàng cho GPU, được thiết kế để hỗ trợ GPU NVIDIA® RTX™ Pro Blackwell. Được xây dựng trên kiến trúc Blackwell, sản phẩm hỗ trợ các công nghệ tăng tốc như CUDA, TensorRT và Transformer Engine, phù hợp cho các khối lượng công việc AI hiện đại và tính toán tăng tốc bằng GPU.
Từ suy luận mô hình ngôn ngữ lớn (LLM), thị giác máy tính đến AI sinh tạo và các ứng dụng chuyên nghiệp tăng tốc GPU khác, các khối lượng công việc có thể được triển khai và thực thi hoàn toàn tại chỗ—mang lại hiệu suất mạnh mẽ đồng thời đảm bảo quyền riêng tư dữ liệu và kiểm soát hệ thống toàn diện. Nền tảng cũng có thể vận hành như một hệ thống tính toán hiệu năng cao tập trung vào CPU, hỗ trợ ảo hóa và nhiều kịch bản tính toán doanh nghiệp đa dạng.
-
 Flagship
NVIDIA® RTX™ Pro 6000 Blackwell Max-Q Workstation
- Bộ nhớ GDDR7 ECC 96 GB
- 24.064 nhân CUDA, 752 nhân Tensor, 188 nhân RT
- 125 TFLOPS (FP32), lên đến 4000 AI TOPS
- Băng thông bộ nhớ 1.792 GB/s
- Tiêu thụ điện năng 300W
- Kết nối PCIe 5.0 x16
-
 Hiệu suất
NVIDIA® RTX™ Pro 4500 Blackwell
- Bộ nhớ ECC GDDR7 32 GB
- 10.496 nhân CUDA, 328 nhân Tensor, 82 nhân RT
- 54,94 TFLOPS (FP32)
- Băng thông bộ nhớ 896 GB/s
- Tiêu thụ điện năng 200W
- Giao tiếp PCIe 5.0 x16
Dòng NVIDIA® RTX™ Pro Blackwell — Định nghĩa lại quy trình AI và điện toán hiệu suất cao
Dòng GPU NVIDIA® RTX™ Pro Blackwell được thiết kế chuyên biệt cho các tác vụ AI, tính toán và sáng tạo cường độ cao, kết hợp kiến trúc Blackwell thế hệ mới với bộ nhớ ECC GDDR7 siêu nhanh. Điều này mang lại hiệu suất tính toán và dung lượng VRAM trên một GPU chuyên nghiệp mà trước đây cần nhiều card đồ họa tiêu dùng.
Với khả năng hỗ trợ lên đến 96GB VRAM và tăng tốc AI vượt trội, dòng RTX™ Pro Blackwell lý tưởng cho các LLM tiên tiến, mô hình tạo sinh, phân tích dữ liệu, cũng như các quy trình tính toán chuyên nghiệp và trực quan hóa 3D phức tạp.

Được trang bị bộ xử lý AMD EPYC™ chuẩn máy chủ cho hiệu suất tính toán cao
QAI-h1290FX được xây dựng trên nền tảng bộ xử lý AMD EPYC chuẩn máy chủ, mang lại số lượng nhân lớn và hiệu suất đa luồng vượt trội.
Thiết kế cho vận hành ổn định, lâu dài dưới các tác vụ song song cao, phù hợp cho ảo hóa, tính toán đa luồng, xử lý dữ liệu và các kịch bản điện toán biên—đồng thời hỗ trợ suy luận AI và nhiều ứng dụng đòi hỏi hiệu suất tính toán cao.

Hệ điều hành QuTS hero
Được thiết kế cho các doanh nghiệp, hệ điều hành QuTS hero sử dụng hệ thống tệp ZFS cực kỳ đáng tin cậy để cung cấp tính toàn vẹn và ổn định dữ liệu tối đa cho lưu trữ quan trọng. QuTS hero còn tối ưu hóa hiệu suất và độ bền của SSD để đáp ứng các yêu cầu khắt khe của doanh nghiệp về hiệu suất và độ tin cậy. Khám phá hệ điều hành QuTS hero Xem các tính năng mới nhất của QuTS hero
Truy cập từ xa vào AI on-prem – mọi lúc, mọi nơi
Tạo môi trường làm việc kết hợp liền mạch với nhiều tùy chọn truy cập từ xa do QNAP cung cấp. Dù bạn đang quản lý ứng dụng AI hay truy cập file, QAI-h1290FX đảm bảo bạn luôn được kết nối—mà không ảnh hưởng đến bảo mật.
Tùy chọn truy cập trực tiếp hoặc chuyển tiếp
- myQNAPcloud DDNS:
Truy cập giao diện QuTS hero của bạn từ bất cứ đâu qua tên miền tùy chỉnh, không cần nhớ địa chỉ IP. - myQNAPcloud Link:
Thiết lập kết nối chuyển tiếp an toàn qua máy chủ QNAP—không cần mở cổng router hoặc thay đổi cài đặt tường lửa. - Hỗ trợ máy chủ VPN:
Thiết lập VPN riêng bằng Dịch vụ QVPN, cho phép tạo đường hầm mã hóa an toàn để truy cập toàn bộ mạng.
Dù bạn đang tinh chỉnh thiết lập container LLM, xem lại nhật ký suy luận, hay cộng tác từ nhiều địa điểm, QAI-h1290FX cung cấp truy cập ổn định vào môi trường AI on-prem của bạn từ mọi thiết bị, bất cứ lúc nào.

Một Container Station mạnh mẽ hơn: Trải nghiệm mới trong triển khai ứng dụng AI
Để thúc đẩy việc ứng dụng AI thực tiễn, dòng QAI tích hợp Container Station với nhiều mẫu ứng dụng AI đa dạng. Các mẫu này hỗ trợ triển khai chỉ với một cú nhấp chuột cho các công cụ và framework AI phổ biến, được QNAP cập nhật thường xuyên để đảm bảo tiếp cận các công nghệ mới nhất.
Dù bạn là người mới bắt đầu với AI hay muốn chuyển khối lượng công việc về tại chỗ, QAI giúp bạn dễ dàng khám phá AI, giảm chi phí, tăng cường bảo mật dữ liệu và thậm chí phát triển các công cụ AI tùy chỉnh để thúc đẩy đổi mới kinh doanh.

Triển khai AI bằng container trở nên đơn giản
Tăng cường hạ tầng AI của bạn với tích hợp container liền mạch. Khám phá Container Station
Môi trường container tập trung vào AI
QAI-h1290FX đi kèm với Container Station, cho phép triển khai các container Docker và LXD. Vì hầu hết các công cụ AI hiện nay đều được cung cấp dưới dạng ứng dụng container hóa, QAI-h1290FX mang đến cách triển khai trực tiếp và hiệu quả cho các mô hình như LLM, RAG Search, tạo ảnh (ví dụ: Stable Diffusion) hoặc các engine cơ sở tri thức như AnythingLLM—tất cả mà không cần thiết lập phức tạp.

Lưu trữ dữ liệu bền vững cho các mô hình AI
Với hỗ trợ Docker Volume, QAI-h1290FX cho phép các container gắn thư mục chia sẻ từ NAS, đảm bảo lưu trữ bền vững ngay cả sau khi xây dựng lại container. Điều này đặc biệt hữu ích cho các khối lượng công việc AI liên quan đến các tệp mô hình lớn, dữ liệu huấn luyện hoặc log. Không còn lo lắng về việc mất dữ liệu quan trọng khi cập nhật hoặc chuyển đổi phiên bản.

Đơn giản hóa và phổ biến hóa tăng tốc GPU cho mọi khối lượng công việc AI
QAI-h1290FX loại bỏ sự phức tạp khi cấu hình tài nguyên GPU trong môi trường Docker. Với giao diện trực quan của Container Station, khi tạo container mới, chỉ cần chọn GPU NVIDIA® mong muốn từ menu thả xuống, container sẽ ngay lập tức được truy cập vào khả năng tính toán GPU. Dù bạn triển khai LLM, tạo hình ảnh hay thực thi suy luận deep learning, QAI-h1290FX đảm bảo quy trình liền mạch và hiệu quả.

Định nghĩa lại sáng tạo với thiết kế hình ảnh ứng dụng AI
ComfyUI trao quyền cho nghệ sĩ, nhà thiết kế và nhà sáng tạo nội dung với giao diện mạnh mẽ, dạng mô-đun để tạo hình ảnh và video bằng AI. Nhờ thiết kế trực quan dựa trên node và hỗ trợ các mô hình tiên tiến như Stable Diffusion, người dùng có thể dễ dàng tạo, biến đổi và hoạt hình hóa nội dung hình ảnh. Kết hợp với tăng tốc GPU và quy trình linh hoạt, ComfyUI hạ thấp rào cản cho thiết kế hình ảnh phức tạp—mở khóa tự do sáng tạo chưa từng có.
Hiệu suất AI thực tế – đo trên QAI-h1290FX
Hiệu suất triển khai AI được xác thực qua dữ liệu benchmark thực tế. Trong cấu hình thử nghiệm GPU cao cấp, QAI-h1290FX đã được đánh giá toàn diện với GPU NVIDIA® RTX™ PRO 6000 Blackwell Max-Q Workstation, xác minh hiệu suất trong các kịch bản suy luận AI tại chỗ và triển khai doanh nghiệp.
Ollama LLM Inference Benchmark (Triển khai nhanh)
Tận dụng khả năng tăng tốc GPU của kiến trúc Blackwell, QAI-h1290FX có thể chạy nhiều mô hình ngôn ngữ lớn tại chỗ qua Ollama.
Ollama cho phép triển khai nhanh và quản lý đơn giản, phù hợp cho các dự án PoC, môi trường một người dùng và các trường hợp sử dụng nhỏ đến vừa như tìm kiếm dựa trên RAG, trợ lý AI và suy luận ngoại tuyến.
Đánh giá hiệu năng suy luận đồng thời vLLM (Thông lượng cấp doanh nghiệp)
Để đáp ứng nhu cầu dịch vụ AI đa người dùng và đồng thời cao, QAI-h1290FX cũng hỗ trợ triển khai với công cụ suy luận vLLM.
So với các phương pháp suy luận theo từng yêu cầu riêng lẻ, vLLM cải thiện đáng kể hiệu suất sử dụng GPU và tổng thông lượng nhờ Paged Attention và các cơ chế lập lịch hiệu quả. Điều này đặc biệt phù hợp cho dịch vụ AI doanh nghiệp, hệ thống RAG đa người dùng và các ứng dụng AI dựa trên API.
Với cùng cấu hình GPU, vLLM thể hiện độ trễ ổn định hơn và thông lượng token/giây cao hơn trong các kịch bản yêu cầu đồng thời, lý tưởng cho môi trường sản xuất và triển khai AI doanh nghiệp lâu dài.
Mô hình ngôn ngữ lớn được kiểm thử: deepseek-ai/DeepSeek-R1-Distill-Qwen-7B (Hugging Face)
Đã kiểm tra Mô hình Ngôn ngữ Lớn: openai/gpt-oss-20b (Hugging Face)
Khai phá tiềm năng AI với các trường hợp sử dụng thực tế
Từ tự động hóa tài liệu đến quy trình sáng tạo và tự động hóa toàn hệ thống, QAI-h1290FX giúp mọi phòng ban áp dụng AI một cách ý nghĩa, có thể đo lường—được lưu trữ an toàn trên hạ tầng của bạn.
Không bị khóa đám mây, không thiết lập phức tạp—chỉ có kết quả thực tế nhờ LLM cục bộ, container bảo mật và các tính năng tích hợp của QNAP.
Trợ lý Nhân sự Thông minh – Chatbot Chính sách Nội bộ
Xây dựng trợ lý Hỏi & Đáp nội bộ bằng AnythingLLM + Ollama. Tải lên các tài liệu nhân sự như sổ tay nhân viên, chính sách nghỉ phép và phúc lợi vào QAI-h1290FX. Nhân viên có thể đặt câu hỏi tự nhiên như:
“Làm thế nào để tôi xin nghỉ chăm sóc gia đình?”
Hệ thống thực hiện tìm kiếm RAG cục bộ và trả lời ngay lập tức, giảm tải công việc cho HR và cải thiện thời gian phản hồi.

Studio AI Đội Sáng tạo – Trung tâm Tạo ảnh
Các nhóm thiết kế sử dụng Stable Diffusion và ComfyUI được triển khai trên QAI-h1290FX để tạo hình ảnh quảng cáo, mockup hoặc tác phẩm nghệ thuật phong cách thông qua nhập prompt.
Nhờ tăng tốc GPU và lưu trữ NAS liên tục, nhà thiết kế nhận được kết quả nhanh chóng, có thể tái tạo—không còn phải bắt đầu lại từ đầu.

AI Co-Pilot cho Lập trình viên – Tài liệu, Mã nguồn & Tóm tắt
Các nhóm kỹ thuật chạy các LLM như Qwen hoặc Llama trong Ollama trên QAI-h1290FX để hỗ trợ viết đặc tả, rà soát mã và dịch thuật kỹ thuật.
Tải lên tài liệu API hoặc whitepaper, sau đó trò chuyện với mô hình để làm rõ, tóm tắt hoặc thậm chí định dạng markdown—hoàn toàn ngoại tuyến và bảo mật.

n8n + NAS Tự động hóa – Kích hoạt AI từ bất cứ đâu
Với n8n được cài đặt trên QAI-h1290FX, bạn có thể tự động hóa các tác vụ tích hợp AI vào hoạt động kinh doanh. Ví dụ:

Ứng dụng AI Docker trên QAI-h1290FX
Chạy các giải pháp AI mạnh mẽ qua Container Station & tích hợp GPU.

Biến NAS của bạn thành trung tâm tri thức AI
Trao quyền cho người dùng doanh nghiệp tìm kiếm, hiểu và truy xuất thông tin nhanh hơn bao giờ hết—được hỗ trợ bởi Qsirch và RAG Search thế hệ mới. QAI-h1290FX mang trí tuệ vào tài liệu của bạn đồng thời giữ mọi thứ an toàn và tại chỗ.

Qsirch – Tìm kiếm toàn văn thông minh
Qsirch cung cấp khả năng tìm kiếm toàn văn cực nhanh trên tất cả file NAS của bạn—PDF, tài liệu Office, email và nhiều hơn nữa. Với bộ lọc nâng cao, lập chỉ mục và chức năng xem trước, người dùng có thể tìm tài liệu liên quan ngay lập tức trên hàng terabyte dữ liệu. Tìm hiểu thêm

RAG Search – Câu trả lời ngữ cảnh bằng AI
RAG (Retrieval-Augmented Generation) Search nâng tầm bằng cách kết hợp Qsirch với Mô hình Ngôn ngữ Lớn (LLM) cục bộ. Khi người dùng đặt câu hỏi, hệ thống sẽ truy xuất các file liên quan qua Qsirch, sau đó tạo câu trả lời chính xác, tự nhiên bằng AI trên thiết bị. Tìm hiểu thêm
Trên QAI-h1290FX, RAG Search hoàn toàn tại chỗ:
Bảo hành 5 năm tiêu chuẩn
QAI-h1290FX được bảo hành 5 năm mà không tốn thêm chi phí - mang lại sự an tâm hơn cho tổ chức doanh nghiệp của bạn.

So sánh Máy chủ lưu trữ AI Edge:
QAI-h1290FX vs. NAS AI khác vs. AI Workstation
Cần giúp đỡ?
Liên hệ với chúng tôi ngay để nhận thêm các sản phẩm hoặc giải pháp được đề xuất phù hợp với nhu cầu và yêu cầu của bạn!
Phụ kiện tùy chọn
-

QM2-2P-244A
Dual M.2 22110/2280 PCIe SSD expansion card;
Dimension (L × W × H): 170.5 × 20.6 × 68.9 (mm)
Weight: 0.29 (kg)
Please check the M.2 SSD compatibility list and QM2 Installation Guide
-

QM2-2P-344A
Dual M.2 PCIe SSD expansion card; M.2 2280/22110 PCIe NVMe(Gen 3x4) SSDs; PCIe Gen3x4 host interface
Dimension (L × W × H): 170.5 × 19.3 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P-384A
Dual M.2 PCIe SSD expansion card; M.2 2280/22110 PCIe NVMe(Gen 3x4) SSDs; PCIe Gen3x8 host interface
Dimension (L × W × H): 170.5 × 19.3 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P10G1TB
QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen3 x 8 , 1 x Marvell AQC113C 10GbE NBASE-T port
Dimension (L × W × H): 152.65 × 18.9 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P2G2T
QNAP QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen3 x 4 , 2 x Intel I225LM 2.5GbE NBASE-T port
Dimension (L × W × H): 152.65 × 20.6 × 68.9 (mm)
Weight: 0.29 (kg)
-

QM2-2P410G1T (EOL)
QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen4 x 4 , 1 x AQC113C 10GbE NBASE-T port
Dimension (L × W × H): 187 × 19.35 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P410G2T (EOL)
QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen4 x 4 , 2 x AQC113C 10GbE NBASE-T port
Dimension (L × W × H): 187 × 19.35 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2S-220A
Dual M.2 22110/2280 SATA SSD expansion card;
Dimension (L × W × H): 147.15 × 20.6 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-4P-384
Quad M.2 PCIe SSD expansion card; supports up to four M.2 2280 formfactor M.2 PCIe (Gen3 x4) SSDs; PCIe Gen3 x8 host interface; Low-profile bracket pre-loaded, Low-profile flat and Full-height are bundled
Dimension (L × W × H): 204.95 × 68.9 × 20.6 (mm)
Weight: 0.32 (kg)
-

QM2-4S-240 (EOL)
Quad M.2 2280 SATA SSD expansion card
Dimension (L × W × H): 204.95 × 68.9 × 20.6 (mm)
Weight: 0.32 (kg)
-
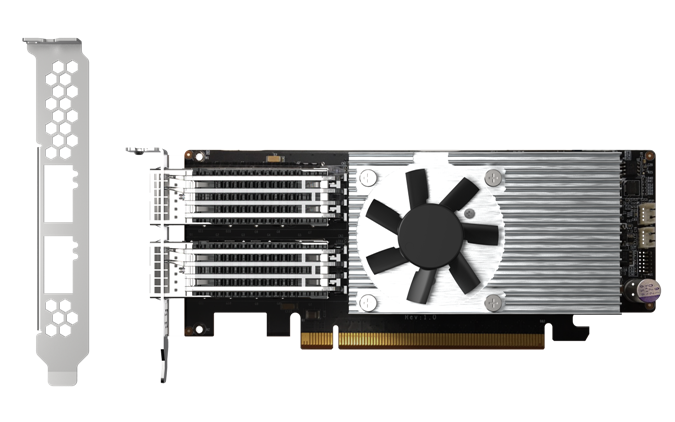
QXG-100G2SF-E810
Dual port 100GbE Network adapter; 2 x QSFP28; Intel E810 Ethernet controller
Dimension (L × W × H): 169.6 × 69 × 18.7 (mm)
Weight: 0.36 (kg)
-

QXG-10G1T
Single-port (10Gbase-T) 10GbE network expansion card, PCIe Gen3 x4, Low-profile bracket pre-loaded, Low-profile flat and Full-height are bundled
Dimension (L × W × H): 143 × 193 × 52 (mm)
Weight: 0.53 (kg)
-

QXG-10G2SF-X710
Dual-port SFP+ 10Gb network expansion card; low-profile formfactor; PCIe Gen3 x8
Dimension (L × W × H): 26 × 10.5 × 6 (mm)
Weight: 0.29 (kg)
-

QXG-10G2T
Dual-port 10GBASE-T 10Gb network expansion card; low-profile formfactor; PCIe Gen3 x4
Dimension (L × W × H): 54.5 × 39.5 × 18 (mm)
Weight: 0.24 (kg)
-

QXG-10G2T-X710
Dual-port 10GbE Network Adaptor, Intel 700 series Ethernet Controller
Dimension (L × W × H): 113.6 × 68.9 × 18.3 (mm)
Weight: 0.24 (kg)
-

QXG-10G2TB (EOL)
Dual-port 10GbE Network Adaptor, Aquantia AQC113C
Dimension (L × W × H): 104.7 × 16.1 × 68.9 (mm)
Weight: 0.28 (kg)
-

QXG-25G2SF-CX6
Dual-port SFP28 25Gb network expansion card; Mellanox ConnectX-6 Lx;low-profile formfactor; PCIe Gen4 x8
Dimension (L × W × H): 120 × 16.5 × 69 (mm)
Weight: 0.15 (kg)
-
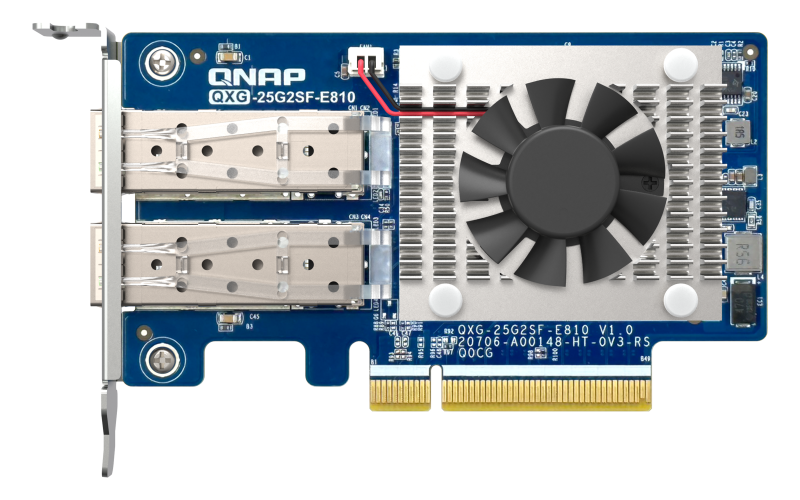
QXG-25G2SF-E810
2 port 25GbE(Intel E810-XXVAM2) Network Interface Cards (NIC)
Dimension (L × W × H): 119.3 × 68.9 × 18.1 (mm)
Weight: 0.23 (kg)
-

QXG-2G1T-I225
Single port 2.5GbE 4-speed Network card
Dimension (L × W × H): 67.3 × 68.9 × 25.2 (mm)
Weight: 0.19 (kg)
-

QXG-2G2T-I225
Dual port 2.5GbE 4-speed Network card
Dimension (L × W × H): 81.3 × 68.9 × 25.2 (mm)
Weight: 0.23 (kg)
-

QXG-2G4T-I225
Quad port 2.5GbE 4-speed Network card
Dimension (L × W × H): 104.6 × 68.9 × 24.1 (mm)
Weight: 0.24 (kg)
-

QXG-5G1T-111C
QNAP 5GbE multi-Gig expansion card;Aquantia AQC111C;Gen2 x 1;low profile
Dimension (L × W × H): 145 × 190 × 52 (mm)
Weight: 0.20 (kg)
-

QXG-5G2T-111C (EOL)
QNAP dual port 5GbE multi-Gig expansion card;Aquantia AQC111C;Gen2 x 2;low profile
Dimension (L × W × H): 145 × 190 × 52 (mm)
Weight: 0.20 (kg)
-
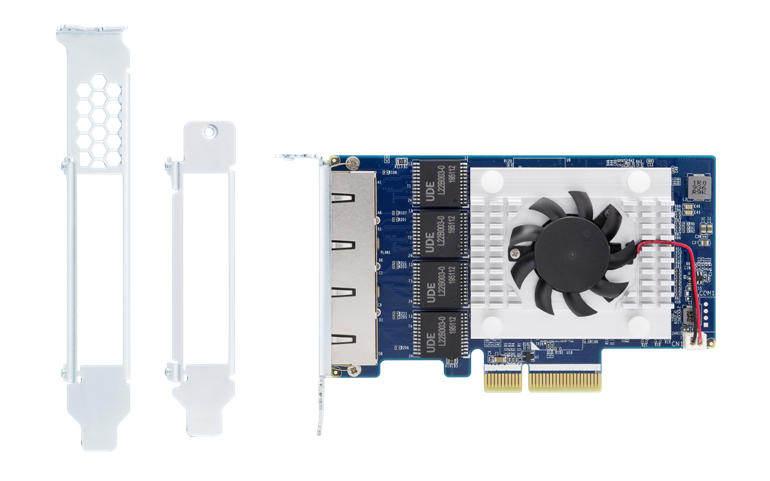
QXG-5G4T-111C (EOL)
QNAP Quad port 5GbE multi-Gig expansion card;Aquantia AQC111C;Gen2 x 4;low profile
Dimension (L × W × H): 145 × 190 × 52 (mm)
Weight: 0.23 (kg)
-

QXP-16G2FC
QNAP 2-port 16Gbps fiber channel adapter, PCIe 3.0 x8, SFP+, low profile, w/ SFP+ 16G transceivers
Dimension (L × W × H): 190 × 143 × 50 (mm)
Weight: 0.28 (kg)
-

QXP-32G2FC
QNAP 2-port 32Gbps fiber channel adapter, PCIe 3.0 x8, SFP+, low profile, w/ SFP+ 32G optical transceivers
Dimension (L × W × H): 190 × 143 × 50 (mm)
Weight: 0.28 (kg)
-
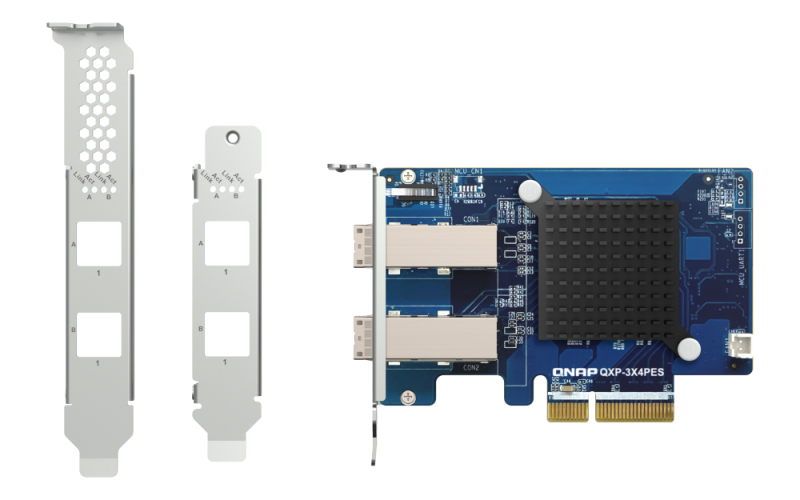
QXP-3X4PES
2 ports (SFF-8644) Expansion card; PCIe Gen3 x4 for QNAP PCIe JBOD series
Dimension (L × W × H): 102.65 × 68.9 × 19 (mm)
Weight: 0.11 (kg)
-
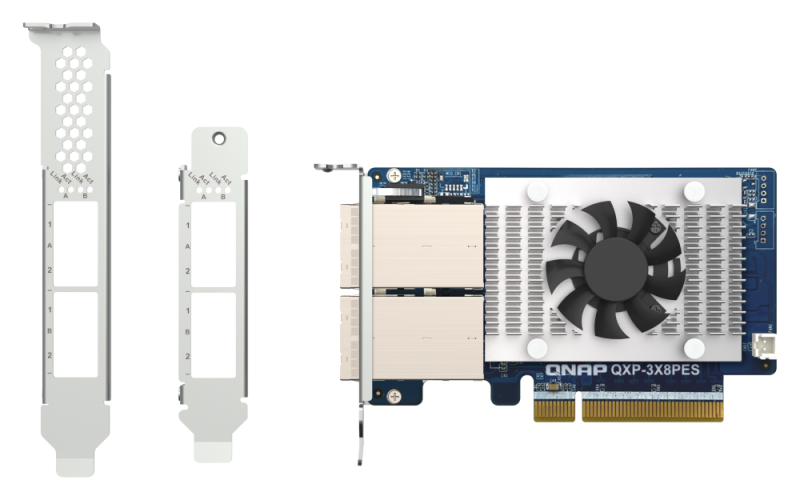
QXP-3X8PES
2 ports (SFF-8644 1x2) Expansion card; PCIe Gen3 x8 for QNAP PCIe JBOD series
Dimension (L × W × H): 112.65 × 68.9 × 18.26 (mm)
Weight: 0.17 (kg)
-
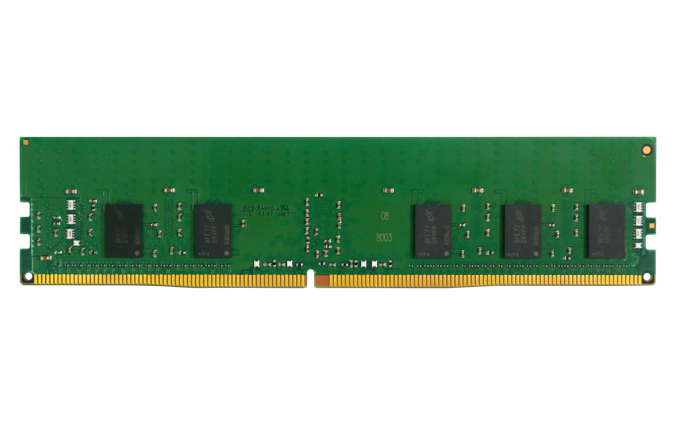
RAM-16GDR4ECT0-RD-3200
DDR type: DDR4(288PIN)
Capacity: 16GB
Spec: 1G X 8
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 2048M*72
Temperature: 0℃~85℃
Environmental Regulation: Halogen Free
-
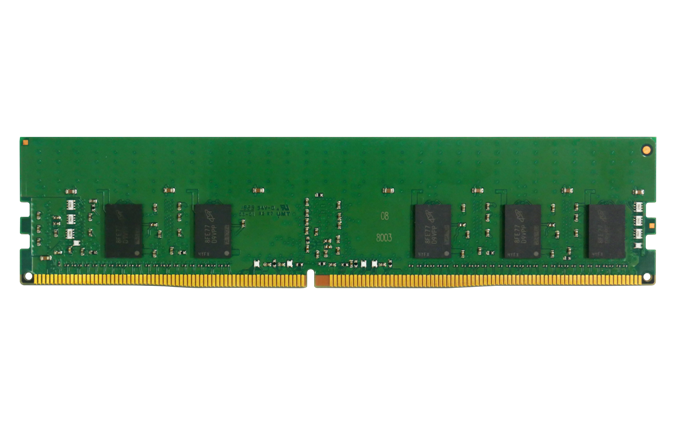
RAM-32GDR4ECT0-RD-3200 (EOL)
DDR type: DDR4(288PIN)
Capacity: 32GB
Spec: 2G X 8
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 4G*72
Temperature: 0℃~85℃
Environmental Regulation: Halogen Free
-

RAM-32GDR4K0-RD-3200
32GB DDR4 RAM, 3200 MHz, RDIMM
-
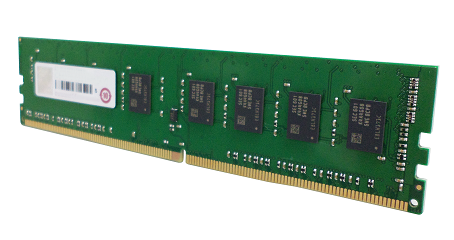
RAM-64GDR4ECK0-RD-3200 (EOL)
DDR type: DDR4(288PIN)
Capacity: 64GB
Spec: 4G X 4
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 8G*72
Temperature: 0℃~85℃
Environmental Regulation: RoHS
-
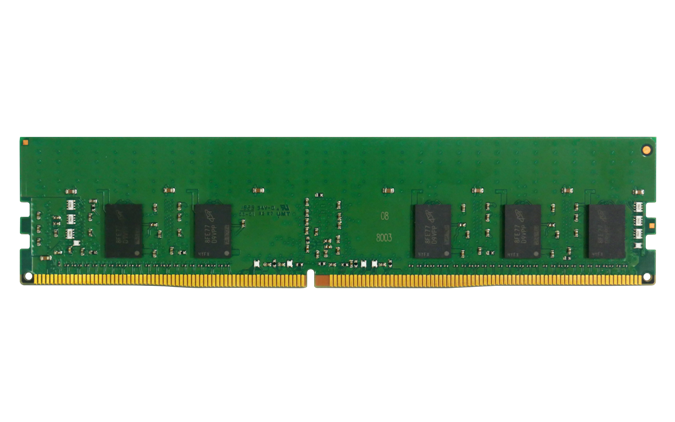
RAM-8GDR4ECT0-RD-3200
DDR type: DDR4(288PIN)
Capacity: 8GB
Spec: 1G X 8
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 1024M*72
Temperature: 0℃~85℃
Environmental Regulation: Halogen Free
-

CAB-PWR20M-C1314
Power Cord, 2M, C13-C14, 250V, 10A, IEC
Dimension (L × W × H): 180 × 29 × 21 (mm)
Weight: 0.19 (kg)


