


QAI-h1290FX
GPU-Ready 엣지 AI 스토리지서버로 NVIDIA® GPU, U.2 NVMe SSD, 25GbE 연결을 지원하며 온프레미스 AI, 가상화, 컴퓨팅 집약적작업에 적합하게 설계되었습니다.
QAI-h1290FX는 데스크톱급엣지컴퓨트 및스토리지융합 서버로, 고성능 컴퓨팅 아키텍처와 초고속스토리지를 결합합니다. 구성 가능한 NVIDIA® RTX™ PRO Blackwell GPU를 지원하여 온프레미스 AI, LLM 추론, 프라이빗 RAG 검색, 가상화, 기타 고성능 컴퓨팅작업에 이상적입니다.
ZFS 파일 시스템을 사용하는QuTS hero기반 플랫폼으로 엔터프라이즈급데이터무결성과 일관된 성능을 제공합니다. AI 배포, 연구 개발, 고성능 컴퓨팅, 엔터프라이즈가상화환경 등 다양한 용도에 맞춰QAI-h1290FX는 유연한 구성과 빠른 배포를 지원하며, 중요한작업가엣지에서 안전하고 효율적으로 실행되도록 보장합니다.


RTX PRO Blackwell 지원 GPU-Ready 아키텍처
GPU-Ready 설계로 NVIDIA® RTX™ PRO Blackwell GPU를 지원하며, RTX PRO 6000 Blackwell Max-Q 워크스테이션 등 다양한 옵션을 제공하여 AI 작업, 이미지 생성, 추론, GPU 가속 컴퓨팅 요구를 충족합니다.
고속올플래시 NVMe 스토리지아키텍처
12개의 U.2 NVMe SSD베이와 SATA SSD지원으로 성능, 용량, 비용에 최적화된 유연한스토리지구성이 가능합니다. AI 작업, 가상화, 실시간데이터처리에 이상적입니다.
온프레미스 LLM 및 RAG 검색
프라이빗 LLM과 RAG 기반 검색을 로컬에 배포하여 민감한데이터를 클라우드로 전송하지 않고 안전한 의미 기반 문서 검색을 제공합니다.
ZFS 기반QuTS hero OS
ZFS가 적용된QuTS hero로 구동되어 인라인 압축, 자동 복구, 스냅샷, SnapSync를 통해 엔터프라이즈급데이터무결성을 제공합니다.
GPU 가속 및 AI 앱 템플릿
Container Station를 통한 GPU 가속 활용. Ollama, AnythingLLM, Stable Diffusion 등 AI 앱을 원클릭 배포. AI 애플리케이션 배포를 간소화합니다.
25GbE 연결 및 확장 준비
내장 듀얼 25GbE 및 2.5GbE 포트, 100GbE 업그레이드 가능. QNAP JBODs로 확장하여 증가하는 AI 데이터 스토리지요구를 충족하세요.


QuTS hero운영 체제
2026 MSP Today 올해의 제품상 수상

QNAP QAI-h1290FX
CES 2026 TechRadar Pro Picks Awards 수상
QAI 이상적인 애플리케이션
-
내부 챗봇 및 지식 베이스
AnythingLLM 또는 OpenWebUI를 사용하여 프라이빗 ChatGPT와 유사한 봇을 배포하세요. 내부 문서에 안전하게 연결하여 직원 Q&A, 정책 검색, 교육 지원을 제공합니다—인터넷이 필요하지 않습니다.

-
프라이빗 RAG 검색 엔진
Retrieval-Augmented Generation(RAG)을 로컬에서 실행하여데이터에 대한 완전한 제어를 제공합니다. 계약서, 보고서, 아카이브 등에서 자연어 문서 검색을 활성화하여 법률, 금융, 엔터프라이즈 팀에 이상적입니다.

-
AI 추론 및 콘텐츠 생성
Stable Diffusion 또는 ComfyUI를 사용하여 이미지 생성, 또는영상태깅, 문서 요약, 의료 분석을 위한 맞춤형 모델을 배포하세요. GPU 가속과올플래시 스토리지의 혜택을 누릴 수 있습니다.

엔터프라이즈급엣지 AI 및 고성능 컴퓨팅
QAI-h1290FX는 단순한스토리지시스템 그 이상입니다 — 컴퓨트 준비가 된 엔터프라이즈급엣지컴퓨팅 플랫폼입니다. 고성능 컴퓨팅 아키텍처를 기반으로 하며, 구성 가능한 NVIDIA® RTX™ Pro Blackwell GPU를 지원하여 대형 언어 모델(LLM) 추론, 이미지 생성, RAG 검색, 다양한 컴퓨트 집약적 및 가상화된작업에 적합합니다.
AI 추론, 연구 개발, 데이터분석 또는 높은 코어 수와 지속적인 성능이 필요한 엔터프라이즈 애플리케이션을 위해, 단일 데스크톱급 엔터프라이즈 플랫폼이 뛰어난 컴퓨트 효율성과데이터 보안을 온프레미스에서 완전히 제공합니다.
최대 AI 컴퓨트 성능(옵션 GPU 구성)

GPU 지원 아키텍처 — NVIDIA® RTX™ Pro Blackwell 지원
QAI-h1290FX는 NVIDIA® RTX™ Pro Blackwell GPU를 지원하도록 설계된 GPU 지원 아키텍처를 갖추고 있습니다. Blackwell 아키텍처 기반으로 CUDA, TensorRT, Transformer Engine 등 가속화 기술을 지원하여 최신 AI 및 GPU 가속 컴퓨팅작업에 적합합니다.
대형 언어 모델(LLM) 추론, 컴퓨터 비전, 생성형 AI 및 기타 GPU 가속 전문 애플리케이션까지, 작업를 온프레미스에서 완전히 배포 및 실행할 수 있어 강력한 성능과데이터프라이버시, 전체 시스템 제어를 제공합니다. 또한 CPU 중심의 고성능 컴퓨팅 시스템으로도 운영 가능하며, 가상화및 다양한 엔터프라이즈 컴퓨팅 시나리오를 지원합니다.
-
 플래그십
NVIDIA® RTX™ Pro 6000 Blackwell Max-Q 워크스테이션
- 96 GB GDDR7 ECC 메모리
- 24,064 CUDA 코어, 752 Tensor 코어, 188 RT 코어
- 125 TFLOPS(FP32), 최대 4000 AI TOPS
- 1,792 GB/s 메모리 대역폭
- 300W 전력 소비
- PCIe 5.0 x16 인터페이스
-
 성능
NVIDIA® RTX™ Pro 4500 Blackwell
- 32 GB GDDR7 ECC 메모리
- 10,496 CUDA 코어, 328 Tensor 코어, 82 RT 코어
- 54.94 TFLOPS (FP32)
- 896 GB/s 메모리 대역폭
- 200W 전력 소모량
- PCIe 5.0 x16 인터페이스
NVIDIA® RTX™ Pro Blackwell 시리즈 — AI 및 고성능 컴퓨팅작업방식의 재정의
NVIDIA® RTX™ Pro Blackwell 시리즈 GPU는 고강도 AI, 컴퓨트, 크리에이티브작업를 위해 특별히 설계되었으며, 차세대 Blackwell 아키텍처와 초고속 GDDR7 ECC 메모리를 결합했습니다. 이를 통해 기존에는 여러 개의 소비자용 그래픽 카드가 필요했던 수준의 컴퓨팅 성능과 VRAM 용량을 단일 전문가용 GPU에서 제공합니다.
최대 96GB VRAM 및 향상된 AI 가속 기능을 지원하는 RTX™ Pro Blackwell 시리즈는 고급 LLM, 생성형 모델, 데이터분석, 복잡한 3D 시각화 및 전문가용 컴퓨팅작업방식에 이상적입니다.

고성능 컴퓨팅을 위한 서버급 AMD EPYC™ 프로세서 탑재
QAI-h1290FX는 서버급 AMD EPYC 프로세서 플랫폼을 기반으로 하여 높은 코어 수와 대규모 멀티스레드 성능을 제공합니다.
고도로 병렬화된작업환경에서 장기간 안정적으로 동작하도록 설계되어가상화, 멀티스레드 컴퓨팅, 데이터처리, 엣지컴퓨팅 시나리오에 적합하며, AI 추론 및 다양한 컴퓨팅 집약적 애플리케이션도 지원합니다.

QuTS hero 운영 체제
기업용으로 설계된 QuTS hero 운영 체제는 안정성이 뛰어난 ZFS 파일 시스템을 채택하여 미션 크리티컬 스토리지에 최고의 데이터 무결성과 안정성을 제공합니다. QuTS hero는 SSD 성능과 내구성을 더욱 최적화하여 성능과 안정성에 대한 기업의 엄격한 요구 사항을 충족합니다. QuTS hero 운영 체제 살펴보기 QuTS hero의 최신 기능을 확인하세요
원격 접속를 온프레미스 AI로 – 언제 어디서나
QNAP에서 제공하는 다양한원격 접속옵션으로 원활한 하이브리드 업무 환경을 구축하세요. AI 애플리케이션을 관리하거나 파일에 액세스할 때, QAI-h1290FX가 항상 연결을 보장하며보안을(를) 손상시키지 않습니다.
직접 또는 릴레이 액세스 옵션
- myQNAPcloud DDNS:
IP 주소를 기억하지 않아도 맞춤 도메인을 통해 어디서든QuTS hero인터페이스에 액세스할 수 있습니다. - myQNAPcloud Link:
QNAP 서버를 통한 안전한 릴레이 연결을 설정합니다—공유기포트를 열거나 방화벽 설정을 수정할 필요가 없습니다. - VPN 서버 지원:
QVPN서비스를 사용하여 개인 VPN을 설정하고, 전체 네트워크 액세스를 위한 안전한 암호화 터널을 제공합니다.
LLM 컨테이너설정을 미세 조정하거나, 추론 로그를 검토하거나, 여러 위치에서 협업하든, QAI-h1290FX는 언제 어디서나 모든 기기에서 온프레미스 AI 환경에 안정적으로 접근할 수 있도록 제공합니다.

더 강력한Container Station: AI 애플리케이션 배포의 새로운 경험
실질적인 AI 도입을 촉진하기 위해 QAI 시리즈는Container Station와 다양한 AI 애플리케이션 템플릿을 통합합니다. 이 템플릿들은 인기 있는 AI 도구와 프레임워크를 원클릭으로 배포할 수 있도록 지원하며, QNAP에서 정기적으로 업데이트하여 최신 기술을 사용할 수 있도록 보장합니다.
AI에 처음 입문하셨거나작업를 온프레미스로 이전하려는 경우에도 QAI는 AI 탐색을 쉽게 하고, 비용을 절감하며, 데이터 보안을 강화하고, 맞춤형 AI 도구를 개발하여 비즈니스 혁신을 촉진할 수 있습니다.

컨테이너 기반 AI 배포를 간편하게
원활한컨테이너통합으로 AI 인프라를 강화하세요. Container Station 탐색
AI 중심컨테이너환경
QAI-h1290FX는Container Station를 제공하여 Docker 및 LXD 컨테이너배포를 지원합니다. 오늘날 대부분의 AI 도구는 컨테이너화된 애플리케이션으로 제공되므로, QAI-h1290FX는 LLM, RAG 검색, 이미지 생성(예: Stable Diffusion), AnythingLLM과 같은 지식 베이스 엔진 등 다양한 모델을 복잡한 설정 없이 직접 효율적으로 배포할 수 있습니다.

AI 모델을 위한 지속적인데이터 스토리지
Docker 볼륨지원으로QAI-h1290FX는컨테이너가NAS에서 공유 폴더를 마운트할 수 있도록 하여, 컨테이너재구성 후에도 지속적인스토리지를 보장합니다. 이는 대형 모델 파일, 훈련데이터, 로그 등 AI 작업에 특히 유용합니다. 업데이트나 버전 전환 시 중요한데이터를 잃을 걱정이 없습니다.

GPU 가속을 모든 AI 작업에 대해 쉽고 접근 가능하게 만듭니다
QAI-h1290FX는 Docker 환경에서 GPU 리소스 구성의 복잡함을 제거합니다. Container Station의 직관적인 인터페이스를 통해 새로운컨테이너를 생성할 때, 드롭다운 메뉴에서 원하는 NVIDIA® GPU를 선택하면컨테이너가 즉시 GPU 컴퓨팅 기능에 접근할 수 있습니다. LLM을 배포하거나 이미지 생성, 딥러닝추론을 실행할 때도QAI-h1290FX가 과정이 원활하고 효율적으로 진행되도록 보장합니다.

AI 기반 시각 디자인으로 창의성을 재정의하다
ComfyUI는 아티스트, 디자이너, 콘텐츠 크리에이터에게 AI 기반 이미지 및영상제작을 위한 강력하고 모듈식 인터페이스를 제공합니다. 직관적인 노드 기반 설계와 Stable Diffusion 같은 고급 모델 지원을 통해 사용자는 시각 콘텐츠를 손쉽게 생성, 변환, 애니메이션할 수 있습니다. GPU 가속과 유연한작업방식이 결합되어 ComfyUI는 복잡한 시각 디자인의 장벽을 낮추고, 전례 없는 창의적 자유를 제공합니다.
실제 환경의 AI 성능 – QAI-h1290FX에서 측정됨
AI 배포 성능은 실제 벤치마크데이터을(를) 통해 검증됩니다. 고급 GPU 테스트 환경에서QAI-h1290FX은 NVIDIA® RTX™ PRO 6000 Blackwell Max-Q 워크스테이션 GPU로 완전히 평가되어 온프레미스 AI 추론 및 엔터프라이즈 배포 시나리오에서의 성능이 확인되었습니다.
Ollama LLM 추론 벤치마크(신속한 배포)
Blackwell 아키텍처의 GPU 가속 기능을 활용하여QAI-h1290FX은 Ollama를 통해 다양한 대형 언어 모델을 로컬에서 실행할 수 있습니다.
Ollama는 신속한 배포와 간편한 관리를 가능하게 하여 PoC(개념 증명) 프로젝트, 단일 사용자 환경, RAG 기반 검색, AI 어시스턴트, 오프라인 추론 등 소규모 및 중간 규모의 사용 사례에 적합합니다.
vLLM 동시 추론 벤치마크(엔터프라이즈급 처리량)
다중 사용자 및 고동시성 AI 서비스 요구 사항을 해결하기 위해QAI-h1290FX는 vLLM 추론 엔진을 통한 배포도 지원합니다.
단일 요청 기반 추론 방식과 비교할 때, vLLM은 Paged Attention과 효율적인 스케줄링 메커니즘을 통해 GPU 활용률과 전체 처리량을 크게 향상시킵니다. 이는 엔터프라이즈 AI 서비스, 다중 사용자 RAG 시스템, API 기반 AI 애플리케이션에 특히 적합합니다.
동일한 GPU 구성에서 vLLM은 동시 요청 시나리오에서 더 일관된레이턴시특성과 더 높은 초당 토큰 처리량을 보여주어, 프로덕션 환경 및 장기 엔터프라이즈 AI 배포에 이상적입니다.
테스트된 대형 언어 모델 : deepseek-ai/DeepSeek-R1-Distill-Qwen-7B (Hugging Face)
테스트된 대형 언어 모델 : openai/gpt-oss-20b (Hugging Face)
실제 활용 사례로 AI 잠재력 활용
문서 자동화부터 창의적인작업방식및 시스템 전체 자동화까지, QAI-h1290FX는 모든 부서가 AI를 의미 있고 측정 가능한 방식으로 적용할 수 있도록 지원합니다. 귀하의 인프라에 안전하게 호스팅됩니다.
클라우드 종속 없음, 복잡한 설정 없음—로컬 LLM, 안전한컨테이너, 통합 QNAP 기능으로 실질적인 결과를 제공합니다.
스마트 HR 어시스턴트 – 내부 정책 챗봇
AnythingLLM + Ollama를 사용하여 내부 Q&A 어시스턴트를 구축하세요. 직원 핸드북, 휴가 정책, 복리후생 등 HR 문서를QAI-h1290FX에 업로드할 수 있습니다. 직원들은 다음과 같이 자연스럽게 질문할 수 있습니다:
“가족돌봄휴가는 어떻게 신청하나요?”
시스템은 로컬 RAG 검색을 수행하고 즉시 답변하여 HR 작업를 줄이고 응답 시간을 개선합니다.

크리에이티브 팀 AI 스튜디오 – 이미지 생성 허브
디자인팀은QAI-h1290FX에 배포된 Stable Diffusion과 ComfyUI를 사용하여 프롬프트 입력을 통해 홍보 이미지, 목업 또는 스타일화된 아트워크를 생성합니다.
GPU 가속과 지속적인NAS 스토리지덕분에 디자이너는 빠르고 재현 가능한 결과를 얻을 수 있습니다—더 이상 처음부터 다시 시작할 필요가 없습니다.

개발자를 위한 AI 코파일럿 – 문서, 코드 & 요약
엔지니어링 팀은 Ollama의QAI-h1290FX에서 Qwen 또는 Llama와 같은 LLM을 실행하여 명세 작성, 코드 리뷰, 기술 번역을 지원합니다.
API 문서나 백서를 업로드한 후, 모델과 대화하여 설명, 요약, 마크다운 포맷팅까지 완전히 오프라인 및 안전하게 처리할 수 있습니다.

n8n + NAS자동화 – 어디서나 AI 트리거
QAI-h1290FX에 n8n이 설치되어 있으면 AI와 비즈니스 운영을 통합하는 작업을 자동화할 수 있습니다. 예를 들어:

QAI-h1290FX에서 AI Docker 애플리케이션
Container Station및 GPU 통합을 통해 강력한 AI 솔루션을 실행합니다.

귀하의NAS을 AI 기반 지식 허브로 변환하세요
Qsirch와 차세대 RAG 검색이 지원하는 엔터프라이즈 사용자가 정보 검색, 이해 및 획득을 그 어느 때보다 빠르게 할 수 있습니다. QAI-h1290FX는 모든 문서를 안전하게 온프레미스에서 지능적으로 관리합니다.

Qsirch – 스마트 전체 텍스트 검색
Qsirch는 모든NAS파일(PDF, Office 문서, 이메일 등)에 대해 매우 빠른 전체 텍스트 검색을 제공합니다. 고급 필터, 인덱싱 및 미리보기 기능을 통해 사용자는 테라바이트의데이터에서 관련 문서를 즉시 찾을 수 있습니다. 자세히 알아보기

RAG 검색 – AI 기반 문맥 답변
RAG(Retrieval-Augmented Generation) 검색은Qsirch과 로컬 대형 언어 모델(LLM)을 결합하여 한 단계 더 나아갑니다. 사용자가 질문을 하면 시스템은 먼저Qsirch를 통해 관련 파일을 검색한 후온디바이스 AI를 사용하여 정확하고 자연스러운 언어로 답변을 생성합니다. 자세히 알아보기
On QAI-h1290FX, RAG 검색은 완전히 온프레미스에서 실행됩니다:

엣지 AI 스토리지서버 비교:
QAI-h1290FX vs. 기타 AI NAS vs. AI 워크스테이션
옵션 액세서리
-

QM2-2P-244A
Dual M.2 22110/2280 PCIe SSD expansion card;
Dimension (L × W × H): 170.5 × 20.6 × 68.9 (mm)
Weight: 0.29 (kg)
Please check the M.2 SSD compatibility list and QM2 Installation Guide
-

QM2-2P-344A
Dual M.2 PCIe SSD expansion card; M.2 2280/22110 PCIe NVMe(Gen 3x4) SSDs; PCIe Gen3x4 host interface
Dimension (L × W × H): 170.5 × 19.3 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P-384A
Dual M.2 PCIe SSD expansion card; M.2 2280/22110 PCIe NVMe(Gen 3x4) SSDs; PCIe Gen3x8 host interface
Dimension (L × W × H): 170.5 × 19.3 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P10G1TB
QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen3 x 8 , 1 x Marvell AQC113C 10GbE NBASE-T port
Dimension (L × W × H): 152.65 × 18.9 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P2G2T
QNAP QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen3 x 4 , 2 x Intel I225LM 2.5GbE NBASE-T port
Dimension (L × W × H): 152.65 × 20.6 × 68.9 (mm)
Weight: 0.29 (kg)
-

QM2-2P410G1T (EOL)
QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen4 x 4 , 1 x AQC113C 10GbE NBASE-T port
Dimension (L × W × H): 187 × 19.35 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2P410G2T (EOL)
QM2 series, 2 x PCIe 2280 M.2 SSD slots, PCIe Gen4 x 4 , 2 x AQC113C 10GbE NBASE-T port
Dimension (L × W × H): 187 × 19.35 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-2S-220A
Dual M.2 22110/2280 SATA SSD expansion card;
Dimension (L × W × H): 147.15 × 20.6 × 68.9 (mm)
Weight: 0.30 (kg)
-

QM2-4P-384
Quad M.2 PCIe SSD expansion card; supports up to four M.2 2280 formfactor M.2 PCIe (Gen3 x4) SSDs; PCIe Gen3 x8 host interface; Low-profile bracket pre-loaded, Low-profile flat and Full-height are bundled
Dimension (L × W × H): 204.95 × 68.9 × 20.6 (mm)
Weight: 0.32 (kg)
-

QM2-4S-240 (EOL)
Quad M.2 2280 SATA SSD expansion card
Dimension (L × W × H): 204.95 × 68.9 × 20.6 (mm)
Weight: 0.32 (kg)
-
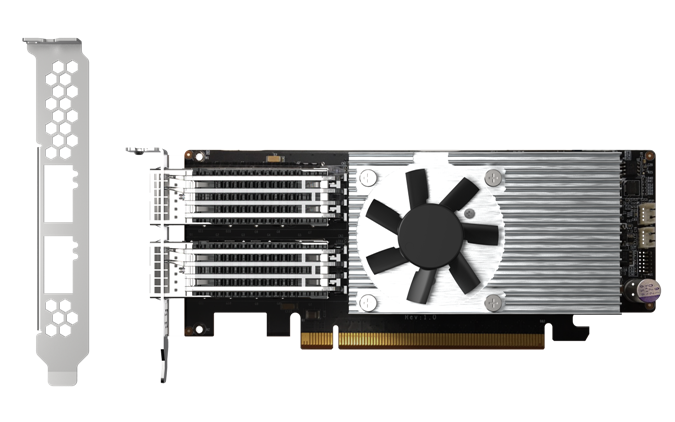
QXG-100G2SF-E810
Dual port 100GbE Network adapter; 2 x QSFP28; Intel E810 Ethernet controller
Dimension (L × W × H): 169.6 × 69 × 18.7 (mm)
Weight: 0.36 (kg)
-

QXG-10G1T
Single-port (10Gbase-T) 10GbE network expansion card, PCIe Gen3 x4, Low-profile bracket pre-loaded, Low-profile flat and Full-height are bundled
Dimension (L × W × H): 143 × 193 × 52 (mm)
Weight: 0.53 (kg)
-

QXG-10G2SF-X710
Dual-port SFP+ 10Gb network expansion card; low-profile formfactor; PCIe Gen3 x8
Dimension (L × W × H): 26 × 10.5 × 6 (mm)
Weight: 0.29 (kg)
-

QXG-10G2T
Dual-port 10GBASE-T 10Gb network expansion card; low-profile formfactor; PCIe Gen3 x4
Dimension (L × W × H): 54.5 × 39.5 × 18 (mm)
Weight: 0.24 (kg)
-

QXG-10G2T-X710
Dual-port 10GbE Network Adaptor, Intel 700 series Ethernet Controller
Dimension (L × W × H): 113.6 × 68.9 × 18.3 (mm)
Weight: 0.24 (kg)
-

QXG-10G2TB (EOL)
Dual-port 10GbE Network Adaptor, Aquantia AQC113C
Dimension (L × W × H): 104.7 × 16.1 × 68.9 (mm)
Weight: 0.28 (kg)
-

QXG-25G2SF-CX6
Dual-port SFP28 25Gb network expansion card; Mellanox ConnectX-6 Lx;low-profile formfactor; PCIe Gen4 x8
Dimension (L × W × H): 120 × 16.5 × 69 (mm)
Weight: 0.15 (kg)
-
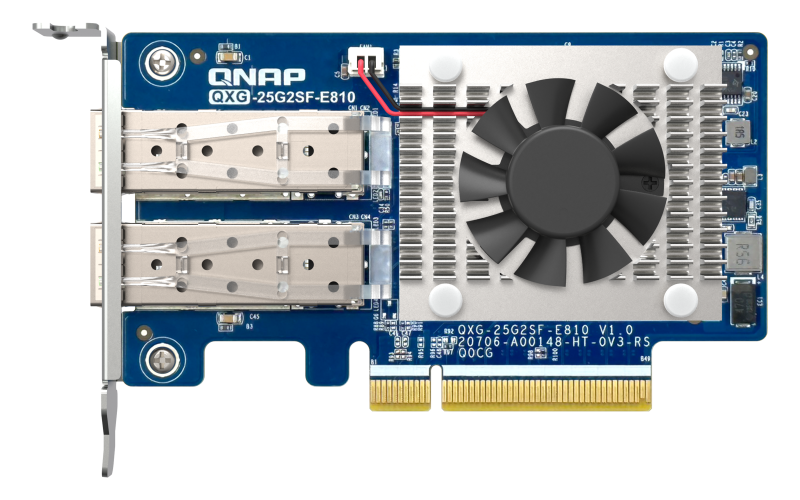
QXG-25G2SF-E810
2 port 25GbE(Intel E810-XXVAM2) Network Interface Cards (NIC)
Dimension (L × W × H): 119.3 × 68.9 × 18.1 (mm)
Weight: 0.23 (kg)
-

QXG-2G1T-I225
Single port 2.5GbE 4-speed Network card
Dimension (L × W × H): 67.3 × 68.9 × 25.2 (mm)
Weight: 0.19 (kg)
-

QXG-2G2T-I225
Dual port 2.5GbE 4-speed Network card
Dimension (L × W × H): 81.3 × 68.9 × 25.2 (mm)
Weight: 0.23 (kg)
-

QXG-2G4T-I225
Quad port 2.5GbE 4-speed Network card
Dimension (L × W × H): 104.6 × 68.9 × 24.1 (mm)
Weight: 0.24 (kg)
-

QXG-5G1T-111C
QNAP 5GbE multi-Gig expansion card;Aquantia AQC111C;Gen2 x 1;low profile
Dimension (L × W × H): 145 × 190 × 52 (mm)
Weight: 0.20 (kg)
-

QXG-5G2T-111C (EOL)
QNAP dual port 5GbE multi-Gig expansion card;Aquantia AQC111C;Gen2 x 2;low profile
Dimension (L × W × H): 145 × 190 × 52 (mm)
Weight: 0.20 (kg)
-
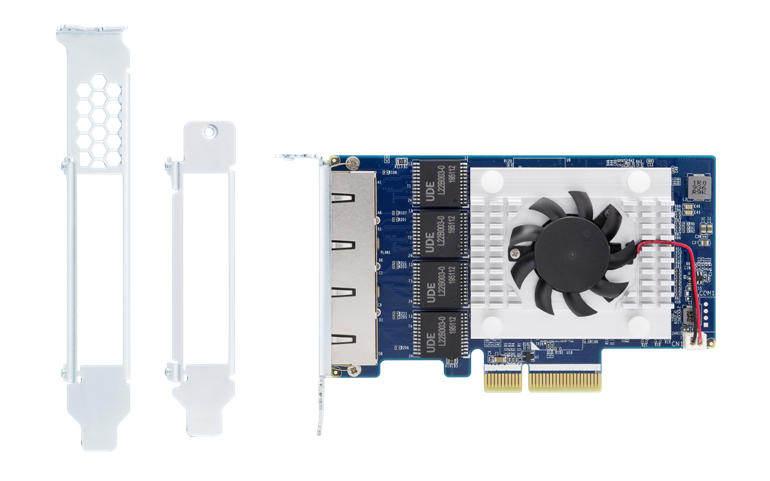
QXG-5G4T-111C (EOL)
QNAP Quad port 5GbE multi-Gig expansion card;Aquantia AQC111C;Gen2 x 4;low profile
Dimension (L × W × H): 145 × 190 × 52 (mm)
Weight: 0.23 (kg)
-

QXP-16G2FC
QNAP 2-port 16Gbps fiber channel adapter, PCIe 3.0 x8, SFP+, low profile, w/ SFP+ 16G transceivers
Dimension (L × W × H): 190 × 143 × 50 (mm)
Weight: 0.28 (kg)
-

QXP-32G2FC
QNAP 2-port 32Gbps fiber channel adapter, PCIe 3.0 x8, SFP+, low profile, w/ SFP+ 32G optical transceivers
Dimension (L × W × H): 190 × 143 × 50 (mm)
Weight: 0.28 (kg)
-
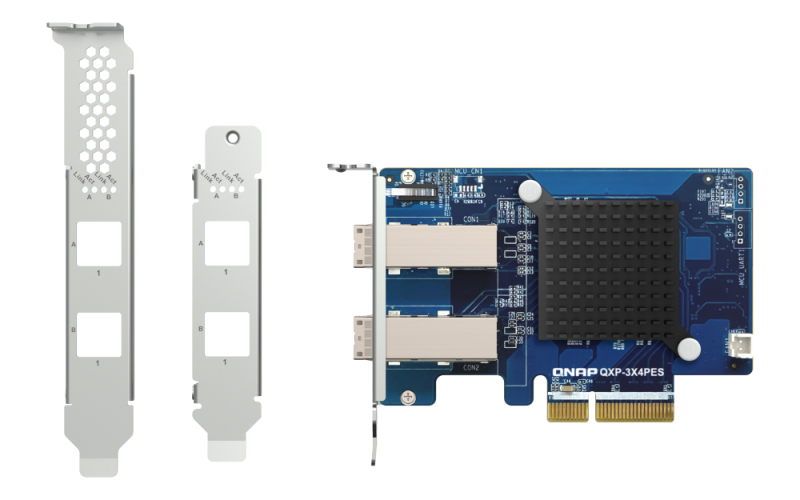
QXP-3X4PES
2 ports (SFF-8644) Expansion card; PCIe Gen3 x4 for QNAP PCIe JBOD series
Dimension (L × W × H): 102.65 × 68.9 × 19 (mm)
Weight: 0.11 (kg)
-
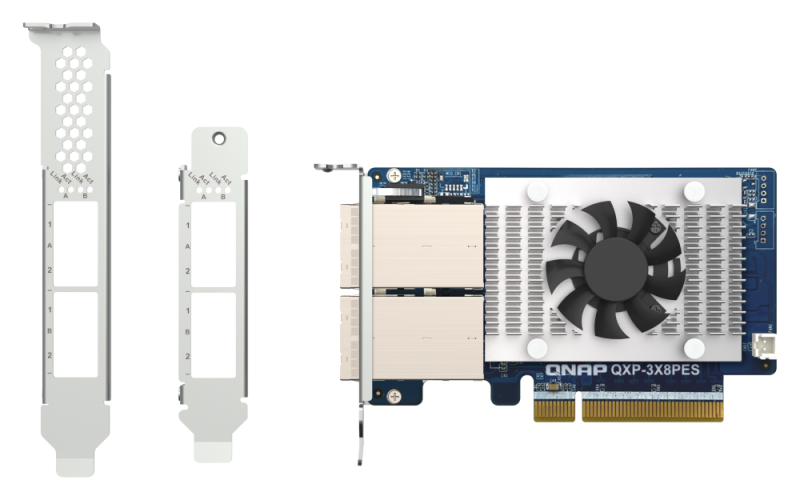
QXP-3X8PES
2 ports (SFF-8644 1x2) Expansion card; PCIe Gen3 x8 for QNAP PCIe JBOD series
Dimension (L × W × H): 112.65 × 68.9 × 18.26 (mm)
Weight: 0.17 (kg)
-
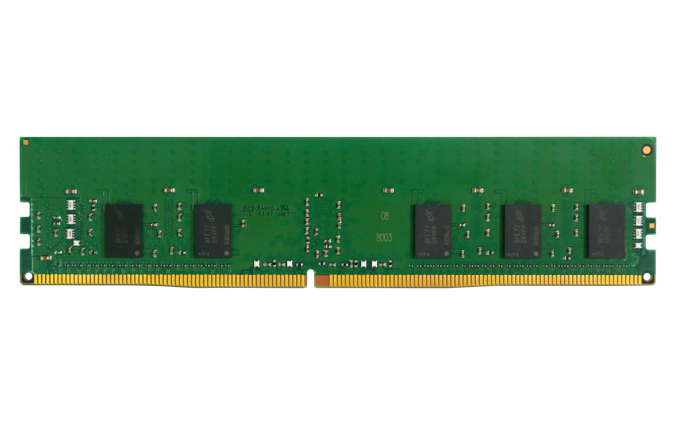
RAM-16GDR4ECT0-RD-3200
DDR type: DDR4(288PIN)
Capacity: 16GB
Spec: 1G X 8
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 2048M*72
Temperature: 0℃~85℃
Environmental Regulation: Halogen Free
-
RAM-32GDR4ECT0-RD-3200 (EOL)
DDR type: DDR4(288PIN)
Capacity: 32GB
Spec: 2G X 8
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 4G*72
Temperature: 0℃~85℃
Environmental Regulation: Halogen Free
-

RAM-32GDR4K0-RD-3200
32GB DDR4 RAM, 3200 MHz, RDIMM
-
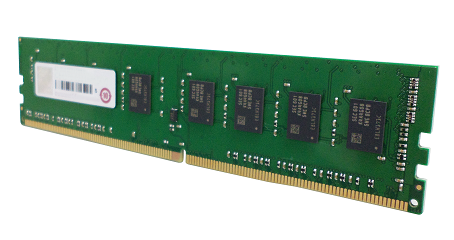
RAM-64GDR4ECK0-RD-3200 (EOL)
DDR type: DDR4(288PIN)
Capacity: 64GB
Spec: 4G X 4
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 8G*72
Temperature: 0℃~85℃
Environmental Regulation: RoHS
-
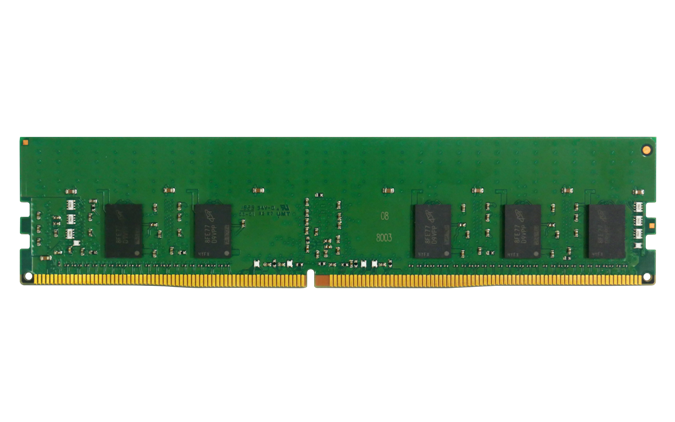
RAM-8GDR4ECT0-RD-3200
DDR type: DDR4(288PIN)
Capacity: 8GB
Spec: 1G X 8
Frequency: DDR4-3200
Form(PIN): 288PIN
with ECC Supported: ECC
Power Supply: 1.2V
Dram Organization: 1024M*72
Temperature: 0℃~85℃
Environmental Regulation: Halogen Free
-

CAB-PWR20M-C1314
Power Cord, 2M, C13-C14, 250V, 10A, IEC
Dimension (L × W × H): 180 × 29 × 21 (mm)
Weight: 0.19 (kg)


