


Jak wdrożyć Ollama na QNAP NAS używając Container Station
Produkty, do których ma to zastosowanie
QTS, QuTS hero
Container Station
Scenariusz
Chcesz uruchamiać duże modele językowe (LLM) lokalnie na swoim QNAP NAS, aby prowadzić prywatne rozmowy AI, uzyskać pomoc w kodowaniu lub analizować dokumenty bez wysyłania danych do chmury. Ollama jest najpopularniejszym i najbardziej przyjaznym dla początkujących silnikiem wnioskowania do tego celu. Ten samouczek wyjaśnia, jak wdrożyć Ollama na QNAP NAS za pomocą Container Station.
Wymagania systemowe
| Wymaganie | Szczegóły |
|---|---|
| Aplikacja QNAP | Container Station 3.x lub nowsza |
| Architektura NAS | x86_64 (procesor Intel lub AMD) (Obsługiwane są tylko niektóre modele oparte na ARM.) |
| Pamięć |
|
| Przestrzeń Pamięć masowa |
|
| GPU (Opcjonalnie) | Kompatybilne procesory GPU NVIDIA (zobacz Lista zgodności) GPU powinno być ustawione na tryb Container Station w Panel sterowania. |
Ollama spróbuje załadować cały model do pamięci domyślnie. Jeśli Twój NAS ma tylko 8–16 GB pamięci RAM, załadowanie modelu 14B lub większego może wyczerpać pamięć systemową, powodując, że usługi NAS staną się nieodpowiedzialne lub system się zrestartuje.
Ryzyko utraty danych
Jeśli nie zamontujesz trwałego woluminu dla
/root/.ollama, wszystkie pobrane modele i konfiguracje zostaną utracone po usunięciu lub ponownym utworzeniu kontenera. Zawsze postępuj zgodnie z instrukcjami montowania woluminu w tym samouczku.- Sprawdź rozmiar modelu w stosunku do dostępnej pamięci RAM z wyprzedzeniem.
- Ustaw limity pamięci, aby ograniczyć użycie pamięci przez kontener.
- Zacznij od małych modeli (1B lub 3B) i oceń stabilność systemu przed próbą użycia większych modeli.
Procedura
Metoda 1: Wdrożenie tylko na CPU (bez wymaganego GPU)
Utwórz foldery Pamięć masowa.
Otwórz File Station i utwórz następujący folder do przechowywania danych modelu Ollama:
/share/Container/ollama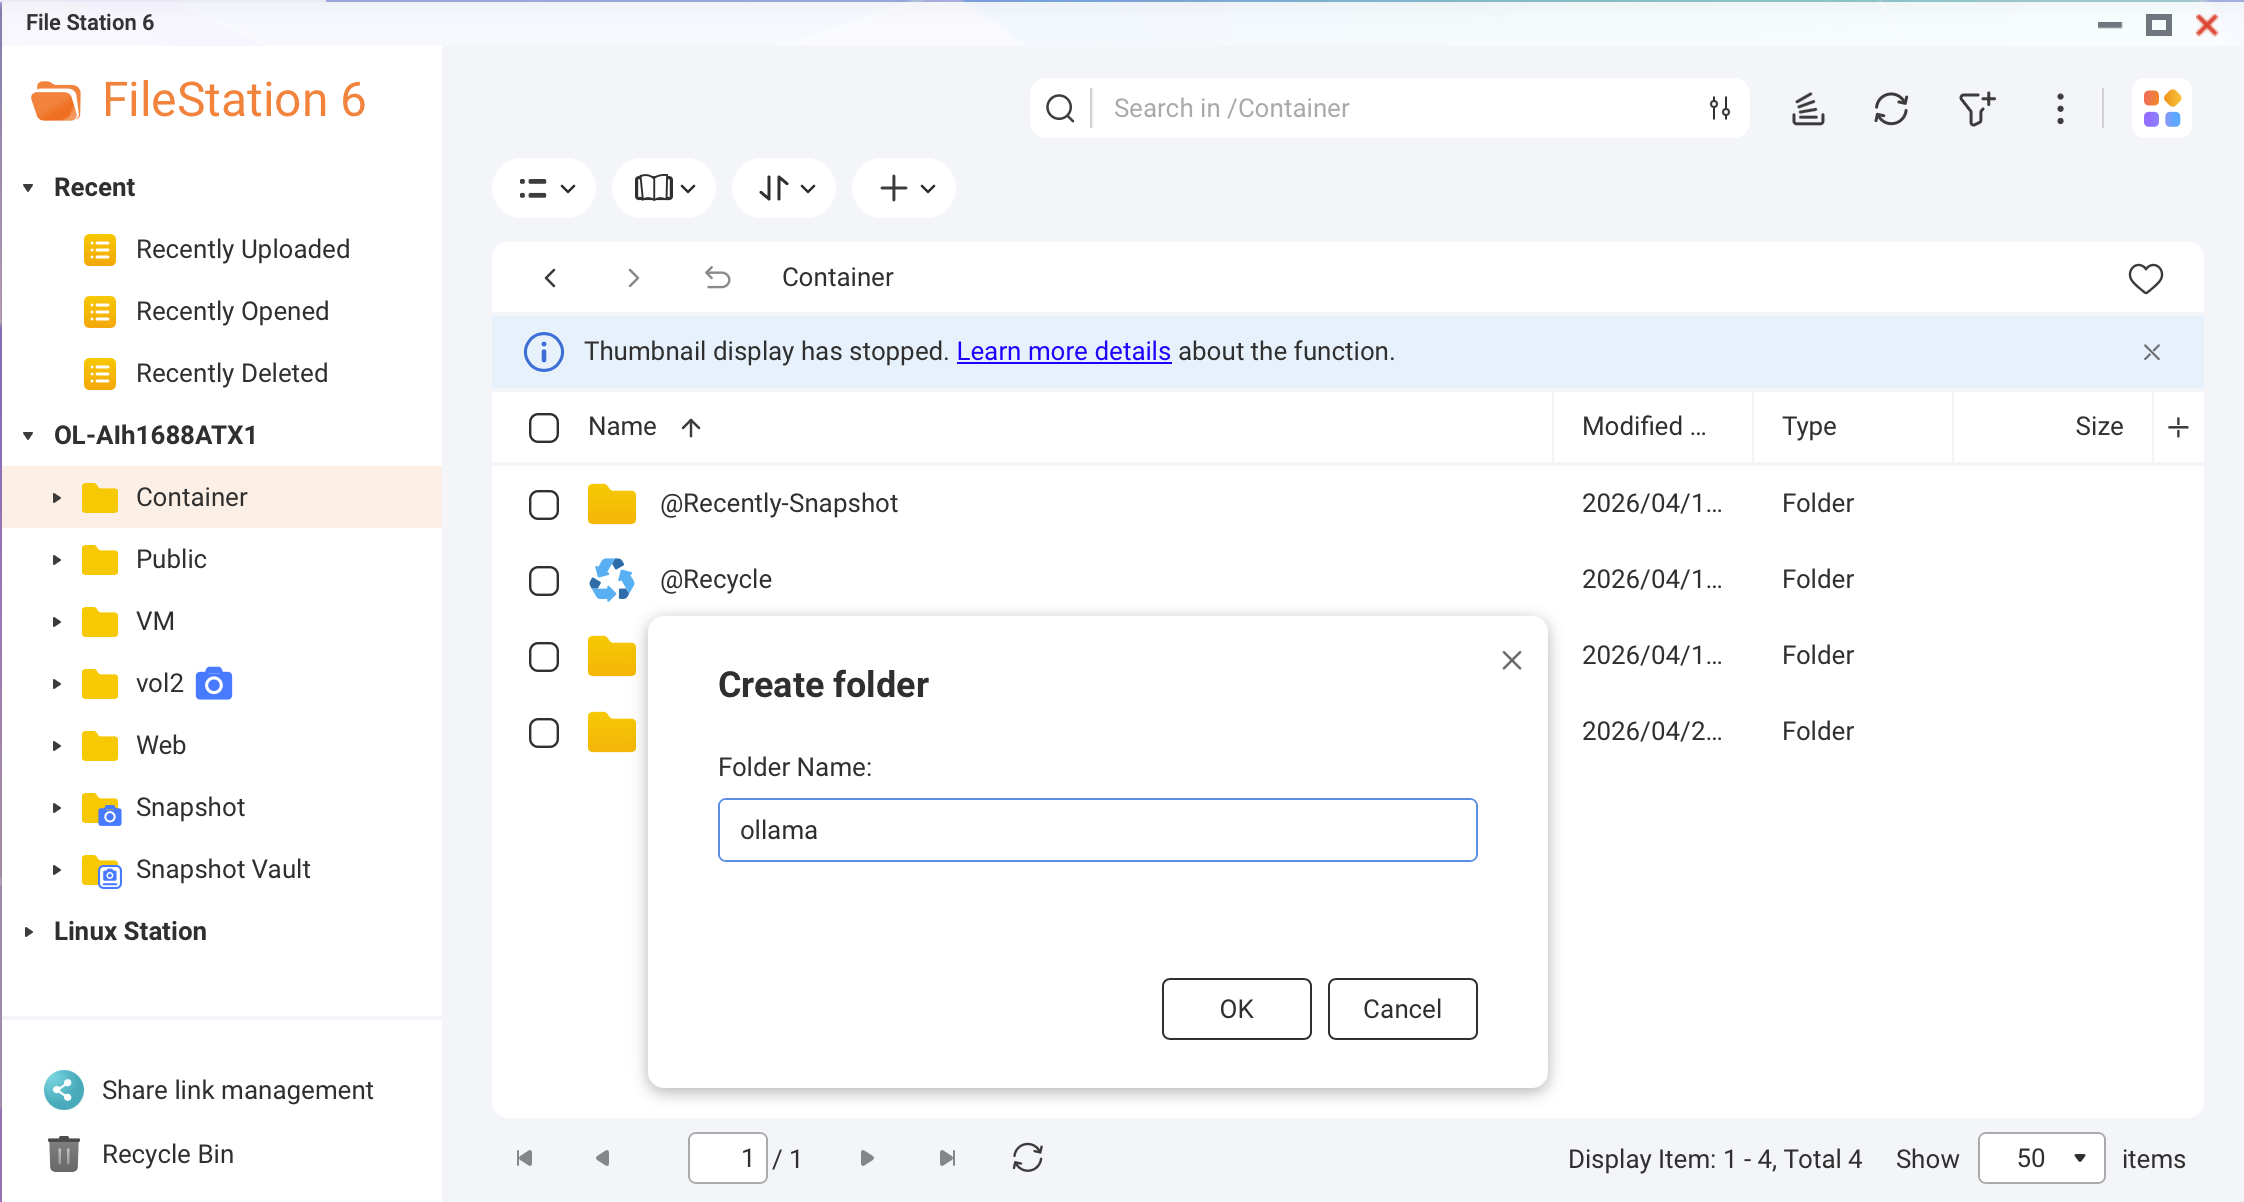 Zrzut ekranu: File Station — tworzenie folderu Ollama w /share/Container/Najlepsze praktykiJeśli Twój NAS ma pamięć podręczną NVMe SSD lub wolumin SSD, utwórz ten folder na SSD. Szybkość ładowania modelu poprawia się nawet 10-krotnie w porównaniu do HDD.
Utwórz plik Docker Compose.
W Container Station, przejdź do Aplikacje > Utwórz. Nazwij aplikację
ollamai wklej poniższy YAML:version: "3.8" services: ollama: image: ollama/ollama:latest container_name: ollama restart: unless-stopped ports: - "11434:11434" volumes: - /share/Container/ollama:/root/.ollama environment: - OLLAMA_HOST=0.0.0.0 - OLLAMA_KEEP_ALIVE=10m networks: - ai-network networks: ai-network: name: ai-network driver: bridge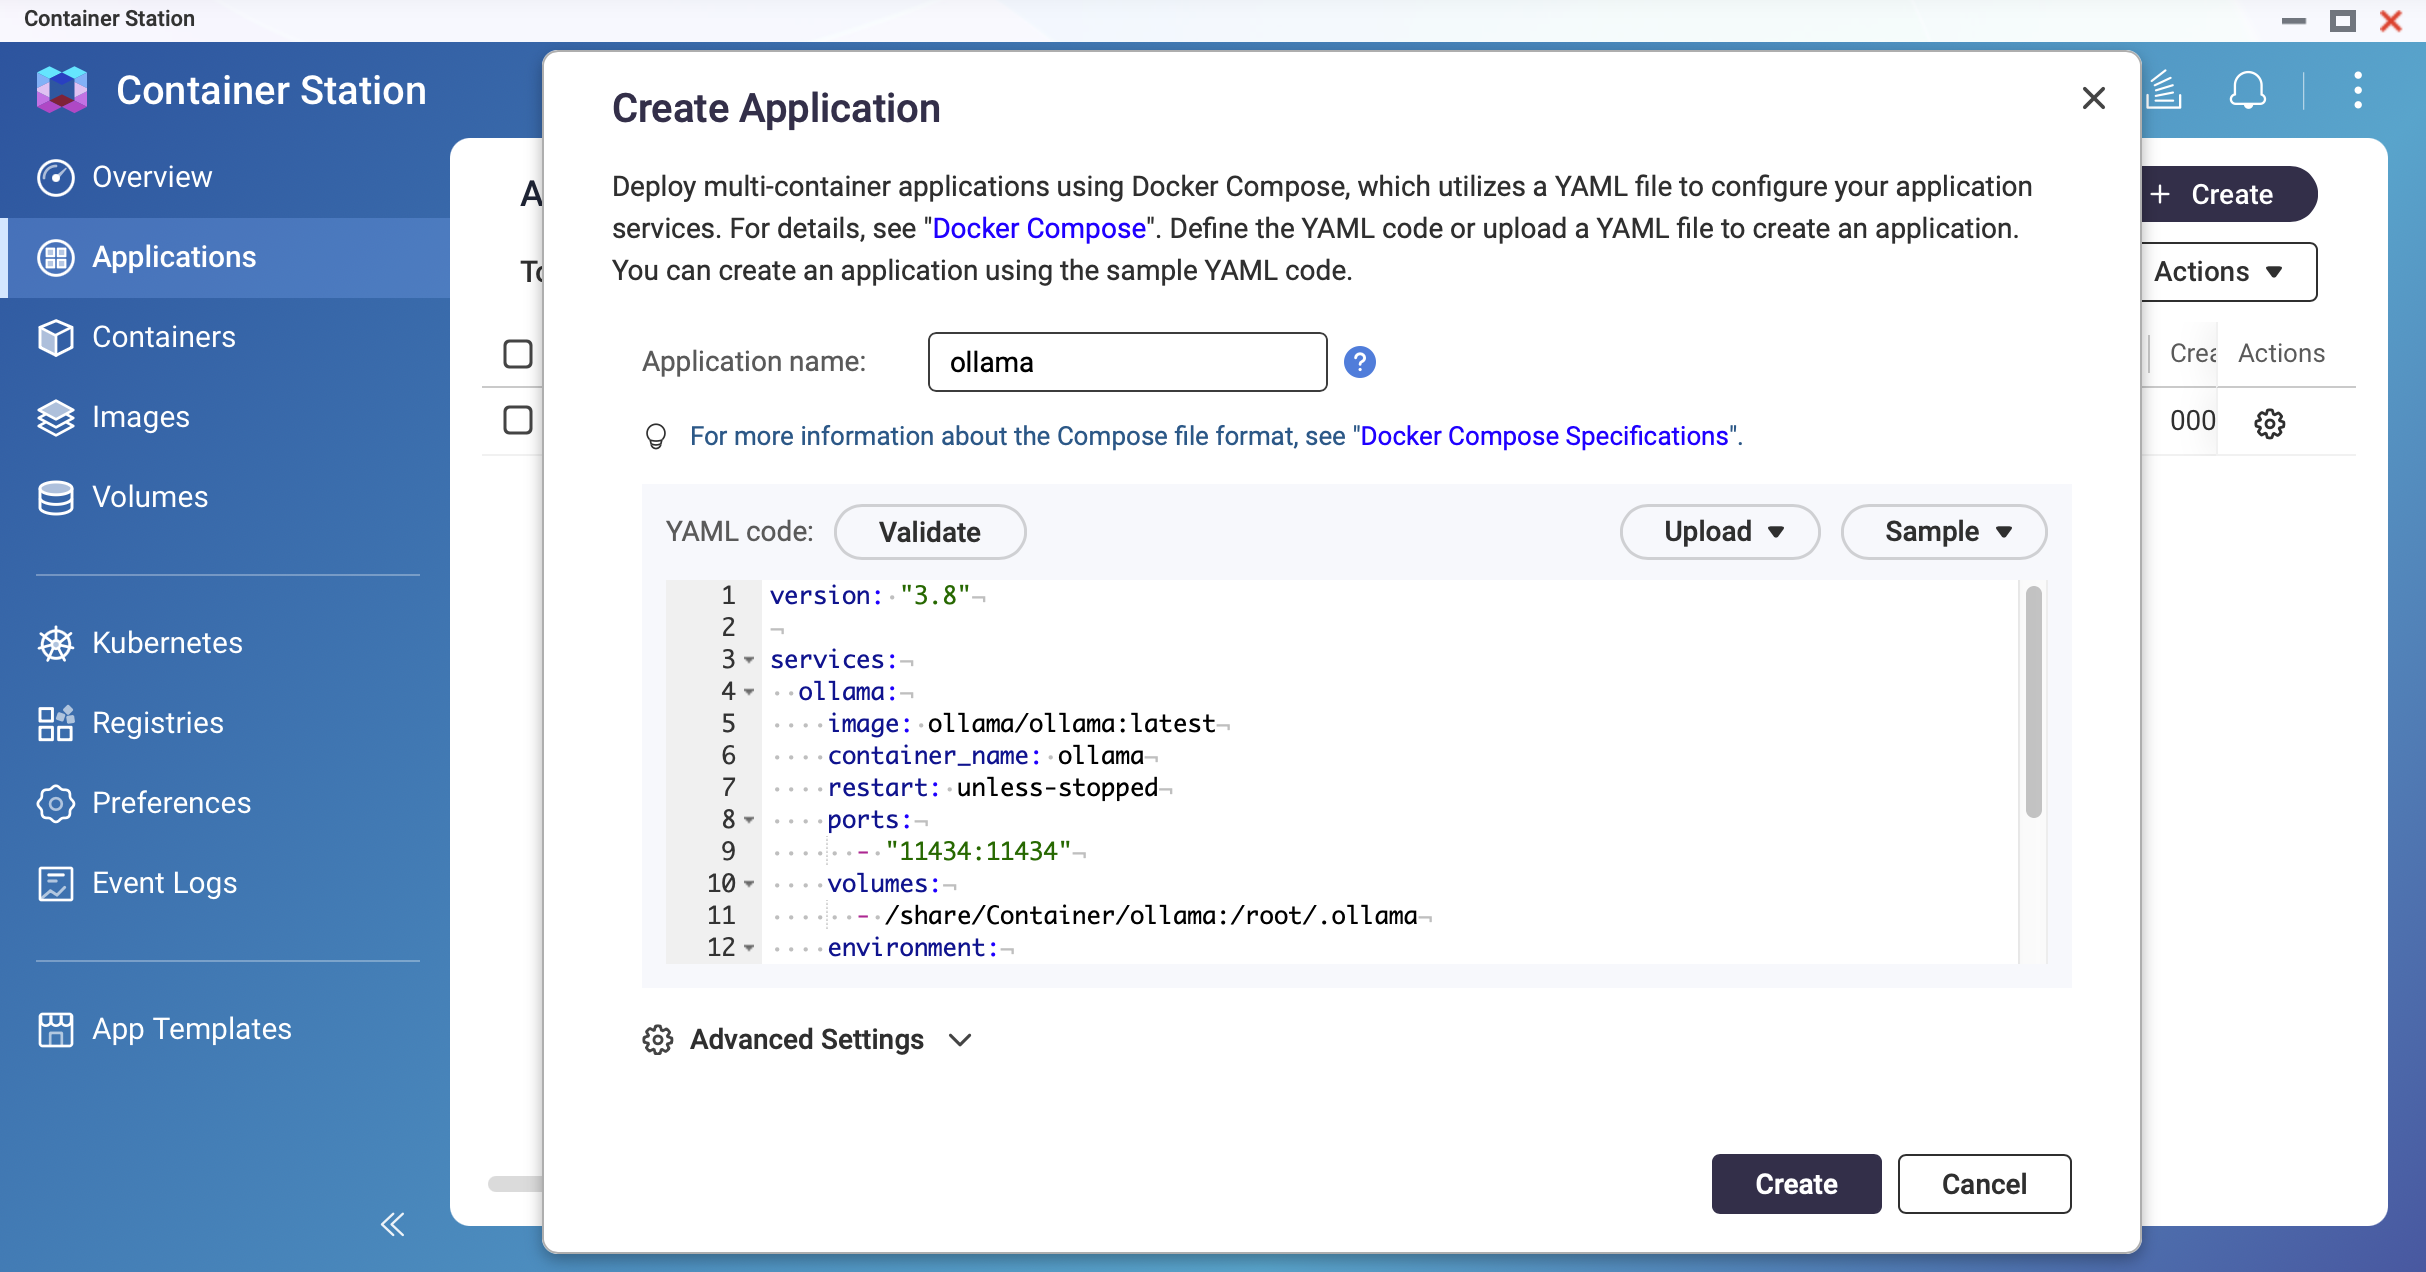 Zrzut ekranu: Container Station — ekran tworzenia aplikacji z edytorem YAML
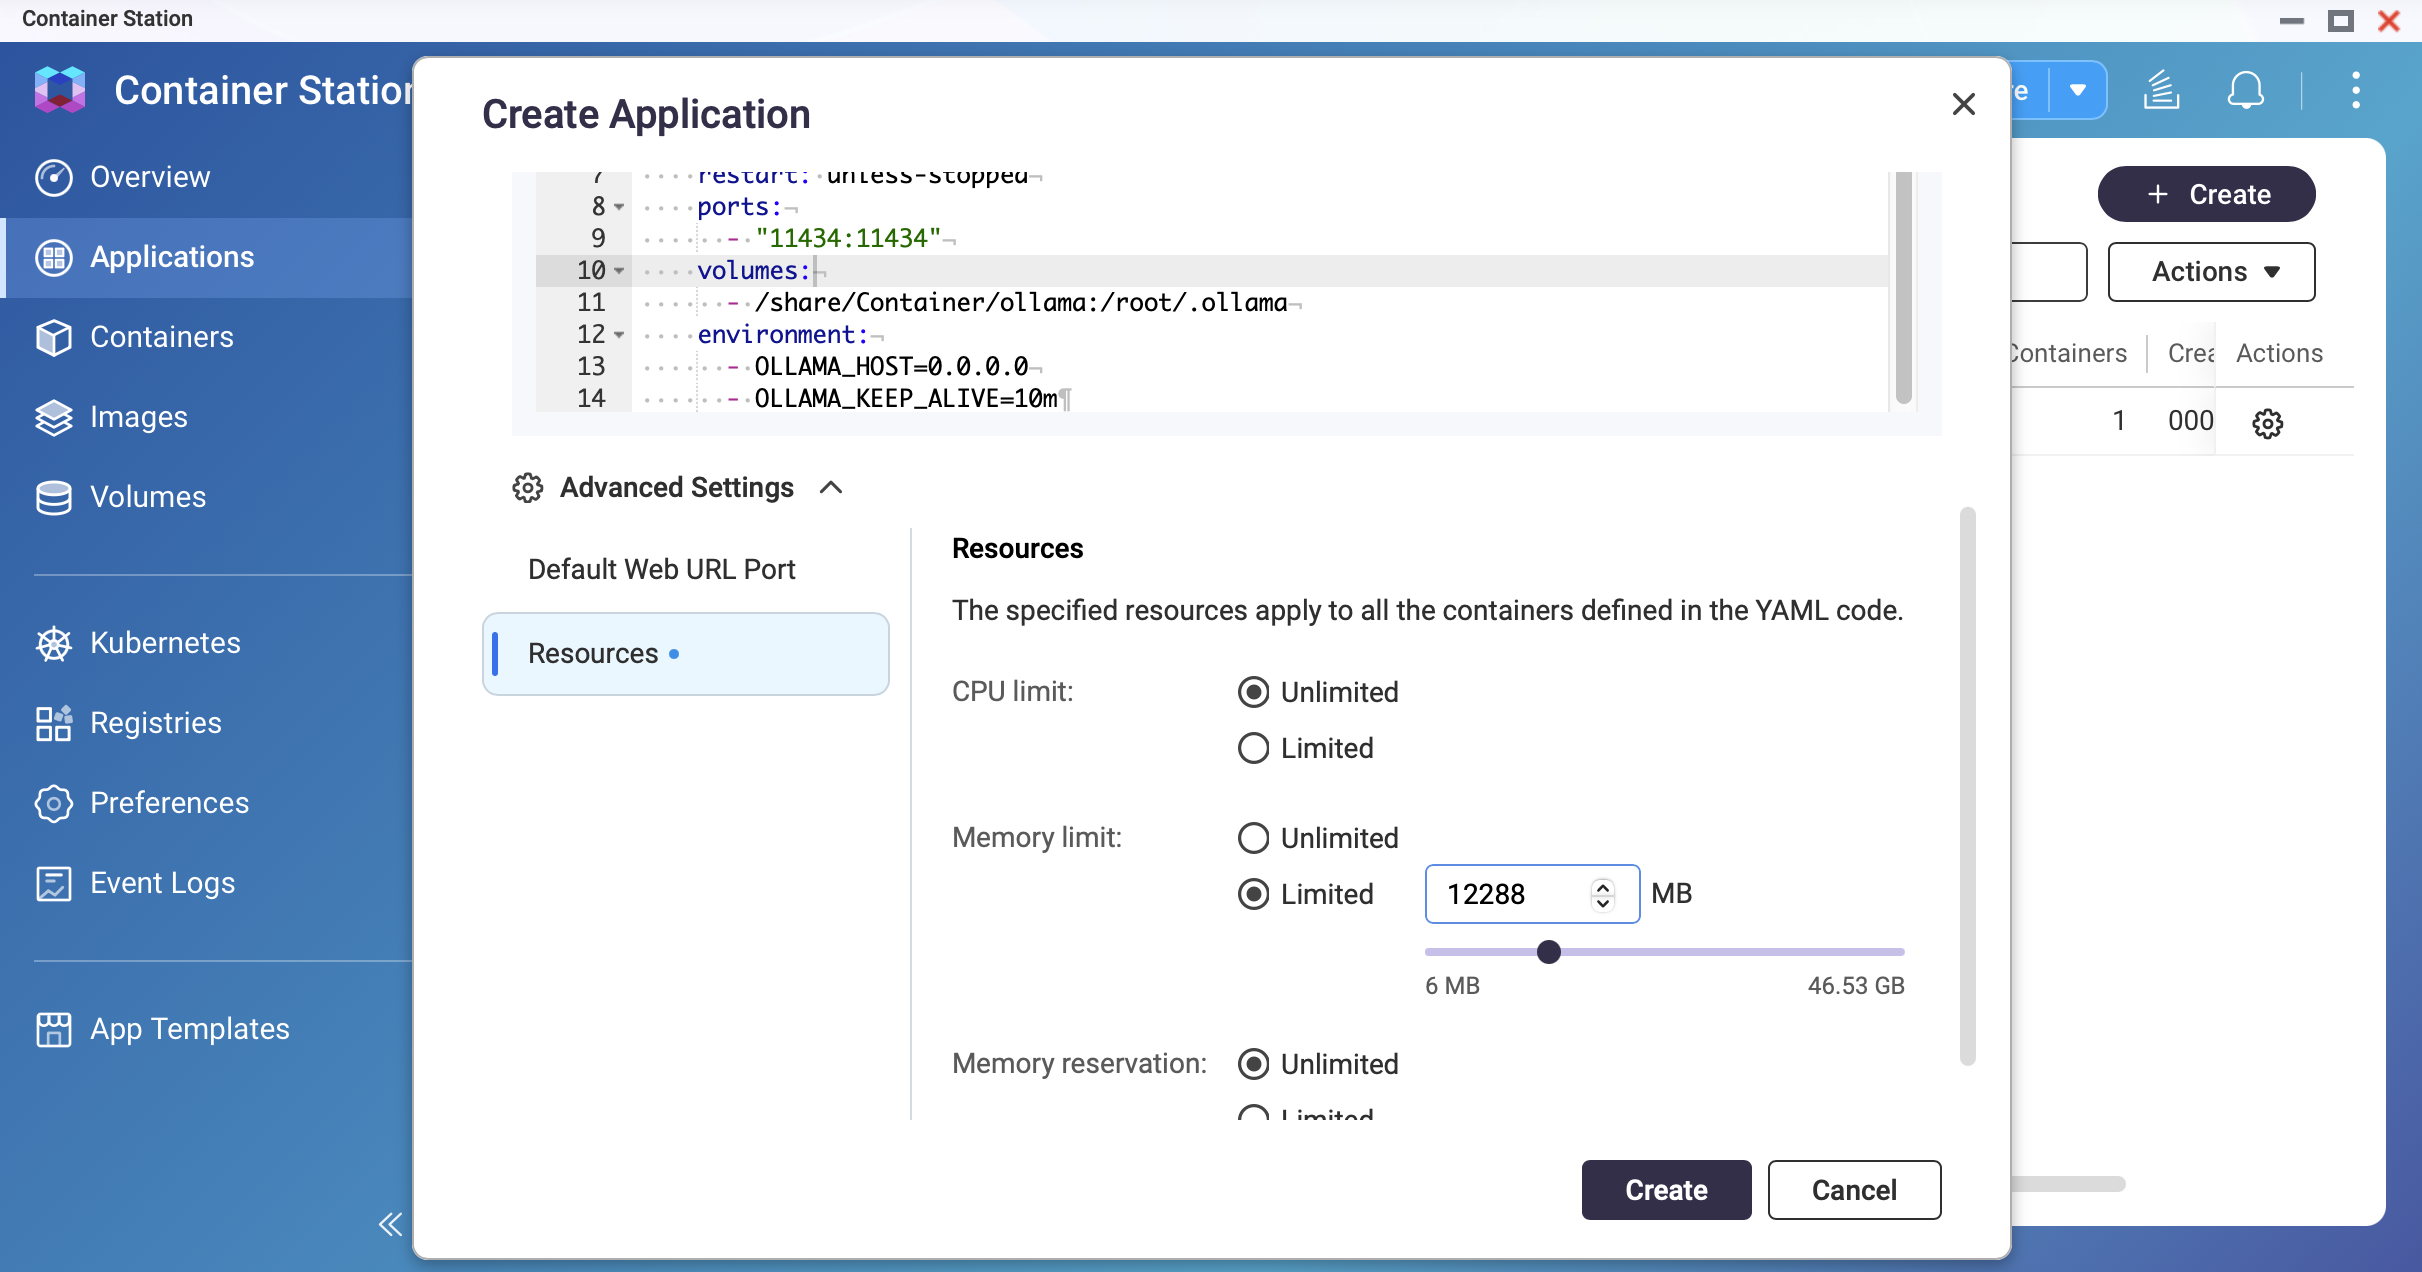 Zrzut ekranu: Container Station — ustawienie limitu pamięci
Wdróż kontener.
Kliknij Utwórz. Container Station pobierze obraz Ollama i uruchomi kontener. Poczekaj, aż status pokaże Uruchomiony.
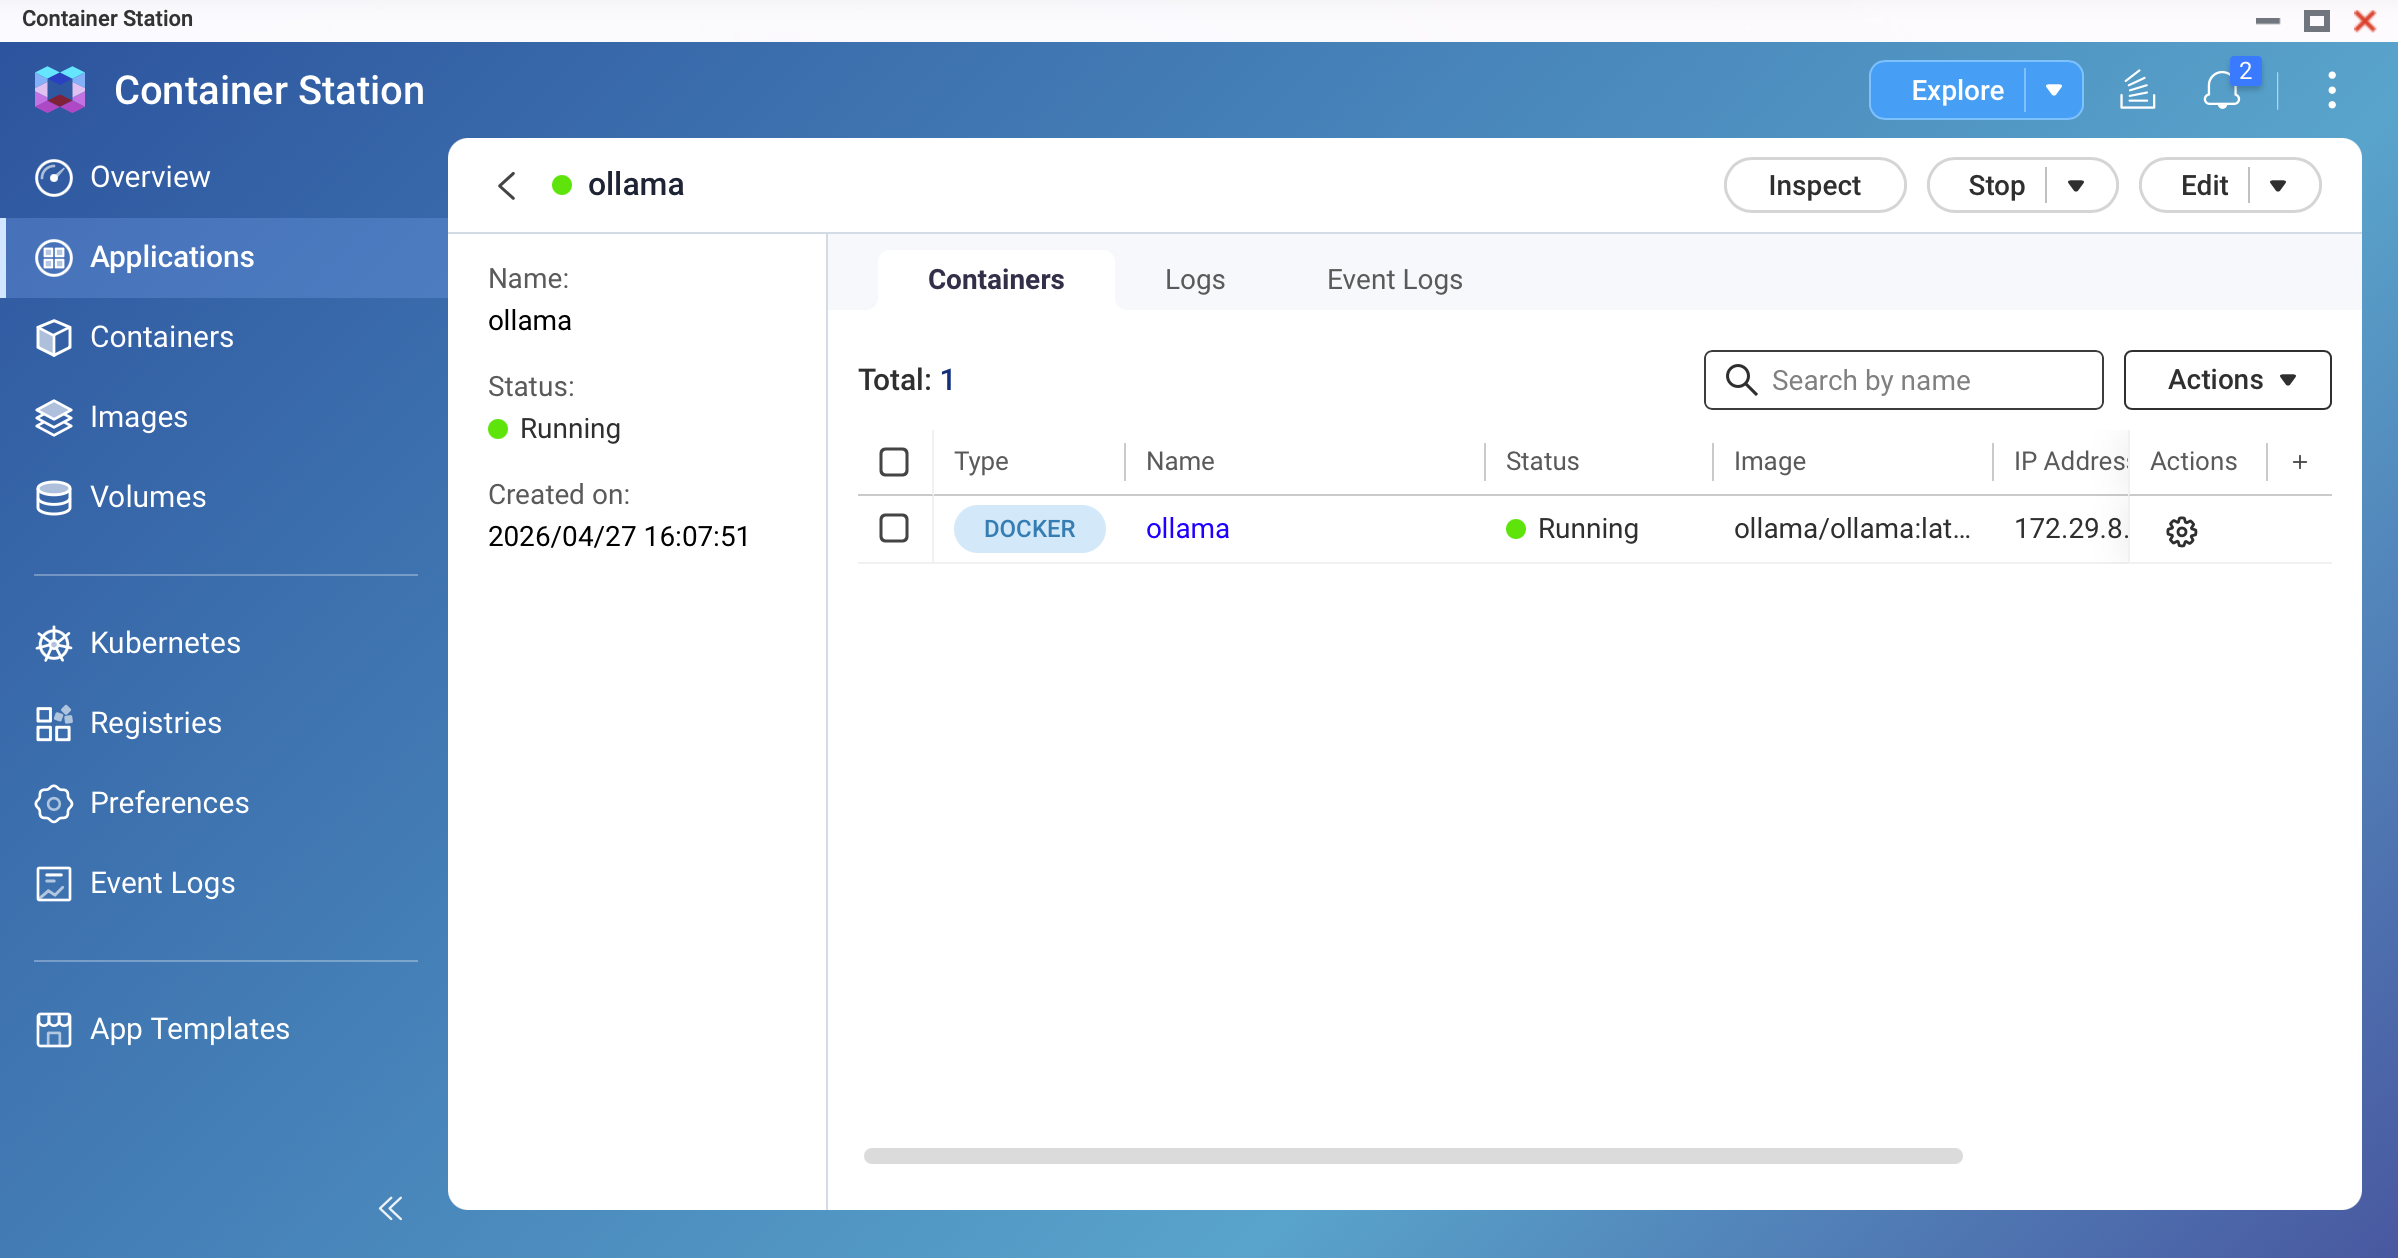 Zrzut ekranu: Container Station — kontener ollama pokazujący status "Uruchomiony"
Pobierz swój pierwszy model.
Otwórz Terminal kontenera (lub połącz się z NAS przez SSH i wykonaj Docker) i uruchom:
# Dla lekkiego modelu 3B (zalecane do pierwszego testu): ollama pull llama3.2:3b # Dla standardowego modelu 9B (wymaga 16 GB+ RAM): ollama pull qwen3.5:9bPobieranie może potrwać kilka minut w zależności od prędkości internetu. Model 9B Q4_K_M ma około 4–7 GB.
Uwaga- Sprawdź, czy masz wystarczającą ilość miejsca na dysku przed pobraniem. Użyj
ollama list, aby sprawdzić istniejące modele i ich rozmiary. - Dla modeli NAS opartych na ARM zalecamy rozpoczęcie od modelu <1B, aby monitorować użycie pamięci.
- Sprawdź, czy masz wystarczającą ilość miejsca na dysku przed pobraniem. Użyj
Przetestuj model.
W terminalu kontenera uruchom:
ollama run qwen3.5:9bWpisz polecenie i potwierdź, że otrzymujesz odpowiedź. Wpisz
/bye, aby zakończyć.
Metoda 2: Wdrożenie przyspieszone przez GPU NVIDIA
Dodatkowe wymagania w trybie GPU:
- Zainstalowany procesor GPU NVIDIA i wykryty przez QTS/QuTS hero
- Procesor GPU ustawiony na tryb Container Station w Panel sterowania
- Zainstalowany sterownik NVIDIA GPU i NvKernelDriver z App Center
Użyj konfiguracji Docker Compose z obsługą GPU.
Zastąp YAML z Metody 1 następującym:
version: "3.8" services: ollama: image: ollama/ollama:latest container_name: ollama restart: unless-stopped ports: - "11434:11434" volumes: - /share/Container/ollama:/root/.ollama environment: - OLLAMA_HOST=0.0.0.0 - OLLAMA_KEEP_ALIVE=10m - NVIDIA_VISIBLE_DEVICES=all deploy: resources: reservations: devices: - driver: nvidia count: all capabilities: [gpu] networks: - ai-network networks: ai-network: name: ai-network driver: bridge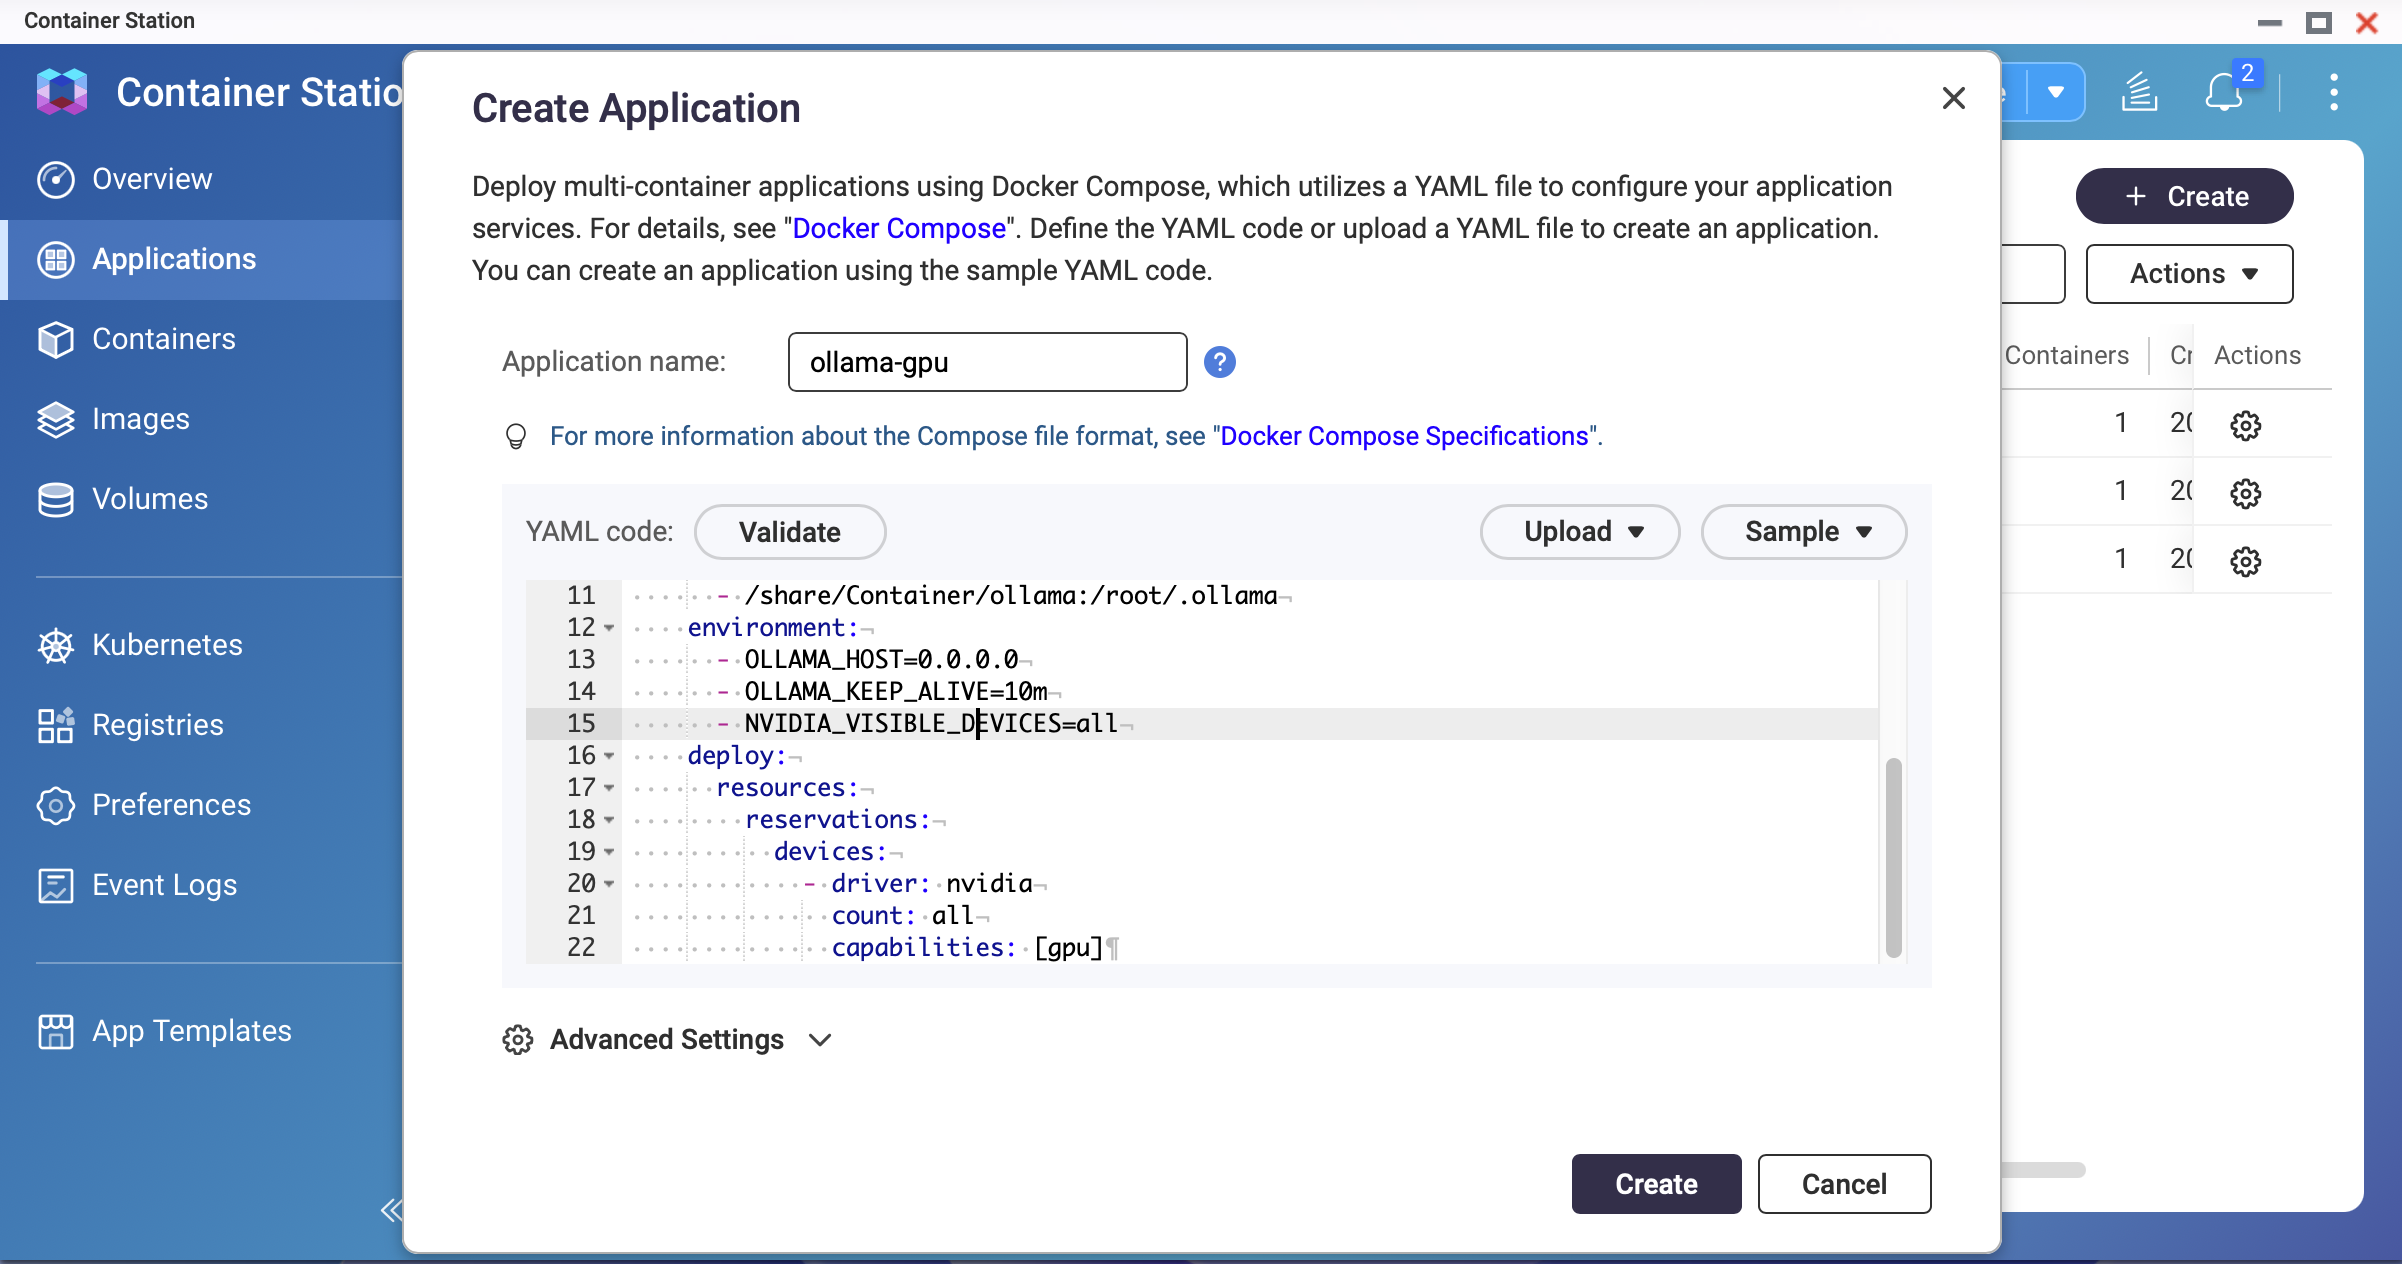 Zrzut ekranu: Container Station — YAML Compose z obsługą GPU DockerNotatkaSterowniki NVIDIA dostarczane przez QNAP mogą być starsze niż najnowsza wersja. Jeśli kontener nie uruchamia się z włączonym GPU, sprawdź wersję sterownika za pomocą
nvidia-smina hoście i upewnij się, że jest zgodna z wersją obrazu OllamaWdróż i zweryfikuj dostęp do GPU.
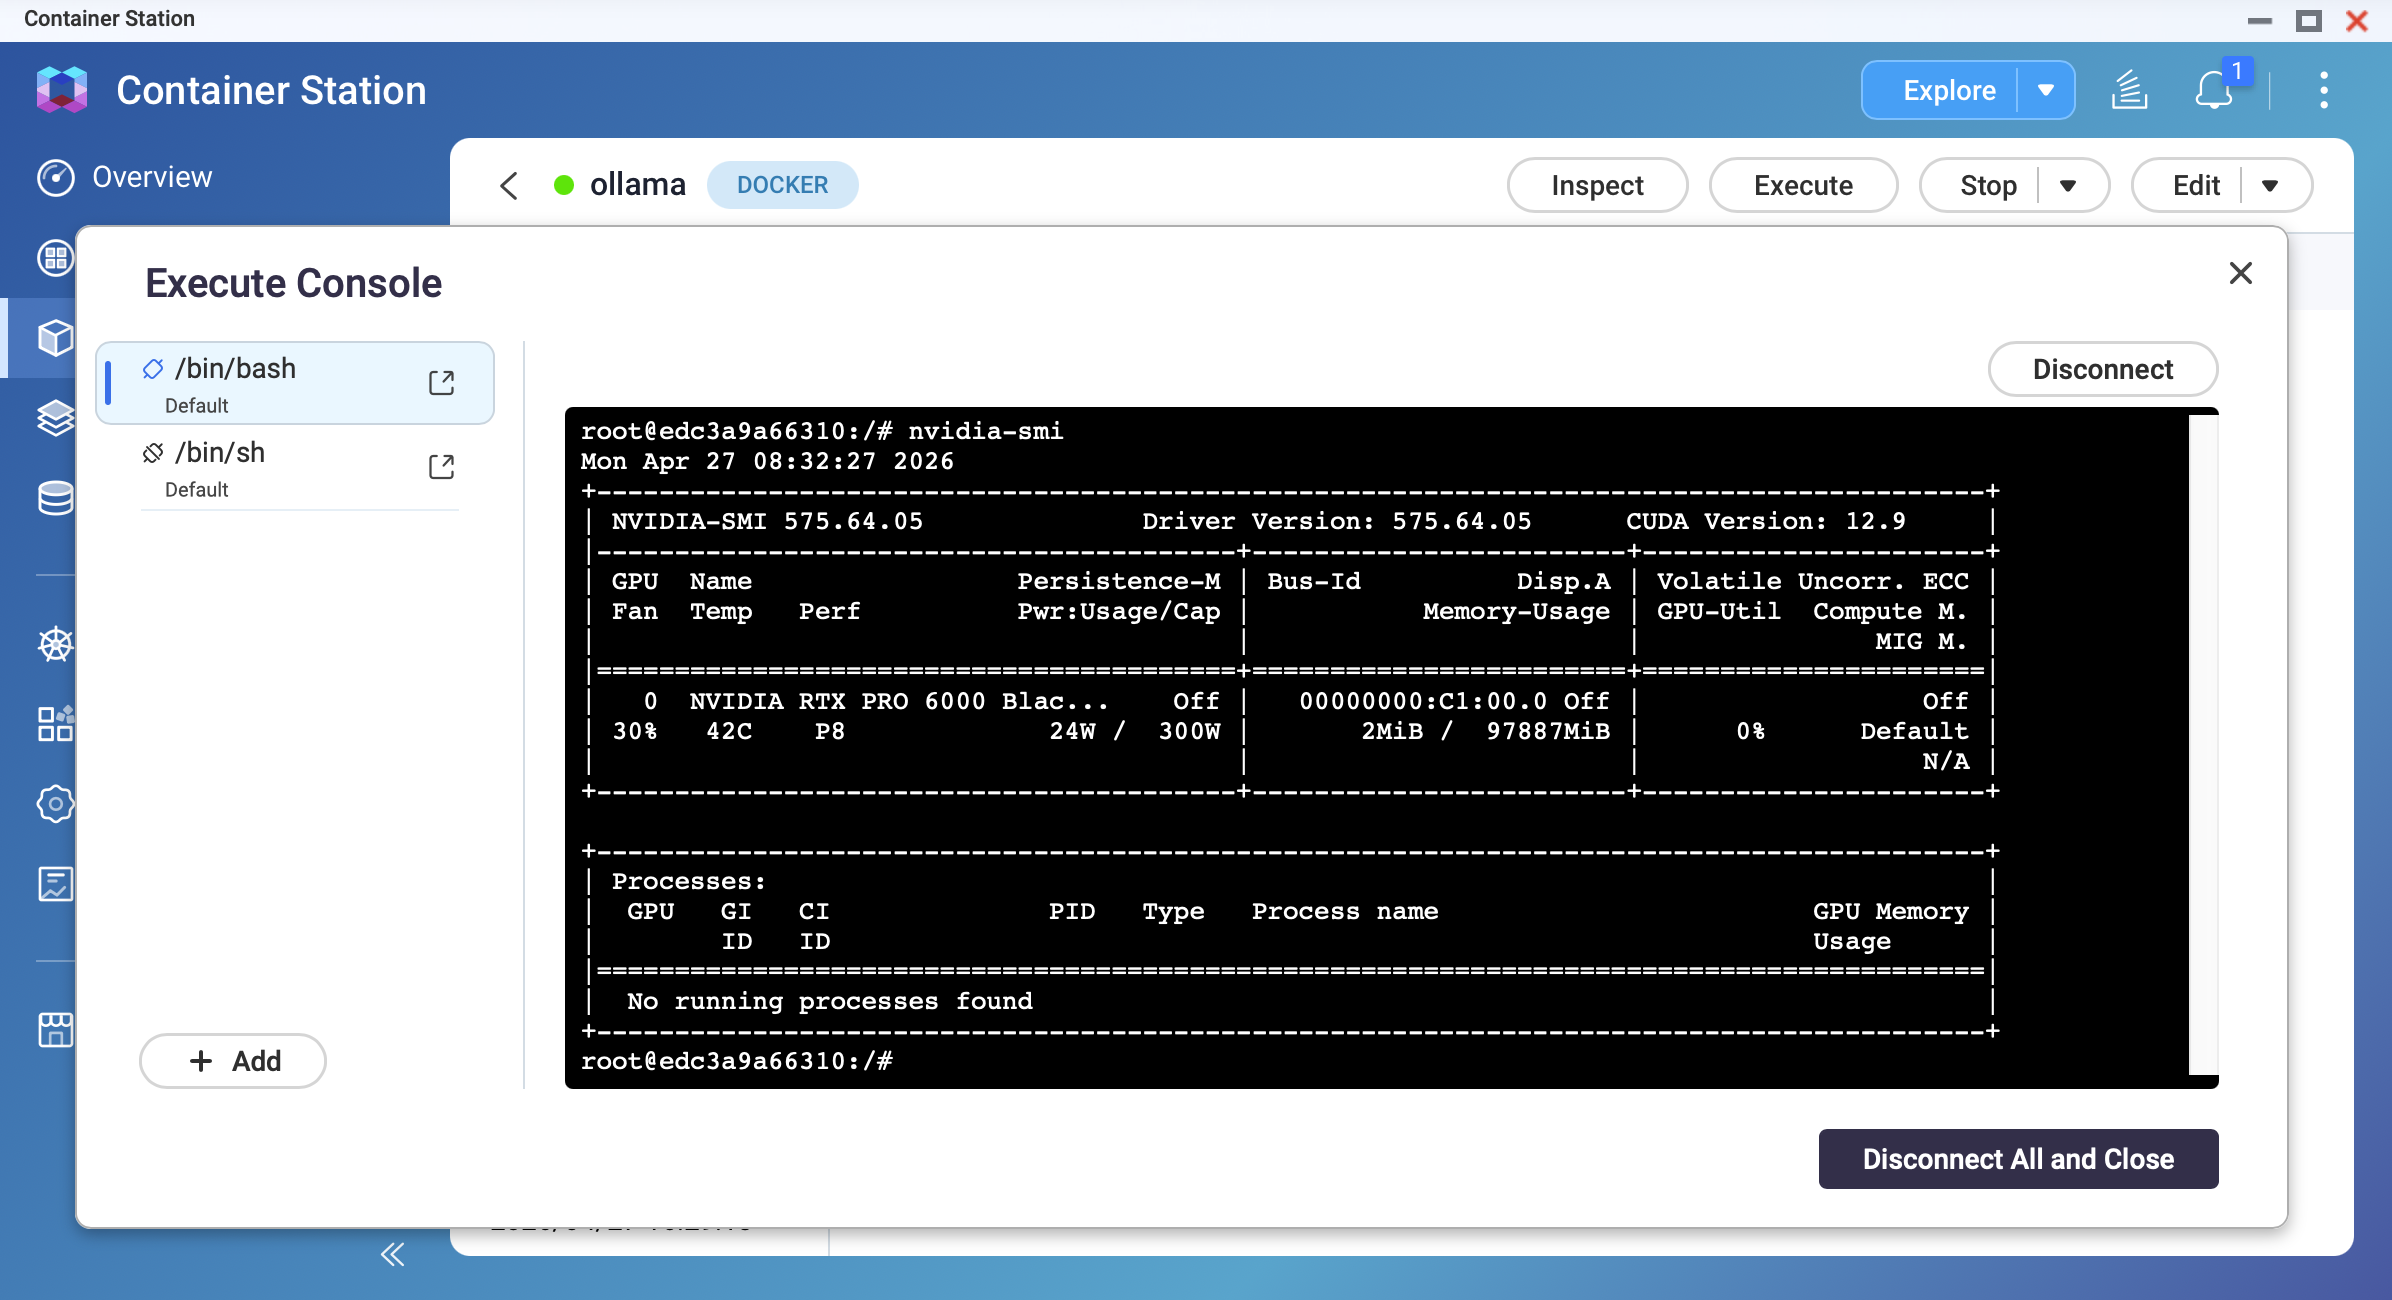
Po uruchomieniu kontenera otwórz jego terminal i uruchom:
nvidia-smiPowinieneś zobaczyć model swojego GPU, wersję sterownika i informacje o pamięci.
Pobierz model i potwierdź przyspieszenie GPU.
ollama pull qwen3.5:9b ollama run qwen3.5:9bPodczas generowania odpowiedzi przez model, otwórz kolejny terminal i uruchom
nvidia-smi. Powinieneś zaobserwować wzrost użycia pamięci GPU i wykorzystania GPU.
Rezultat
Po ukończeniu tego samouczka będziesz mieć:
- Ollama działające na Twoim serwerze QNAP NAS pod adresem
http://<NAS-IP>:11434 - Dane modelu zapisane w
/share/Container/ollama(przetrwają przebudowy kontenera) - Działający LLM dostępny przez API Ollama
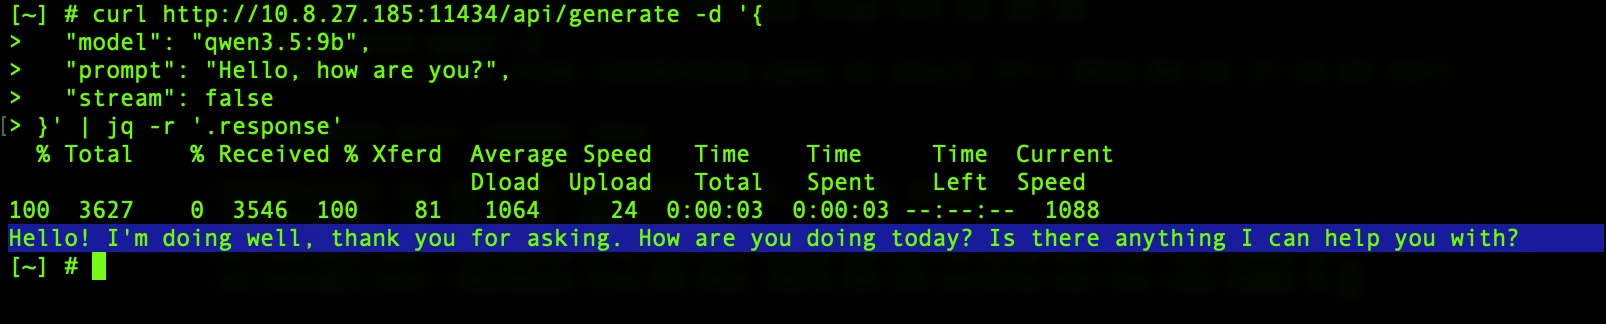
Możesz przetestować API z dowolnego urządzenia w swojej lokalnej sieci:
curl http://<NAS-IP>:11434/api/generate -d '{
  "model": "qwen3.5:9b",
  "prompt": "Hello, how are you?",
  "stream": false
}'
OLLAMA_HOST=0.0.0.0 udostępnia API Ollama na wszystkich interfejsach sieciowych. Nie udostępniaj portu 11434 w Internecie. Użyj reguł Zapora lub ustawień sieciowych QNAP, aby ograniczyć dostęp tylko do lokalnej sieci.Rozwiązywanie problemów
Kontener kończy działanie natychmiast po uruchomieniu
Może to być spowodowane niewystarczającą ilością pamięci RAM lub niezgodnością sterownika GPU. Sprawdź logi kontenera w Container Station. Zmniejsz ograniczenia pamięci lub wyłącz tryb GPU.
Pobieranie modelu kończy się w połowie
Może to wynikać z niewystarczającej ilości miejsca na dysku lub przekroczenia czasu sieciowego. Spróbuj zwolnić miejsce w Pamięć masowa. Ponownie uruchom ollama pull; system wznowi działanie od miejsca, w którym się zatrzymał.
Szybkość odpowiedzi jest bardzo wolna (1–3 tokeny na sekundę)
Model może działać na CPU zamiast na GPU lub model jest zbyt duży dla Twojej pamięci RAM. Zweryfikuj dostęp do GPU za pomocą nvidia-smi wewnątrz kontenera. Spróbuj użyć mniejszego modelu.
Serwer NAS staje się nieodpowiedzialny podczas inferencji
Może to być problem z "brakiem pamięci": model zużywa całą pamięć systemową. Zalecamy ponowne uruchomienie serwera NAS. Ustaw limit użycia pamięci w aplikacji. Lub użyj mniejszego modelu.
Komunikat "Nie można połączyć się z Ollama" z Open WebUI
Może to być spowodowane błędnym adresem URL API lub izolacją sieci Docker. Możesz użyć http://ollama:11434, jeśli jesteś w tej samej sieci Docker.
Aby uzyskać dalszą pomoc, zapytaj innych użytkowników i ekspertów QNAP na forum społeczności. Przejdź do społeczności QNAP


