


วิธีการติดตั้ง Ollama บน QNAP NAS โดยใช้ Container Station
ผลิตภัณฑ์ที่รองรับ
QTS, QuTS hero
Container Station
กรณีใช้งาน
คุณต้องการรันโมเดลภาษาขนาดใหญ่ (LLMs) ในเครื่องบน QNAP NAS ของคุณสำหรับการแชท AI ส่วนตัว, การช่วยเหลือด้านโค้ด, หรือการวิเคราะห์เอกสารโดยไม่ต้องส่งข้อมูลไปยังคลาวด์ Ollama เป็นเอนจินการอนุมานที่ได้รับความนิยมและเหมาะสำหรับผู้เริ่มต้นมากที่สุดสำหรับวัตถุประสงค์นี้ บทแนะนำนี้อธิบายวิธีการปรับใช้ Ollama บน QNAP NAS โดยใช้ Container Station
ข้อกำหนดของระบบ
| ข้อกำหนด | รายละเอียด |
|---|---|
| แอป QNAP | Container Station 3.x หรือใหม่กว่า |
| สถาปัตยกรรม NAS | x86_64 (Intel หรือ AMD CPU) (รองรับเฉพาะบางรุ่นที่ใช้ ARM) |
| หน่วยความจำ |
|
| พื้นที่ ที่เก็บข้อมูล |
|
| GPU (ไม่บังคับ) | GPU ของ NVIDIA ที่รองรับ (ดูที่ รายการความเข้ากันได้) GPU ควรถูกตั้งค่าเป็นโหมด Container Station ใน แผงควบคุม |
Ollama จะพยายามโหลดโมเดลทั้งหมดเข้าสู่หน่วยความจำโดยค่าเริ่มต้น หาก NAS ของคุณมี RAM เพียง 8–16 GB การโหลดโมเดล 14B หรือใหญ่กว่าอาจทำให้หน่วยความจำระบบหมด ส่งผลให้บริการ NAS ไม่ตอบสนองหรือระบบรีสตาร์ท
ความเสี่ยงในการสูญหายของข้อมูล
หากคุณไม่ติดตั้งโวลุ่มถาวรสำหรับ
/root/.ollama โมเดลและการตั้งค่าที่ดาวน์โหลดทั้งหมดจะสูญหายเมื่อคอนเทนเนอร์ถูกลบหรือสร้างใหม่ ควรปฏิบัติตามคำแนะนำการติดตั้งโวลุ่มในบทแนะนำนี้เสมอ- ตรวจสอบขนาดของโมเดลกับ RAM ที่มีอยู่ล่วงหน้า
- ตั้งค่าขีดจำกัดหน่วยความจำเพื่อจำกัดการใช้งานหน่วยความจำของคอนเทนเนอร์
- เริ่มต้นด้วยโมเดลขนาดเล็ก (1B หรือ 3B) และประเมินความเสถียรของระบบก่อนลองใช้โมเดลขนาดใหญ่
ขั้นตอน
วิธีที่ 1: การปรับใช้ด้วย CPU เท่านั้น (ไม่ต้องใช้ GPU)
สร้างโฟลเดอร์ ที่เก็บข้อมูล
เปิด File Station และสร้างโฟลเดอร์ต่อไปนี้เพื่อเก็บข้อมูลโมเดล Ollama:
/share/Container/ollama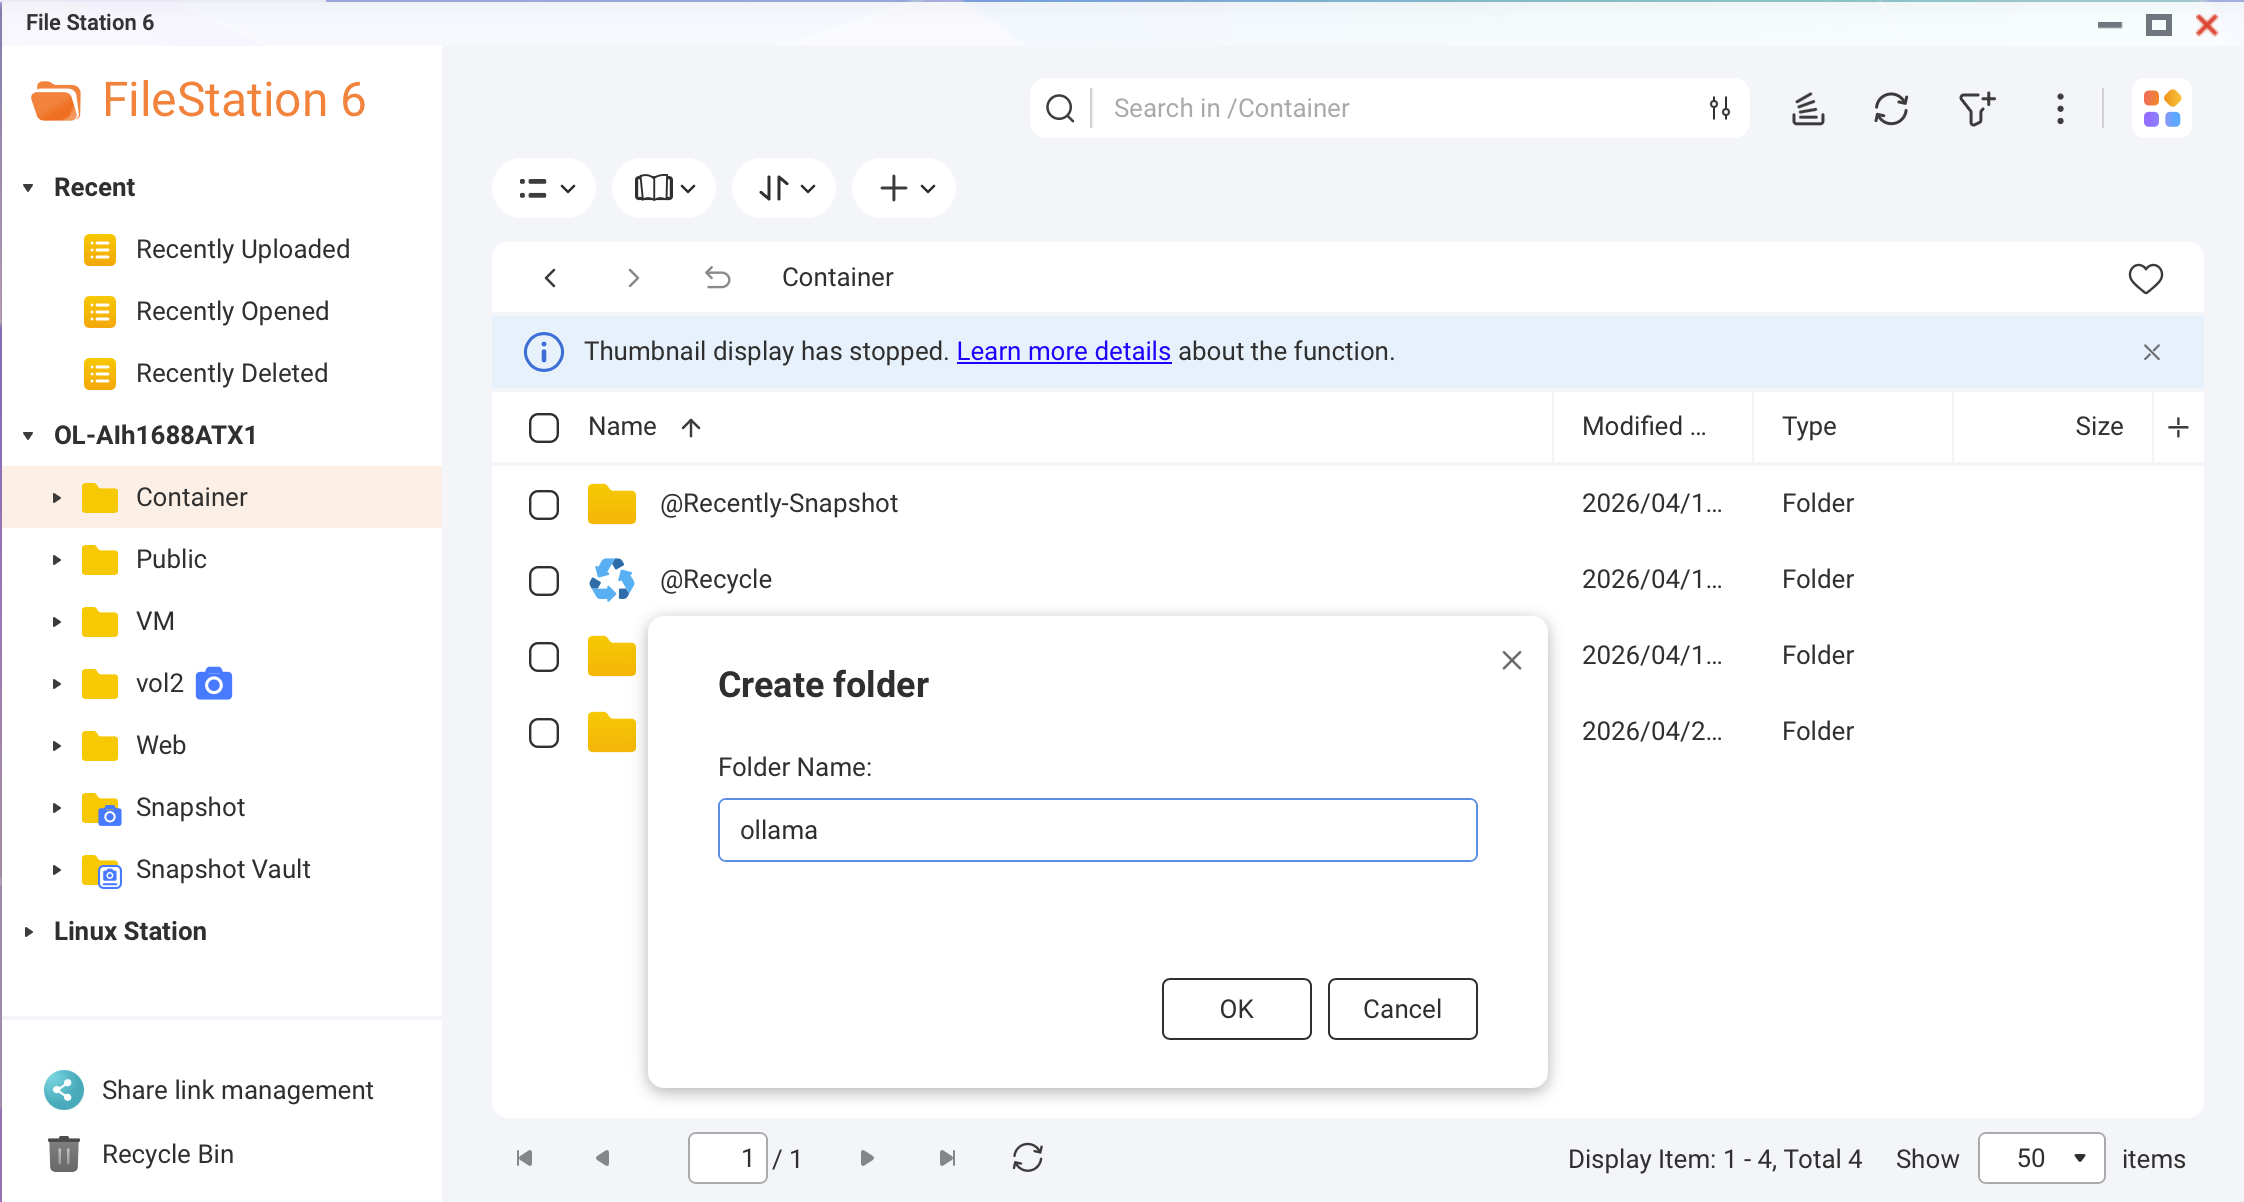 ภาพหน้าจอ: File Station — การสร้างโฟลเดอร์ Ollama ภายใต้ /share/Container/แนวทางปฏิบัติที่ดีที่สุดหาก NAS ของคุณมี NVMe SSD cache หรือ SSD volume ให้สร้างโฟลเดอร์นี้บน SSD ความเร็วในการโหลดโมเดลจะเพิ่มขึ้นถึง 10 เท่าเมื่อเทียบกับ HDD
สร้างไฟล์ Docker Compose
ใน Container Station ไปที่ Applications > Create ตั้งชื่อแอปพลิเคชัน
ollamaและวาง YAML ต่อไปนี้:version: "3.8" services: ollama: image: ollama/ollama:latest container_name: ollama restart: unless-stopped ports: - "11434:11434" volumes: - /share/Container/ollama:/root/.ollama environment: - OLLAMA_HOST=0.0.0.0 - OLLAMA_KEEP_ALIVE=10m networks: - ai-network networks: ai-network: name: ai-network driver: bridge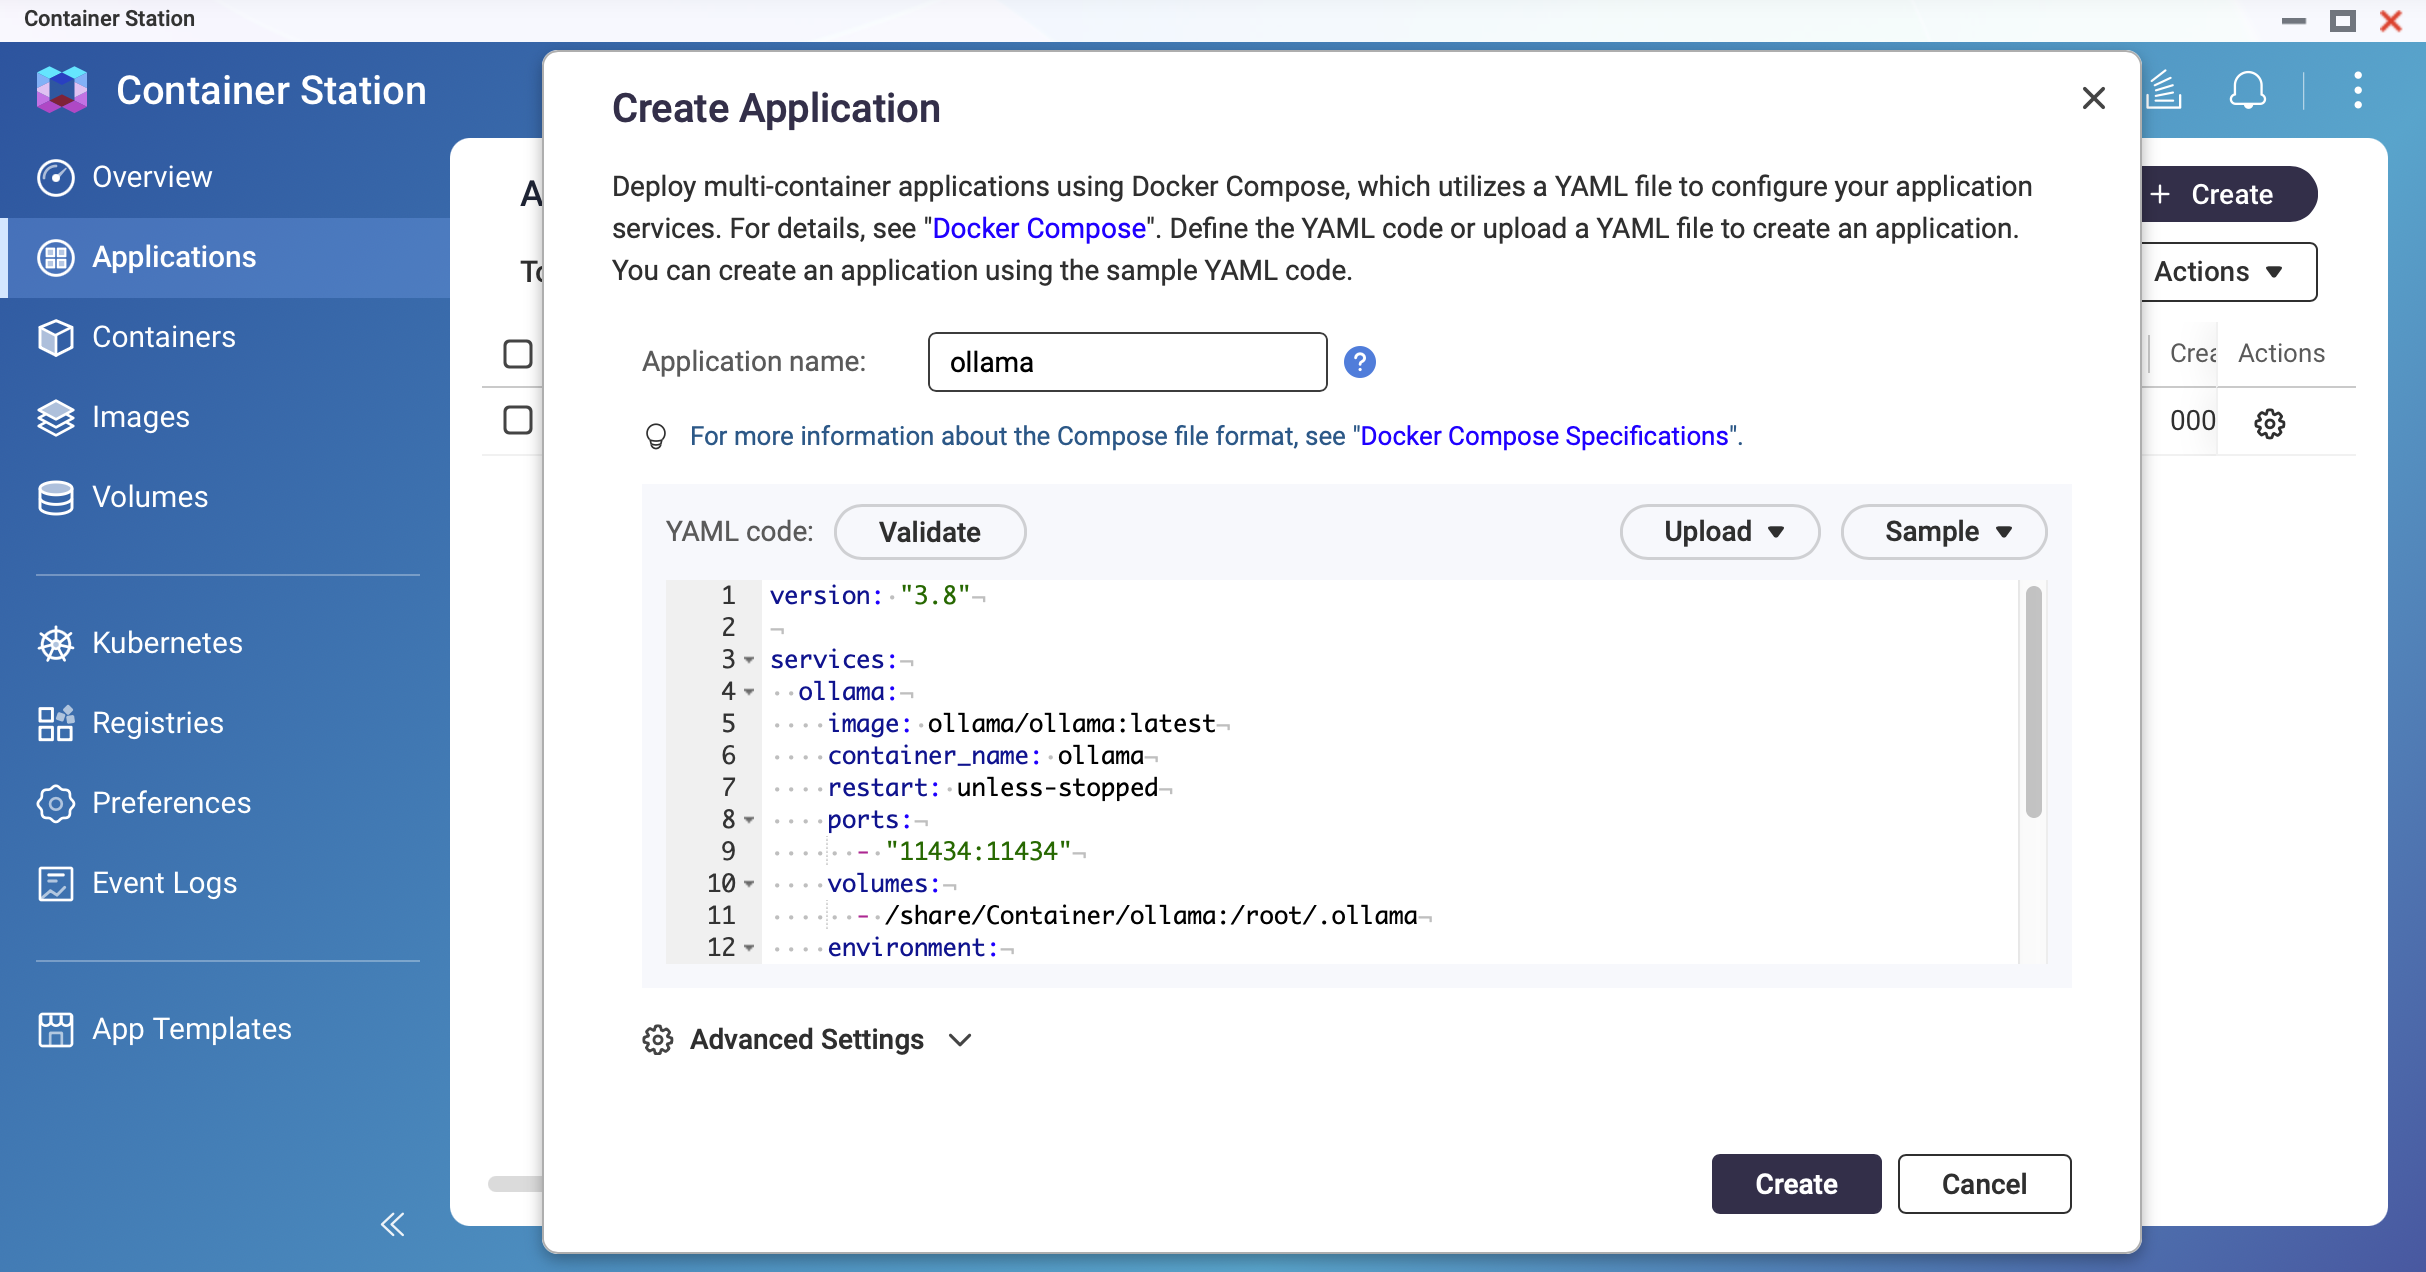 ภาพหน้าจอ: Container Station — หน้าจอการสร้างแอปพลิเคชันพร้อมตัวแก้ไข YAML
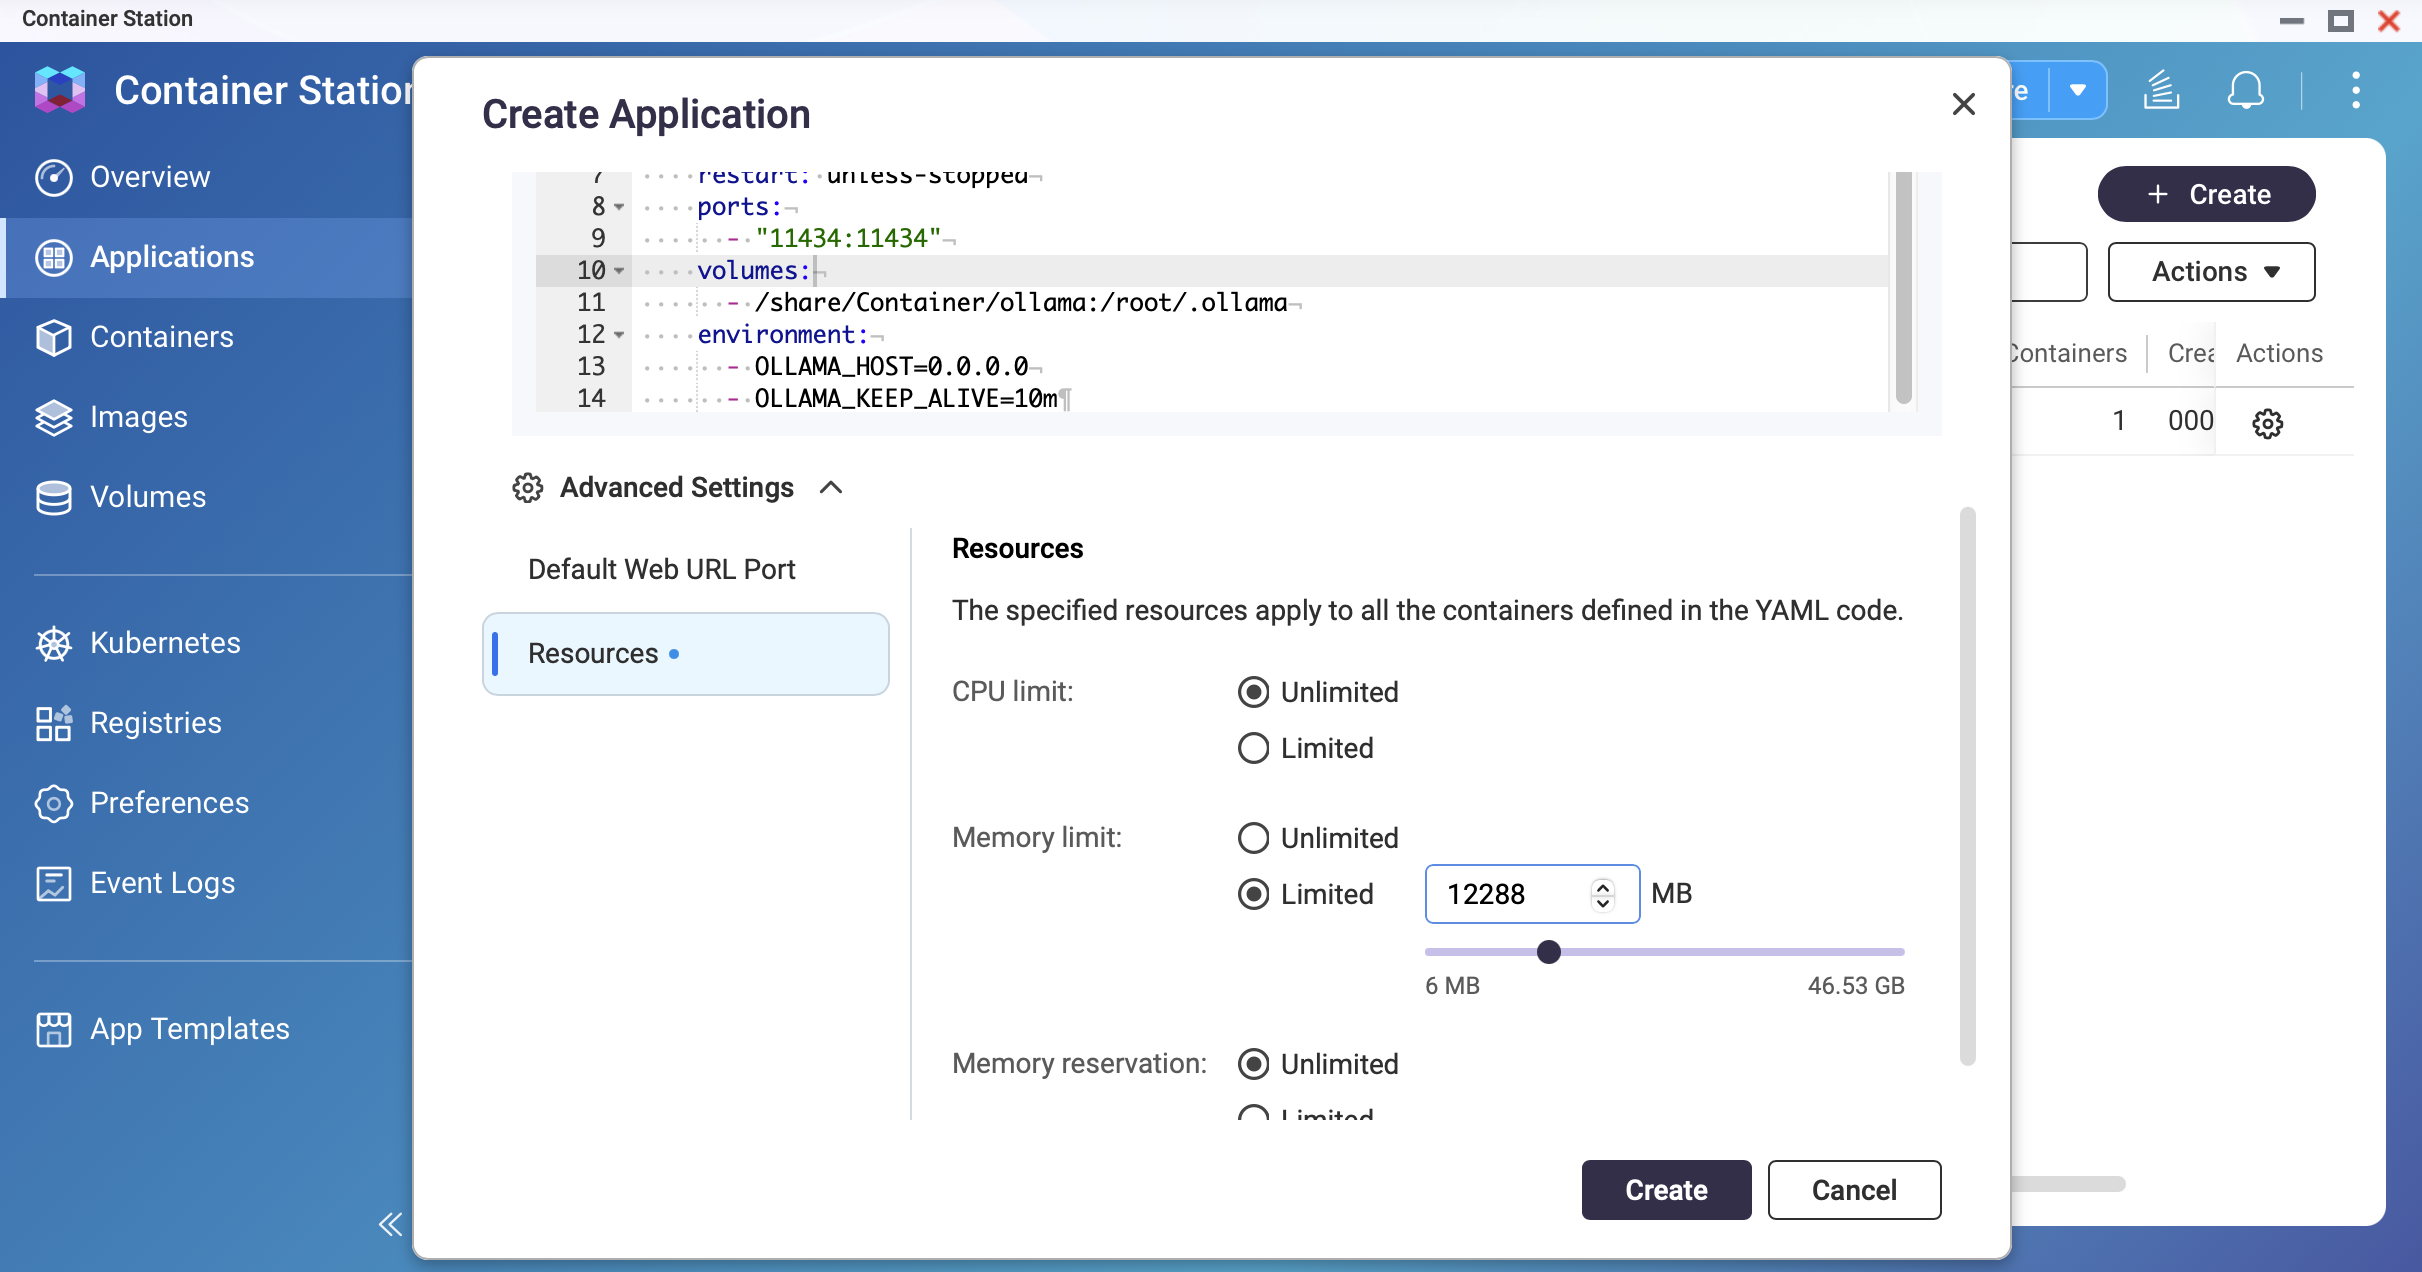 ภาพหน้าจอ: Container Station — ตั้งค่าขีดจำกัดหน่วยความจำ
ปรับใช้คอนเทนเนอร์
คลิก Create. Container Station จะดึงภาพ Ollama และเริ่มคอนเทนเนอร์ รอจนกว่าสถานะจะแสดง Running.
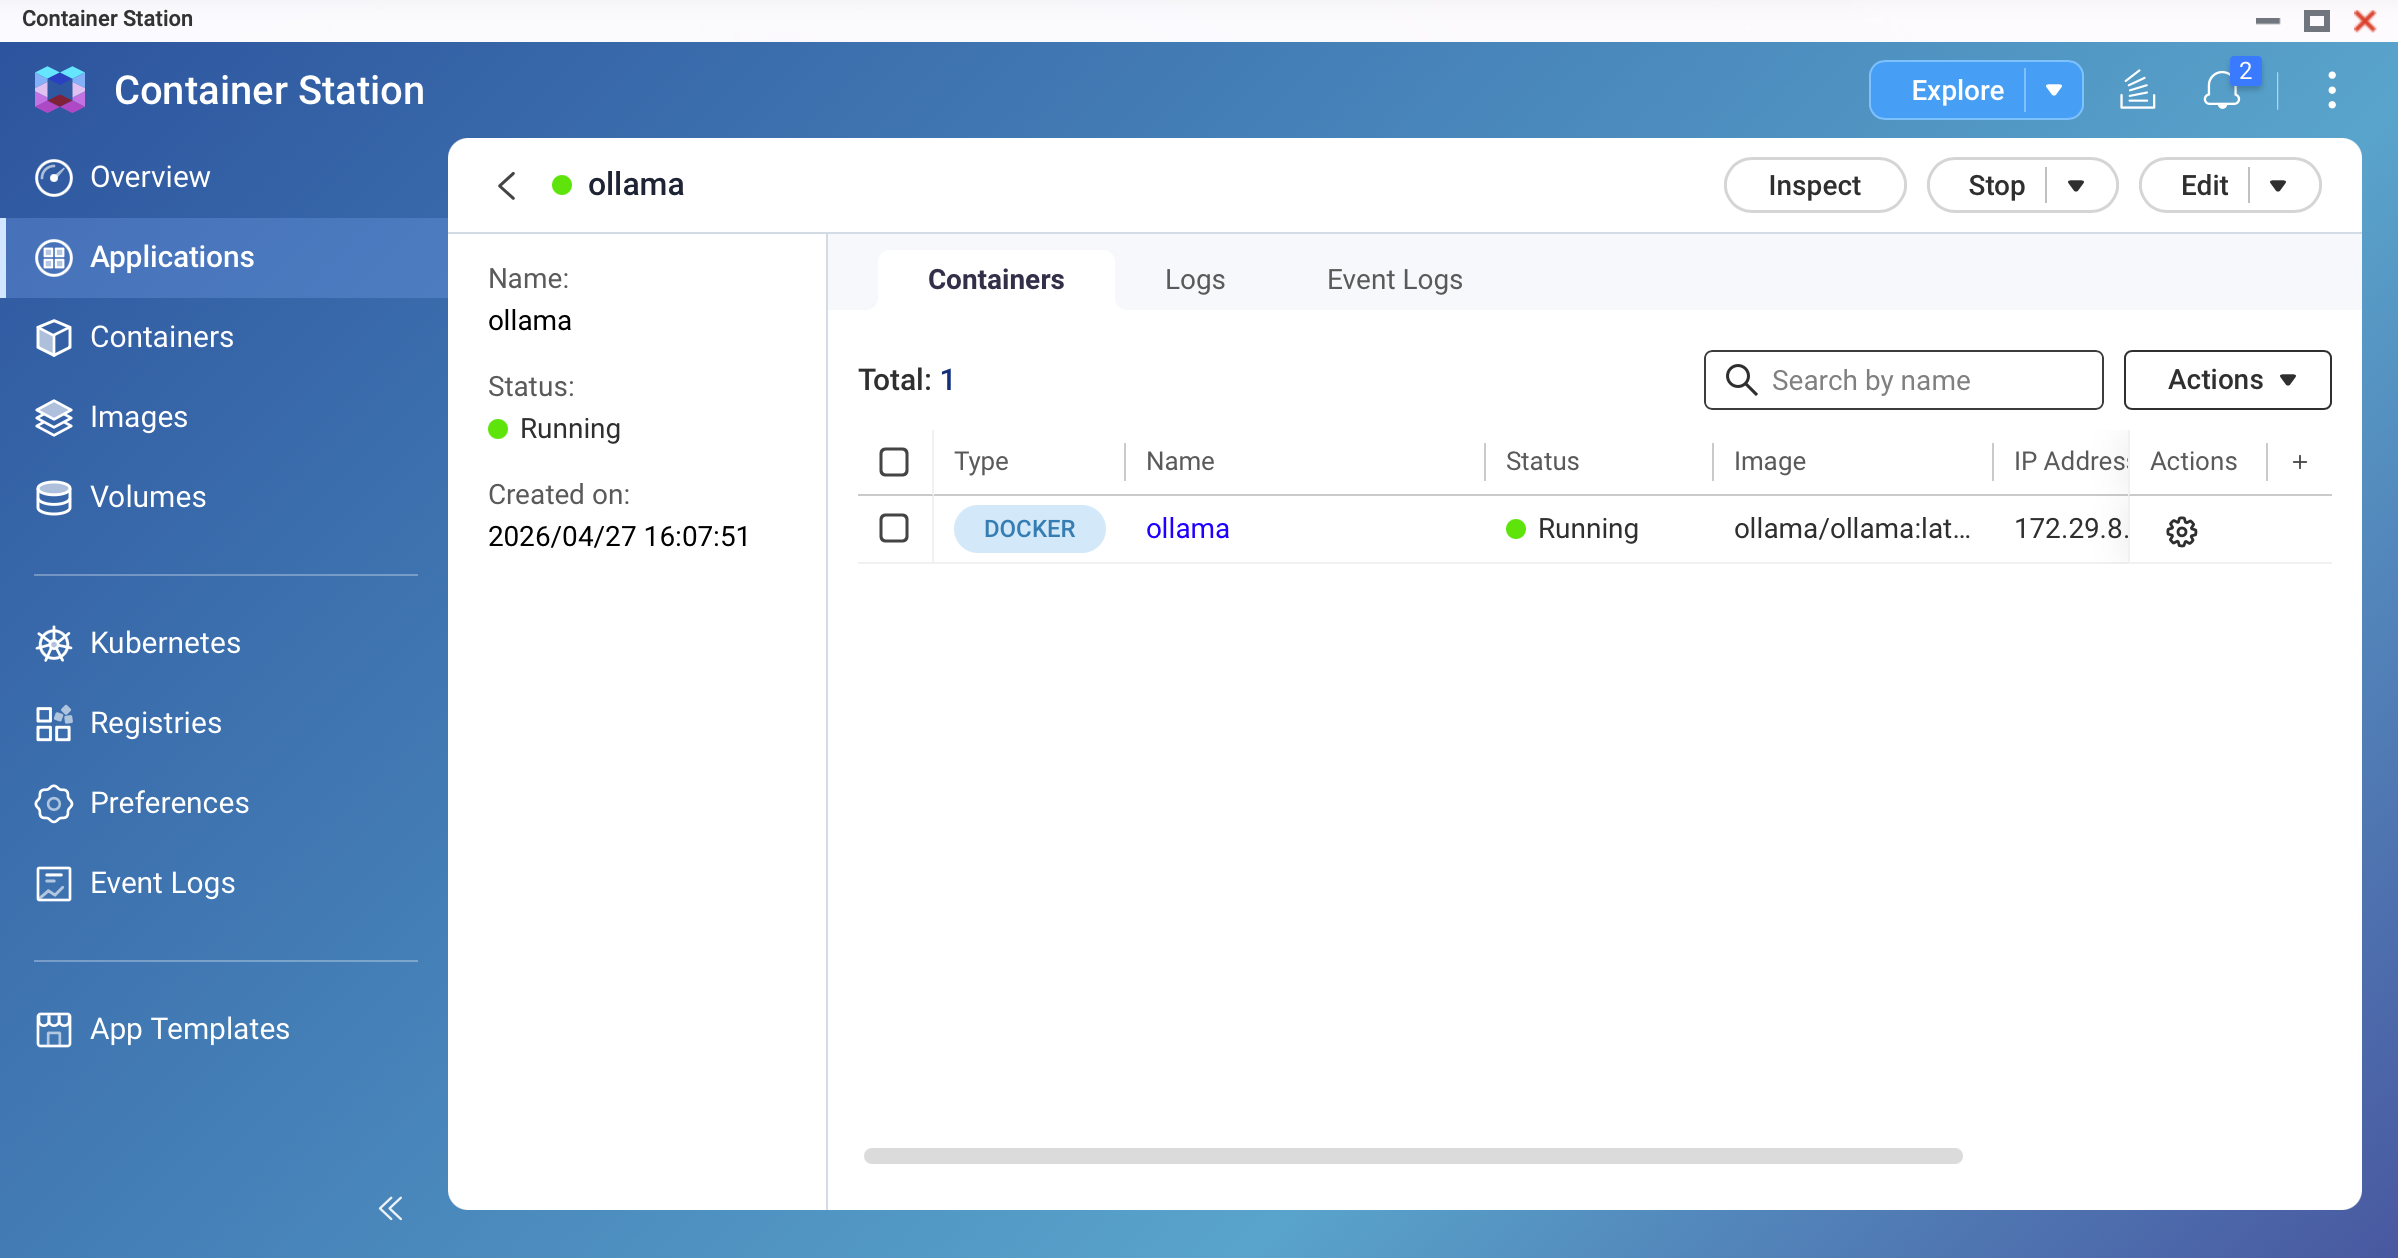 ภาพหน้าจอ: Container Station — คอนเทนเนอร์ ollama แสดงสถานะ "Running"
ดึงโมเดลแรกของคุณ
เปิด Terminal ของคอนเทนเนอร์ (หรือ SSH เข้า NAS ของคุณและ exec คุณ Docker) และรัน:
# สำหรับโมเดล 3B ที่เบา (แนะนำสำหรับการทดสอบครั้งแรก): ollama pull llama3.2:3b # สำหรับโมเดล 9B มาตรฐาน (ต้องการ RAM 16 GB ขึ้นไป): ollama pull qwen3.5:9bการดาวน์โหลดอาจใช้เวลาหลายนาทีขึ้นอยู่กับความเร็วอินเทอร์เน็ตของคุณ โมเดล 9B Q4_K_M มีขนาดประมาณ 4–7 GB.
หมายเหตุ- ตรวจสอบว่าคุณมีพื้นที่ดิสก์เพียงพอก่อนดึง ใช้
ollama listเพื่อตรวจสอบโมเดลที่มีอยู่และขนาดของมัน - สำหรับโมเดล NAS ที่ใช้ ARM เราแนะนำให้เริ่มต้นด้วยโมเดล <1B เพื่อตรวจสอบการใช้งานหน่วยความจำ
- ตรวจสอบว่าคุณมีพื้นที่ดิสก์เพียงพอก่อนดึง ใช้
ทดสอบโมเดล
ในเทอร์มินัลของคอนเทนเนอร์ รัน:
ollama run qwen3.5:9bพิมพ์พรอมต์และยืนยันว่าคุณได้รับการตอบกลับ พิมพ์
/byeเพื่อออก
วิธีที่ 2: การปรับใช้ด้วย NVIDIA GPU
ข้อกำหนดเพิ่มเติมสำหรับโหมด GPU:
- ติดตั้ง NVIDIA GPU และตรวจพบโดย QTS/QuTS hero
- ตั้งค่า GPU เป็นโหมด Container Station ใน แผงควบคุม
- ติดตั้ง NVIDIA GPU Driver และ NvKernelDriver จาก App Center
ใช้การกำหนดค่า Docker Compose ที่รองรับ GPU
แทนที่ YAML จากวิธีที่ 1 ด้วยสิ่งต่อไปนี้:
version: "3.8" services: ollama: image: ollama/ollama:latest container_name: ollama restart: unless-stopped ports: - "11434:11434" volumes: - /share/Container/ollama:/root/.ollama environment: - OLLAMA_HOST=0.0.0.0 - OLLAMA_KEEP_ALIVE=10m - NVIDIA_VISIBLE_DEVICES=all deploy: resources: reservations: devices: - driver: nvidia count: all capabilities: [gpu] networks: - ai-network networks: ai-network: name: ai-network driver: bridge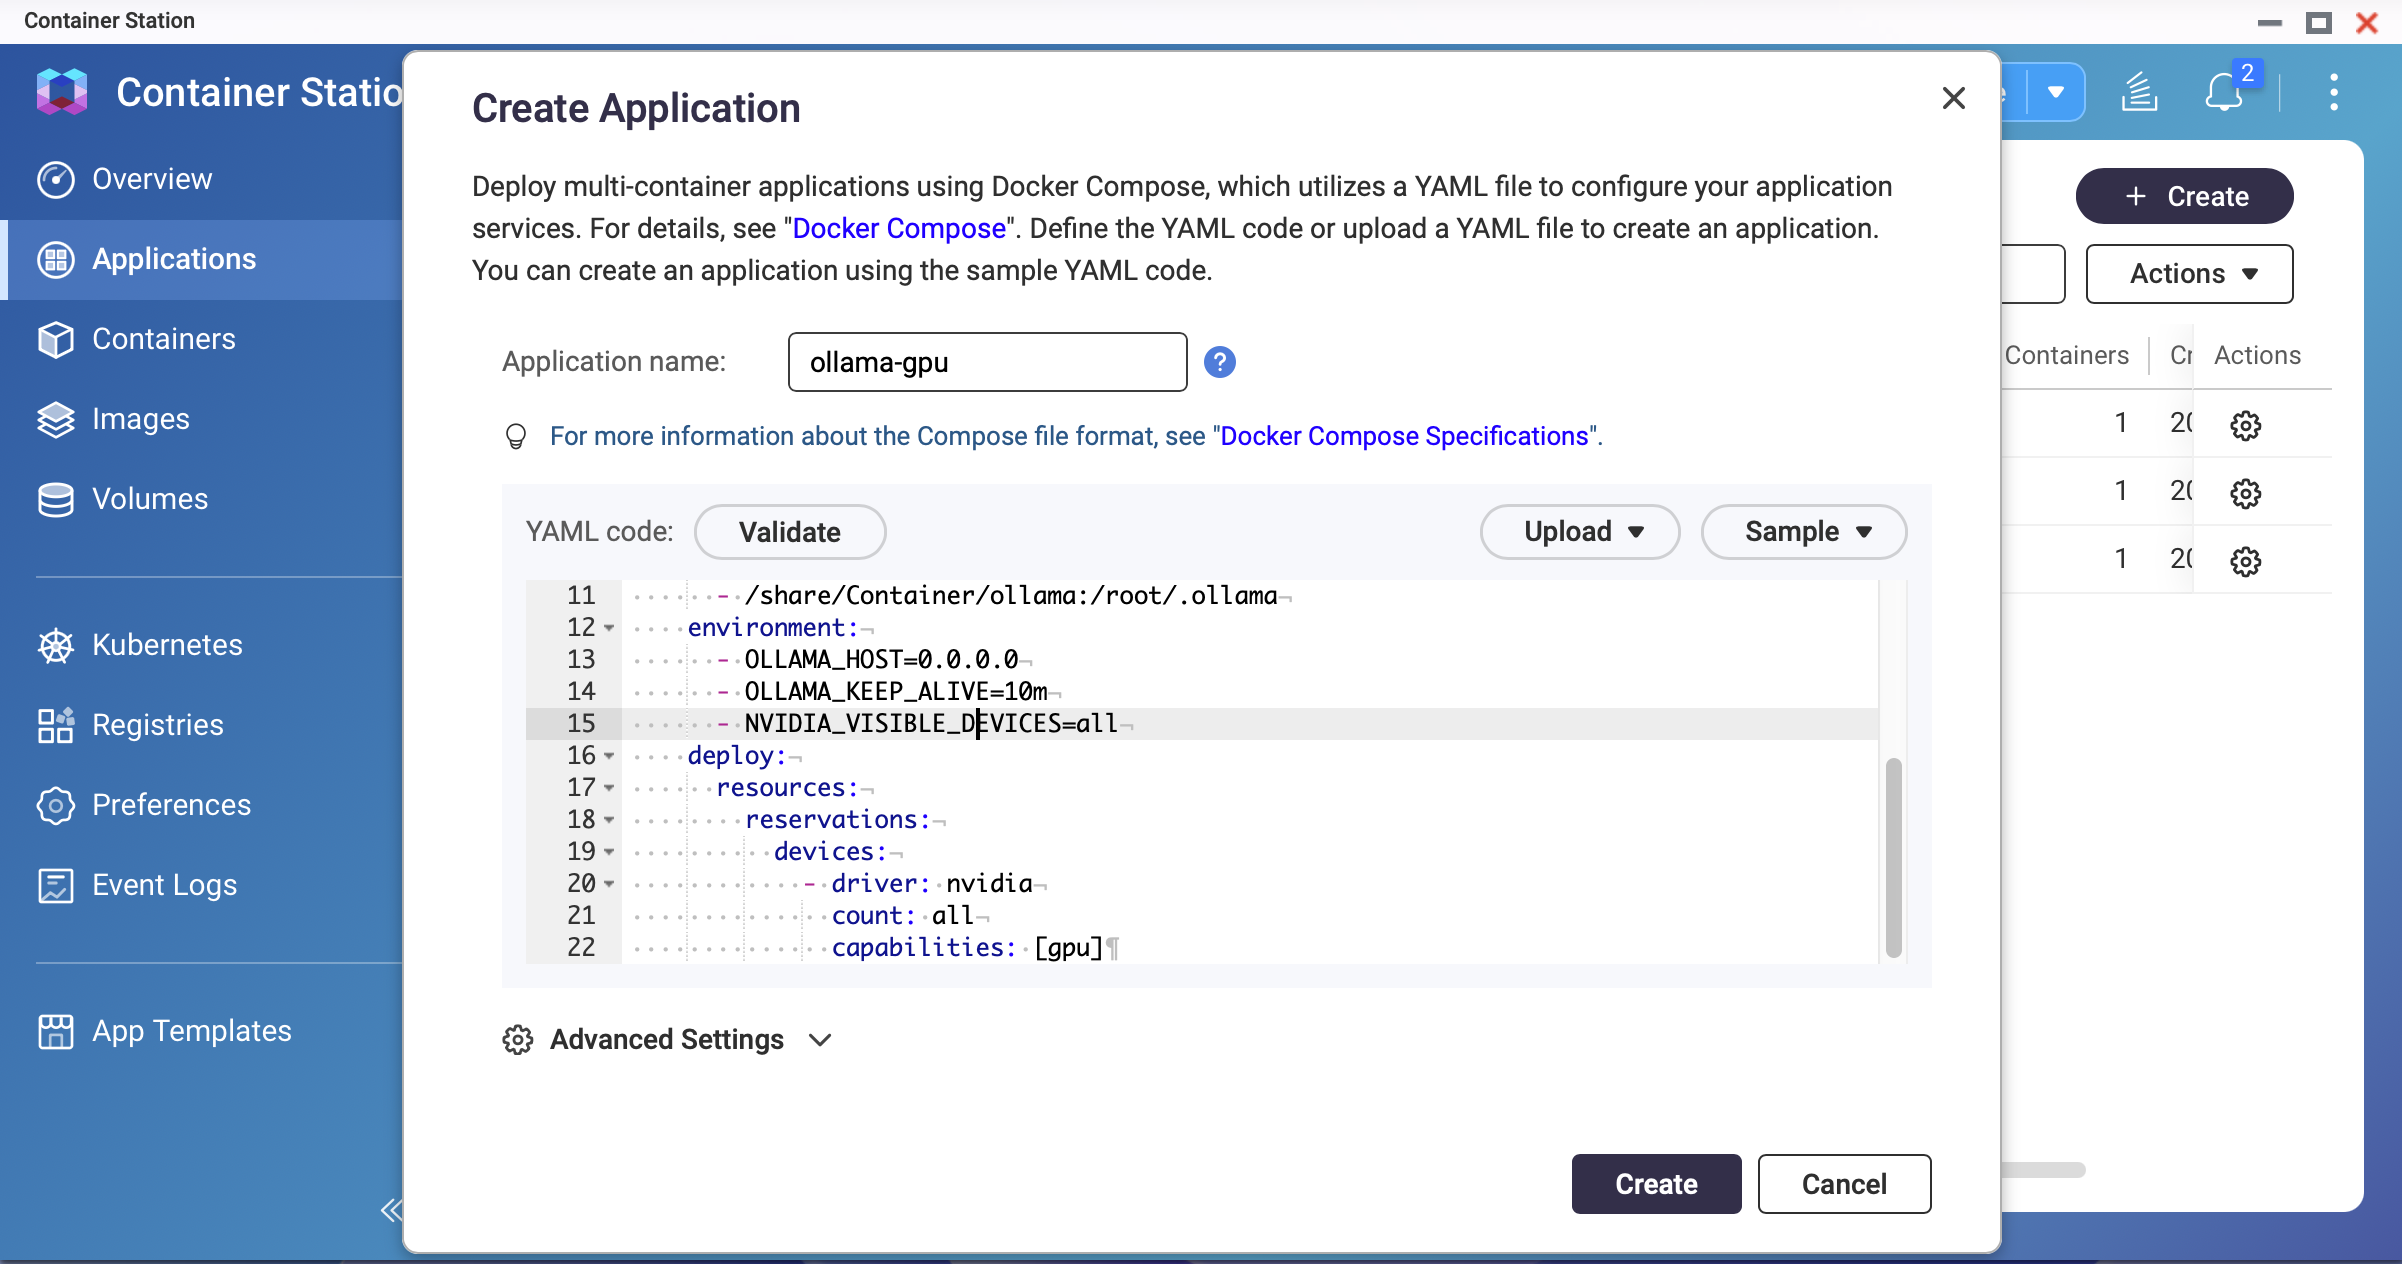 ภาพหน้าจอ: Container Station — GPU-enabled Docker Compose YAMLหมายเหตุไดรเวอร์ NVIDIA ที่มาพร้อมกับ QNAP อาจเก่ากว่ารุ่นล่าสุด หากคอนเทนเนอร์ไม่สามารถเริ่มต้นด้วย GPU ได้ ให้ตรวจสอบเวอร์ชันไดรเวอร์ด้วย
nvidia-smiบนโฮสต์และตรวจสอบให้แน่ใจว่าเข้ากันได้กับเวอร์ชันภาพ Ollamaปรับใช้และตรวจสอบการเข้าถึง GPU
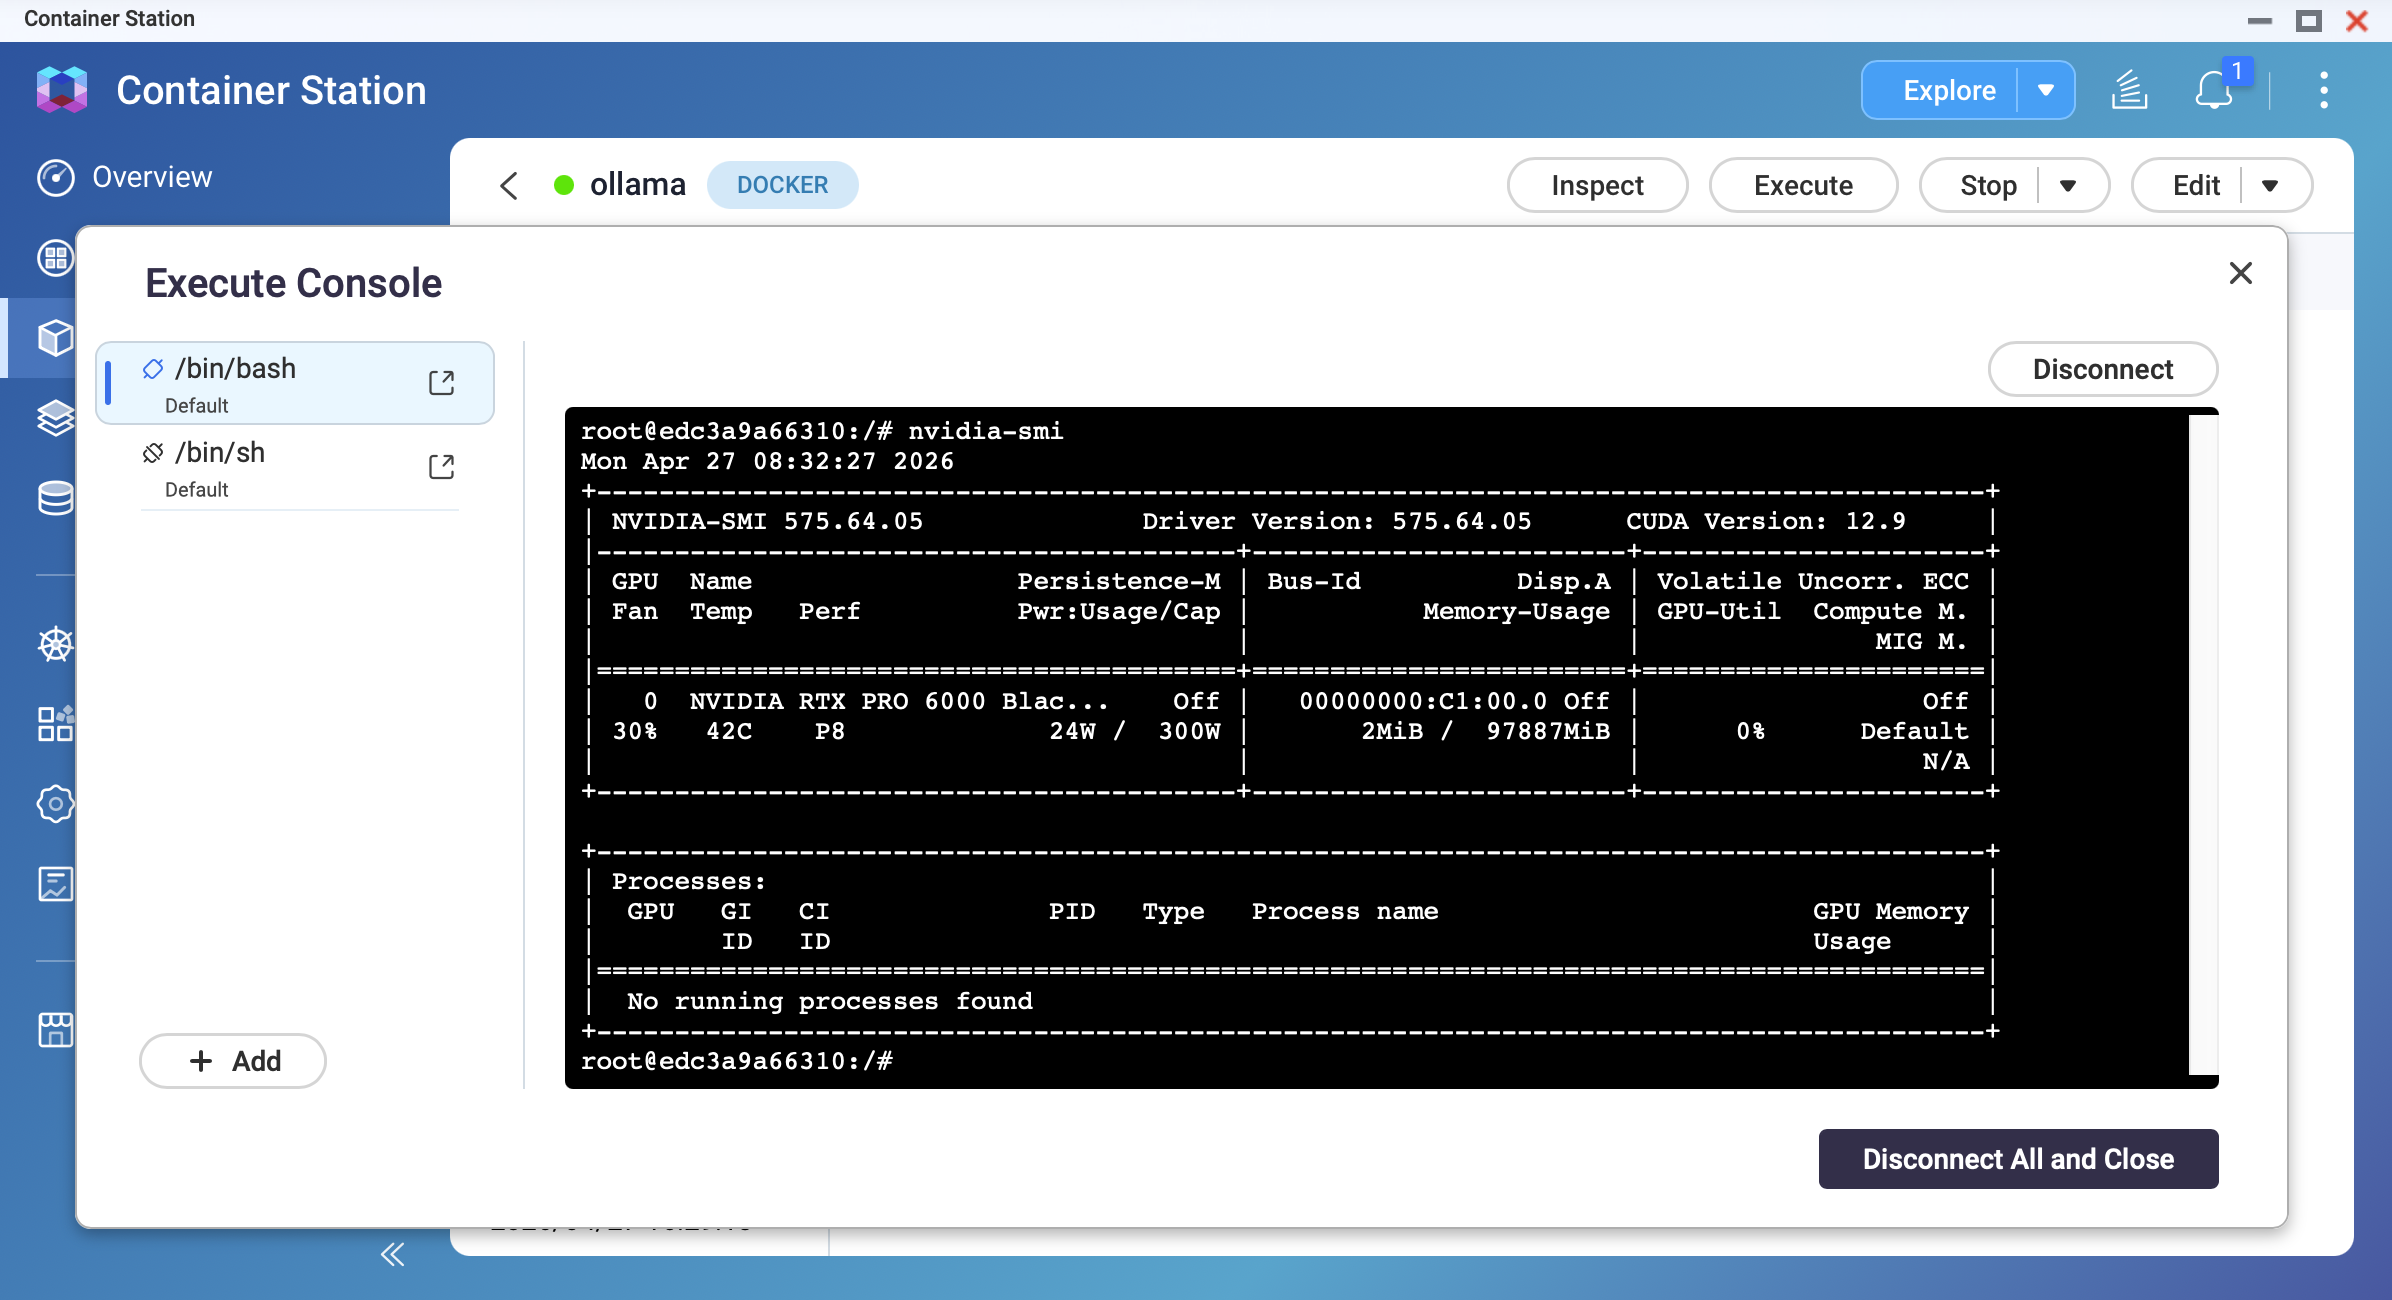
หลังจากคอนเทนเนอร์เริ่มต้น ให้เปิดเทอร์มินัลและรัน:
nvidia-smiคุณควรเห็นรุ่น GPU ของคุณ เวอร์ชันไดรเวอร์ และข้อมูลหน่วยความจำ
ดึงโมเดลและยืนยันการเร่งความเร็วด้วย GPU
ollama pull qwen3.5:9b ollama run qwen3.5:9bขณะที่โมเดลกำลังสร้างการตอบสนอง ให้เปิดเทอร์มินัลอีกอันและรัน
nvidia-smiคุณควรสังเกตการใช้หน่วยความจำ GPU และการใช้งาน GPU ที่เพิ่มขึ้น
ผลลัพธ์
หลังจากทำคู่มือนี้เสร็จสิ้น คุณจะมี:
- Ollama ทำงานบน QNAP NAS ของคุณที่
http://<NAS-IP>:11434 - ข้อมูลโมเดลถูกเก็บไว้ใน
/share/Container/ollama(ยังคงอยู่แม้จะสร้างคอนเทนเนอร์ใหม่) - LLM ที่ใช้งานได้ผ่าน Ollama API
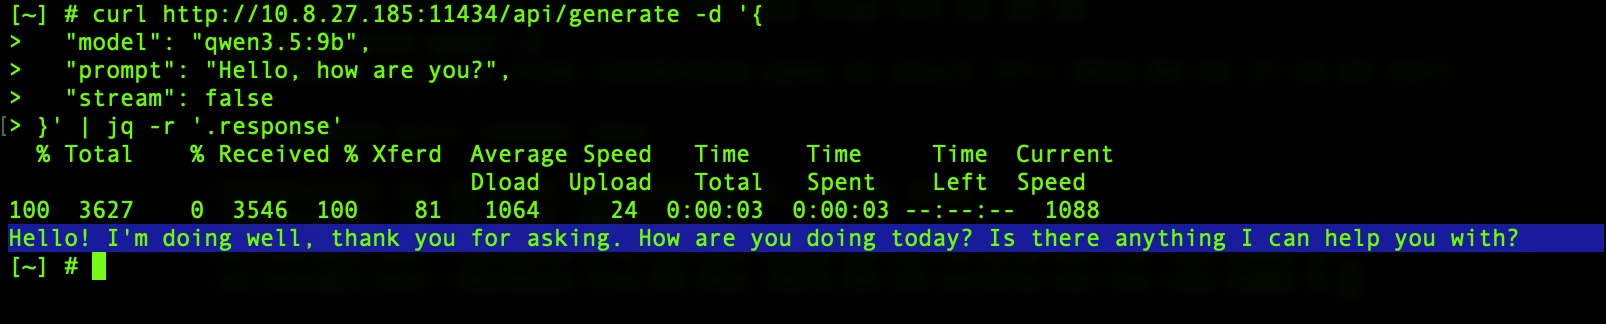
คุณสามารถทดสอบ API จากอุปกรณ์ใดก็ได้ในเครือข่ายท้องถิ่นของคุณ:
curl http://<NAS-IP>:11434/api/generate -d '{
  "model": "qwen3.5:9b",
  "prompt": "Hello, how are you?",
  "stream": false
}'
OLLAMA_HOST=0.0.0.0 เปิดเผย Ollama API บนอินเทอร์เฟซเครือข่ายทั้งหมด อย่าเปิดเผยพอร์ต 11434 สู่อินเทอร์เน็ต ใช้กฎ ไฟร์วอลล์ หรือการตั้งค่าเครือข่ายของ QNAP เพื่อจำกัดการเข้าถึงเฉพาะเครือข่ายท้องถิ่นของคุณเท่านั้นการแก้ไขปัญหา
คอนเทนเนอร์ออกทันทีหลังจากเริ่มต้น
อาจเกิดจาก RAM ไม่เพียงพอหรือไดรเวอร์ GPU ไม่ตรงกัน ตรวจสอบบันทึกคอนเทนเนอร์ใน Container Station ลดข้อจำกัดของหน่วยความจำหรือปิดโหมด GPU
การดึงโมเดลล้มเหลวกลางคัน
อาจเกิดจากพื้นที่ดิสก์ไม่เพียงพอหรือหมดเวลาการเชื่อมต่อเครือข่าย ลองเพิ่มพื้นที่ ที่เก็บข้อมูล เรียกใช้ ollama pull อีกครั้ง ระบบจะดำเนินการต่อจากที่หยุด
ความเร็วในการตอบสนองช้ามาก (1–3 โทเค็นต่อวินาที)
โมเดลอาจทำงานบน CPU แทน GPU หรือโมเดลใหญ่เกินไปสำหรับ RAM ของคุณ ตรวจสอบการเข้าถึง GPU ของคุณด้วย nvidia-smi ภายในคอนเทนเนอร์ ลองใช้โมเดลที่เล็กลง
NAS ไม่ตอบสนองระหว่างการอนุมาน
อาจเป็นปัญหา "หน่วยความจำไม่เพียงพอ": โมเดลใช้หน่วยความจำของระบบทั้งหมด เราแนะนำให้รีสตาร์ท NAS ตั้งค่าขีดจำกัดการใช้หน่วยความจำในแอปพลิเคชัน หรือใช้โมเดลที่เล็กลง
ข้อความ "ไม่สามารถเชื่อมต่อกับ Ollama" จาก Open WebUI
อาจเกิดจาก URL API ที่ผิดหรือการแยกเครือข่าย Docker คุณสามารถใช้ http://ollama:11434 หากคุณอยู่ในเครือข่าย Docker เดียวกัน
หากต้องการความช่วยเหลือเพิ่มเติม สอบถามผู้ใช้รายอื่นและผู้เชี่ยวชาญของ QNAP ได้ในคอมมูนิตี้ ไปที่ QNAP Community


