


Cómo implementar Ollama en el NAS de QNAP usando Container Station
Productos aplicables
QTS, QuTS hero
Container Station
Escenario
Desea ejecutar modelos de lenguaje grande (LLMs) localmente en su NAS QNAP para chat privado de IA, asistencia de código o análisis de documentos sin enviar datos a la nube. Ollama es el motor de inferencia más popular y fácil de usar para este propósito. Este tutorial explica cómo implementar Ollama en el NAS QNAP usando Container Station.
Requisitos del sistema
| Requisito | Detalle |
|---|---|
| App de QNAP | Container Station 3.x o posterior |
| Arquitectura NAS | x86_64 (CPU Intel o AMD) (Solo se admiten algunos modelos basados en ARM.) |
| Memoria |
|
| Espacio Almacenamiento |
|
| GPU (Opcional) | GPUs NVIDIA compatibles (ver el Lista de compatibilidad) La GPU debe configurarse en Modo Container Station en el Panel de control. |
Ollama intentará cargar todo el modelo en la memoria por defecto. Si su NAS tiene solo 8–16 GB de RAM, cargar un modelo de 14B o más grande puede agotar la memoria del sistema, causando que los servicios del NAS se vuelvan no responsivos o que el sistema se reinicie.
Riesgo de pérdida de datos
Si no monta un volumen persistente para
/root/.ollama, todos los modelos y configuraciones descargados se perderán cuando el contenedor sea eliminado o recreado. Siempre siga las instrucciones de montaje de volumen en este tutorial.- Verifique el tamaño del modelo con respecto a la RAM disponible de antemano.
- Establezca límites de memoria para limitar el uso de memoria del contenedor.
- Comience con modelos pequeños (1B o 3B) y evalúe la estabilidad del sistema antes de intentar con modelos más grandes.
Procedimiento
Método 1: Implementación solo con CPU (No se requiere GPU)
Crear carpetas Almacenamiento.
Abra File Station y cree la siguiente carpeta para almacenar datos del modelo Ollama:
/share/Container/ollama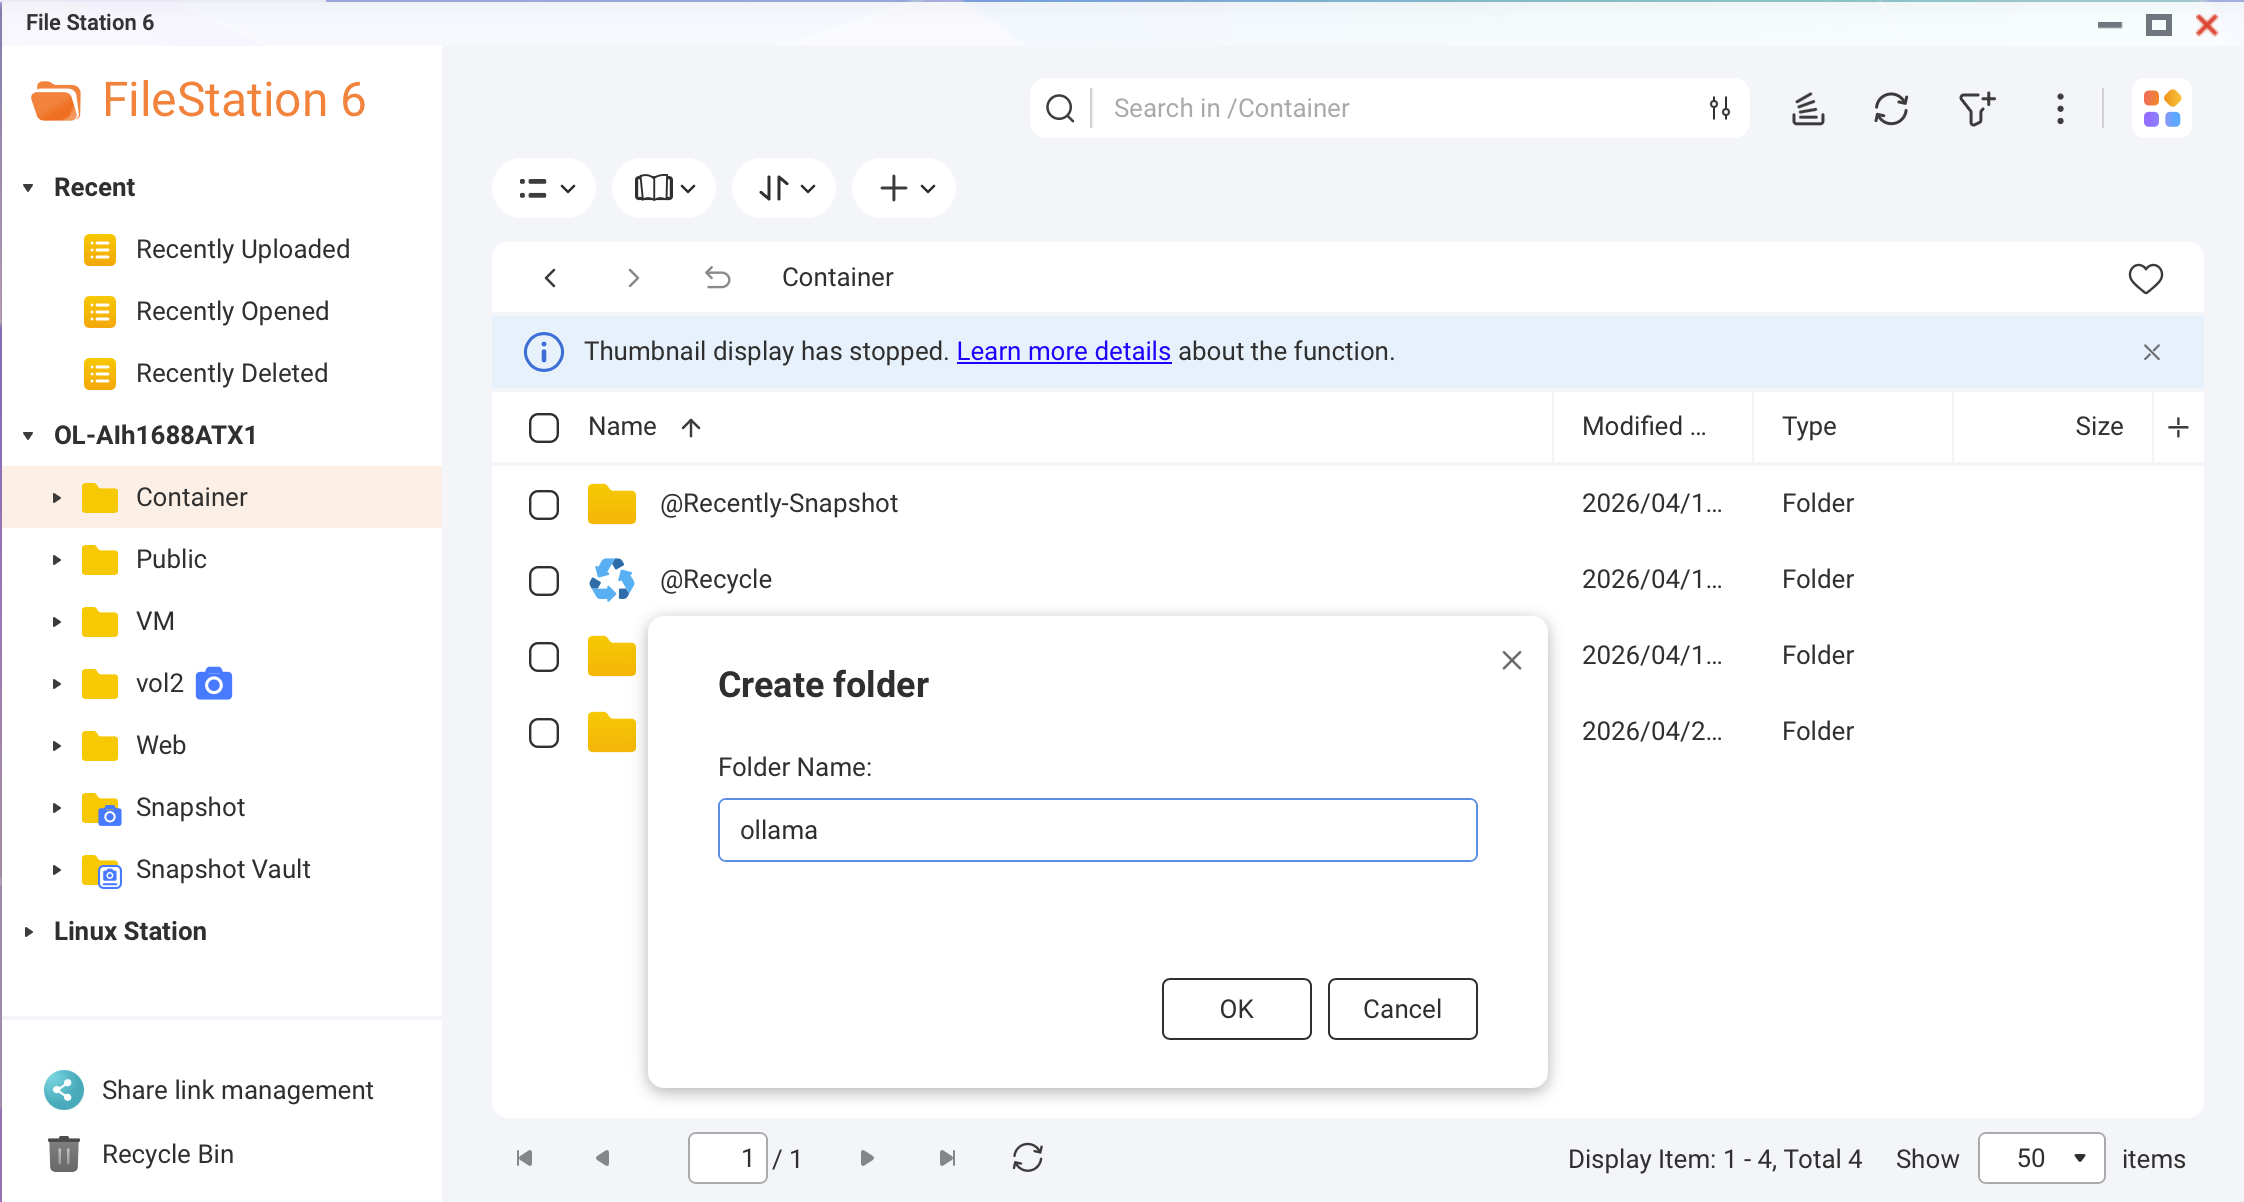 Captura de pantalla: File Station — creando la carpeta Ollama en /share/Container/Práctica recomendadaSi su NAS tiene un caché SSD NVMe o un volumen SSD, cree esta carpeta en el SSD. La velocidad de carga del modelo mejora hasta 10 veces en comparación con los HDD.
Crear un archivo Docker Compose.
En Container Station, vaya a Aplicaciones > Crear. Nombre la aplicación
ollamay pegue el siguiente YAML:version: "3.8" services: ollama: image: ollama/ollama:latest container_name: ollama restart: unless-stopped ports: - "11434:11434" volumes: - /share/Container/ollama:/root/.ollama environment: - OLLAMA_HOST=0.0.0.0 - OLLAMA_KEEP_ALIVE=10m networks: - ai-network networks: ai-network: name: ai-network driver: bridge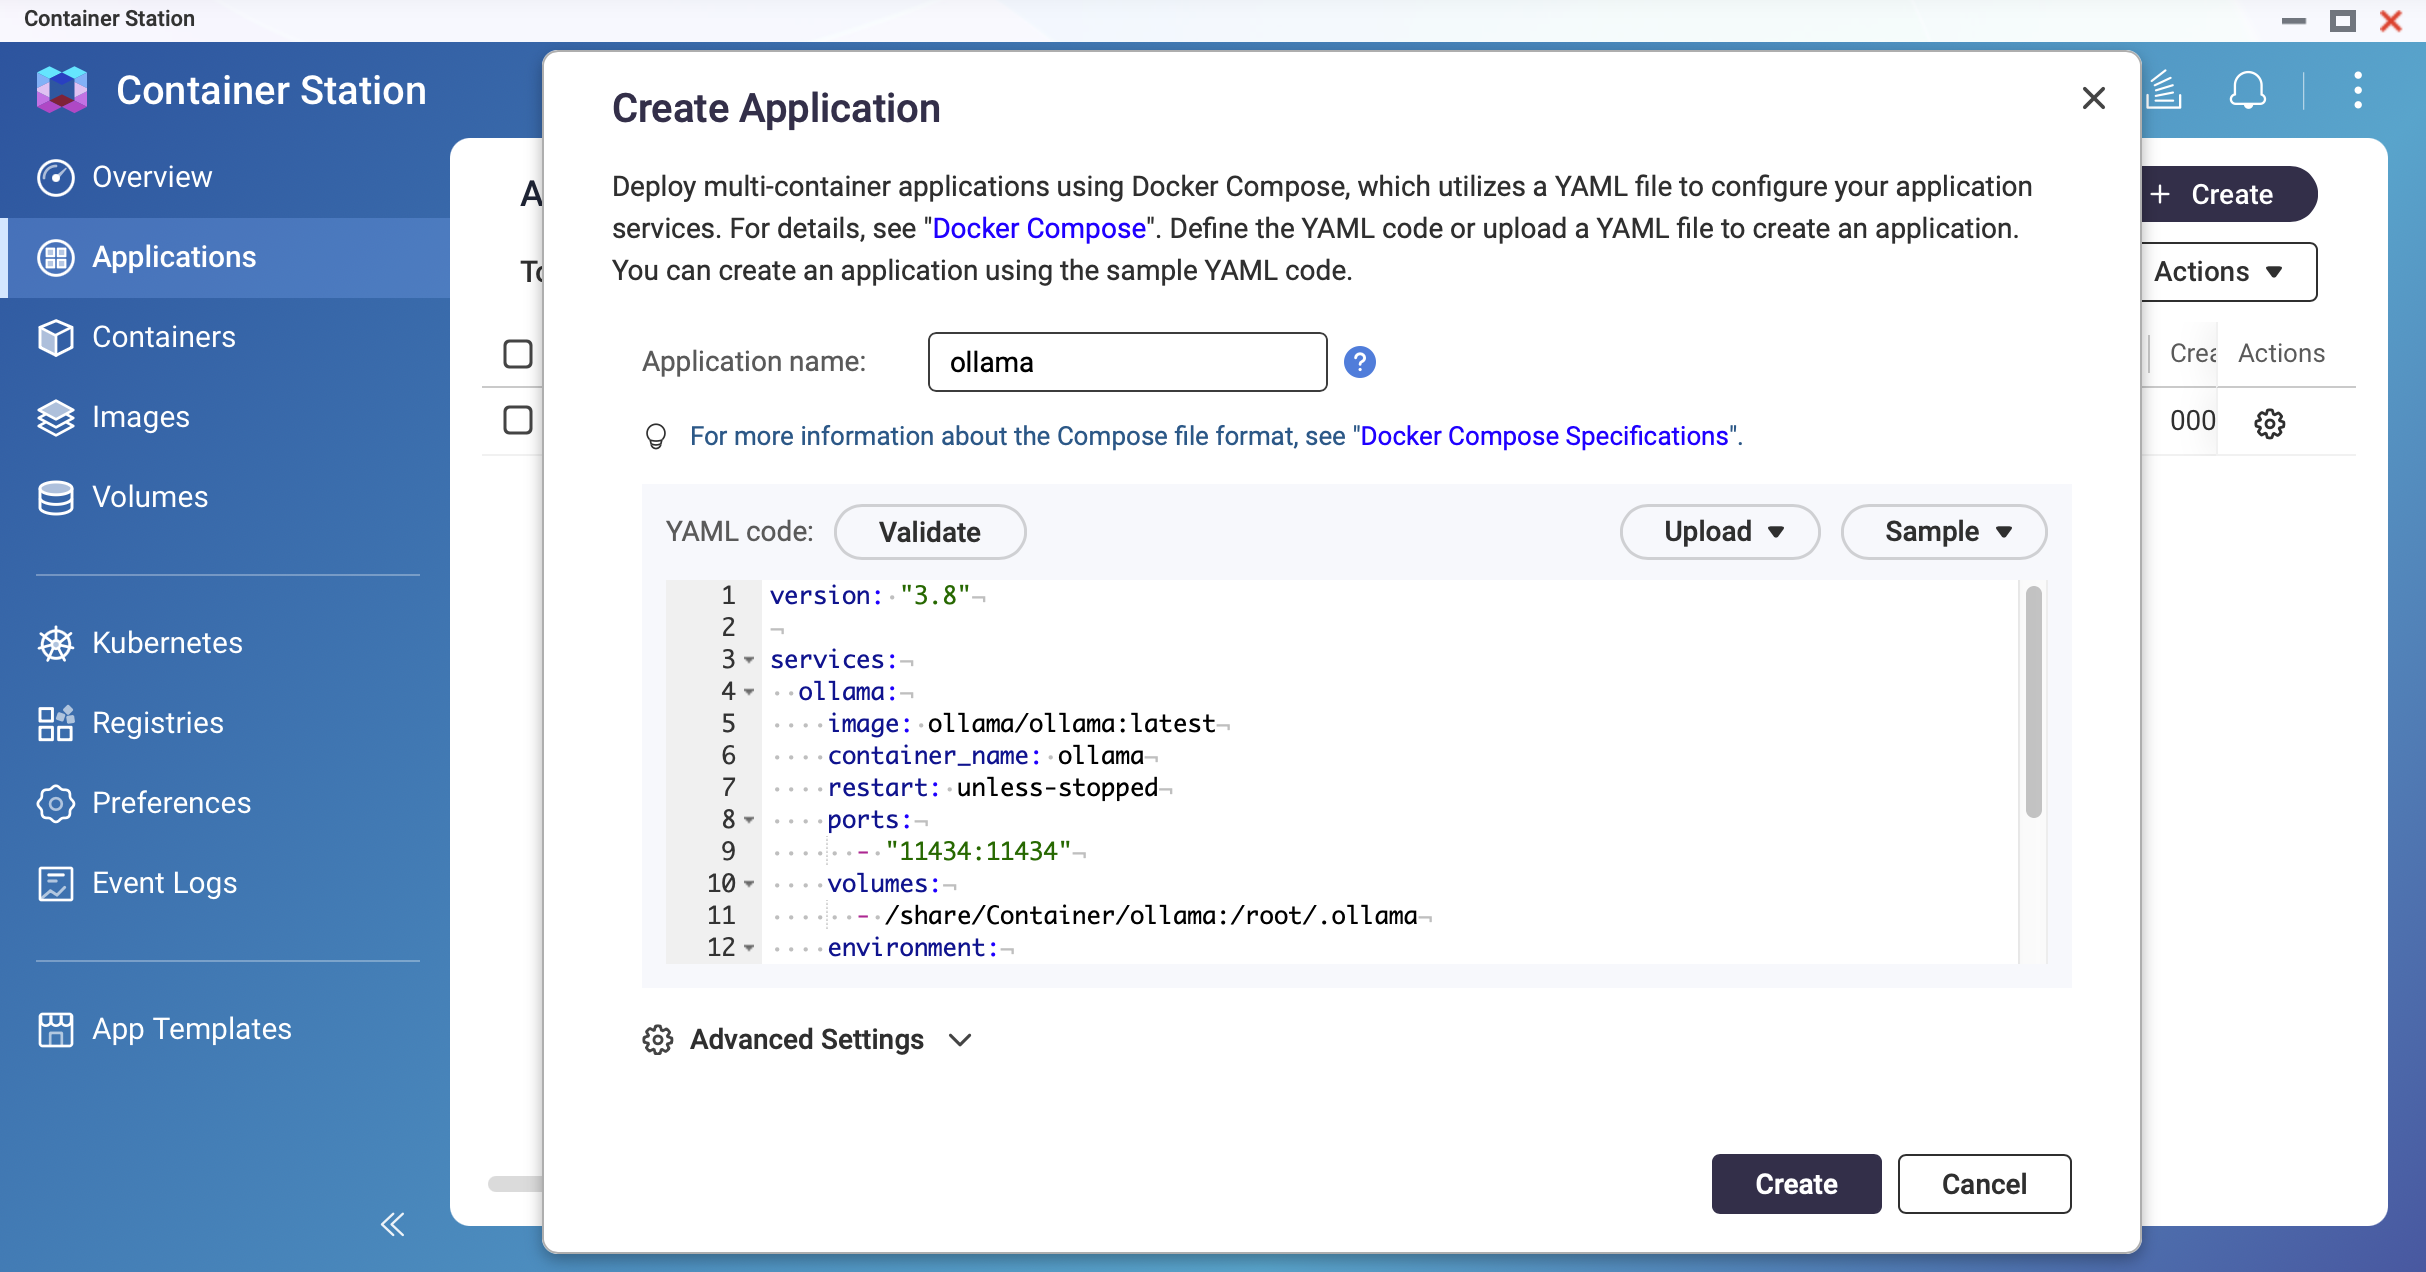 Captura de pantalla: Container Station — pantalla de creación de aplicaciones con editor YAML
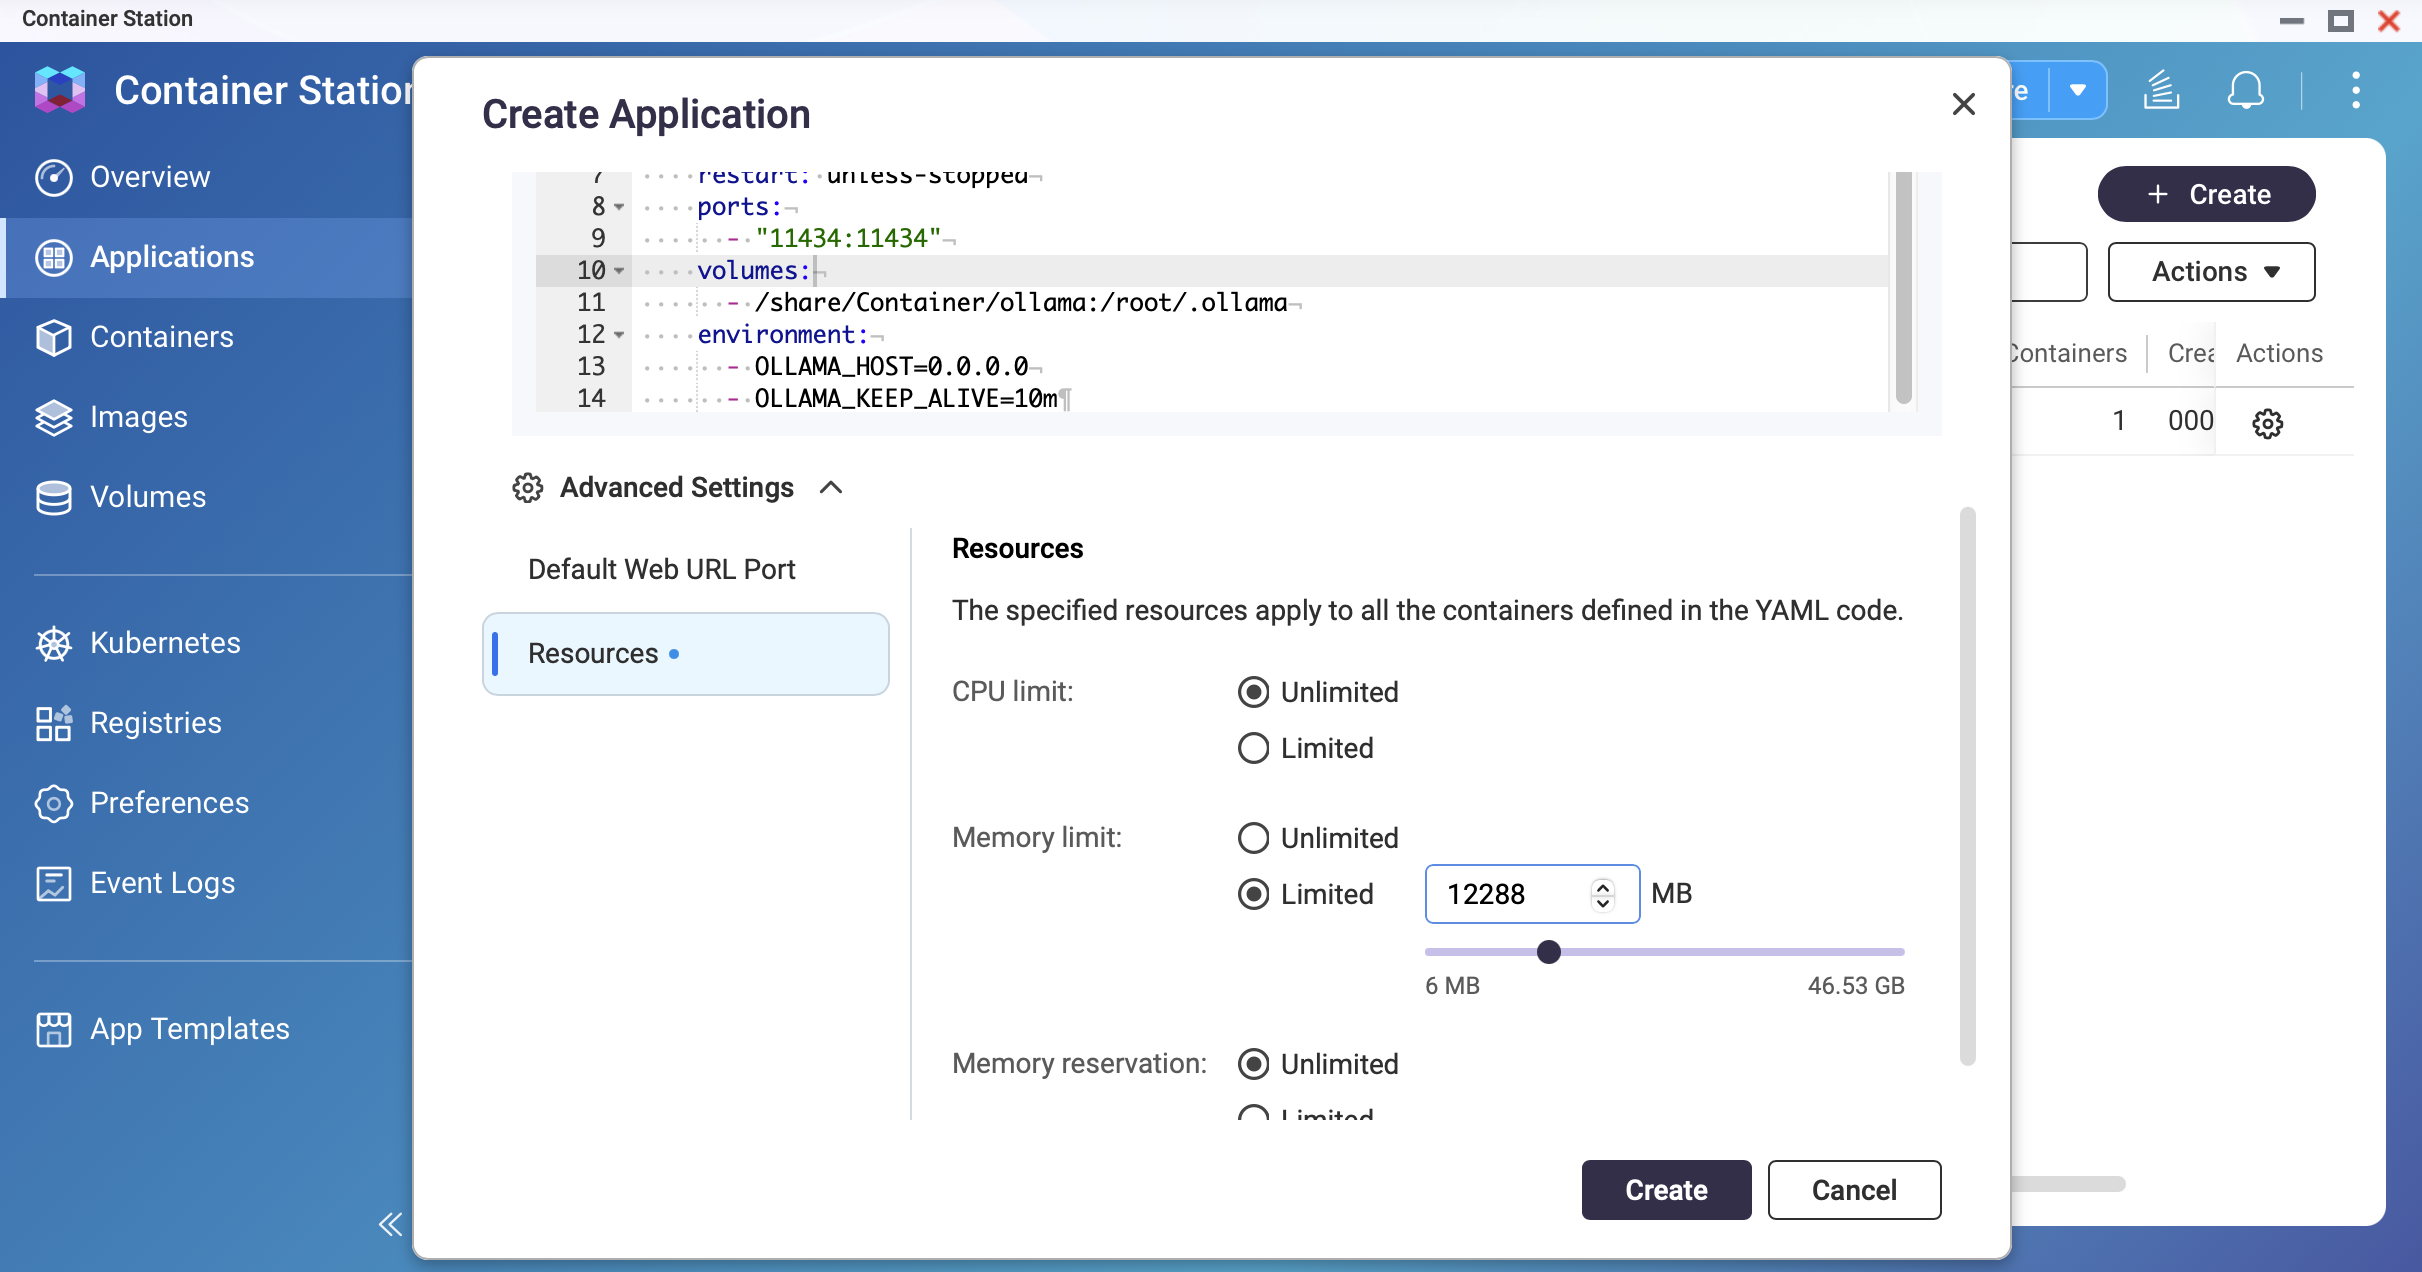 Captura de pantalla: Container Station — Establecer el límite de memoria
Implemente el contenedor.
Haga clic en Crear. Container Station descargará la imagen de Ollama y comenzará el contenedor. Espere hasta que el estado muestre Ejecutando.
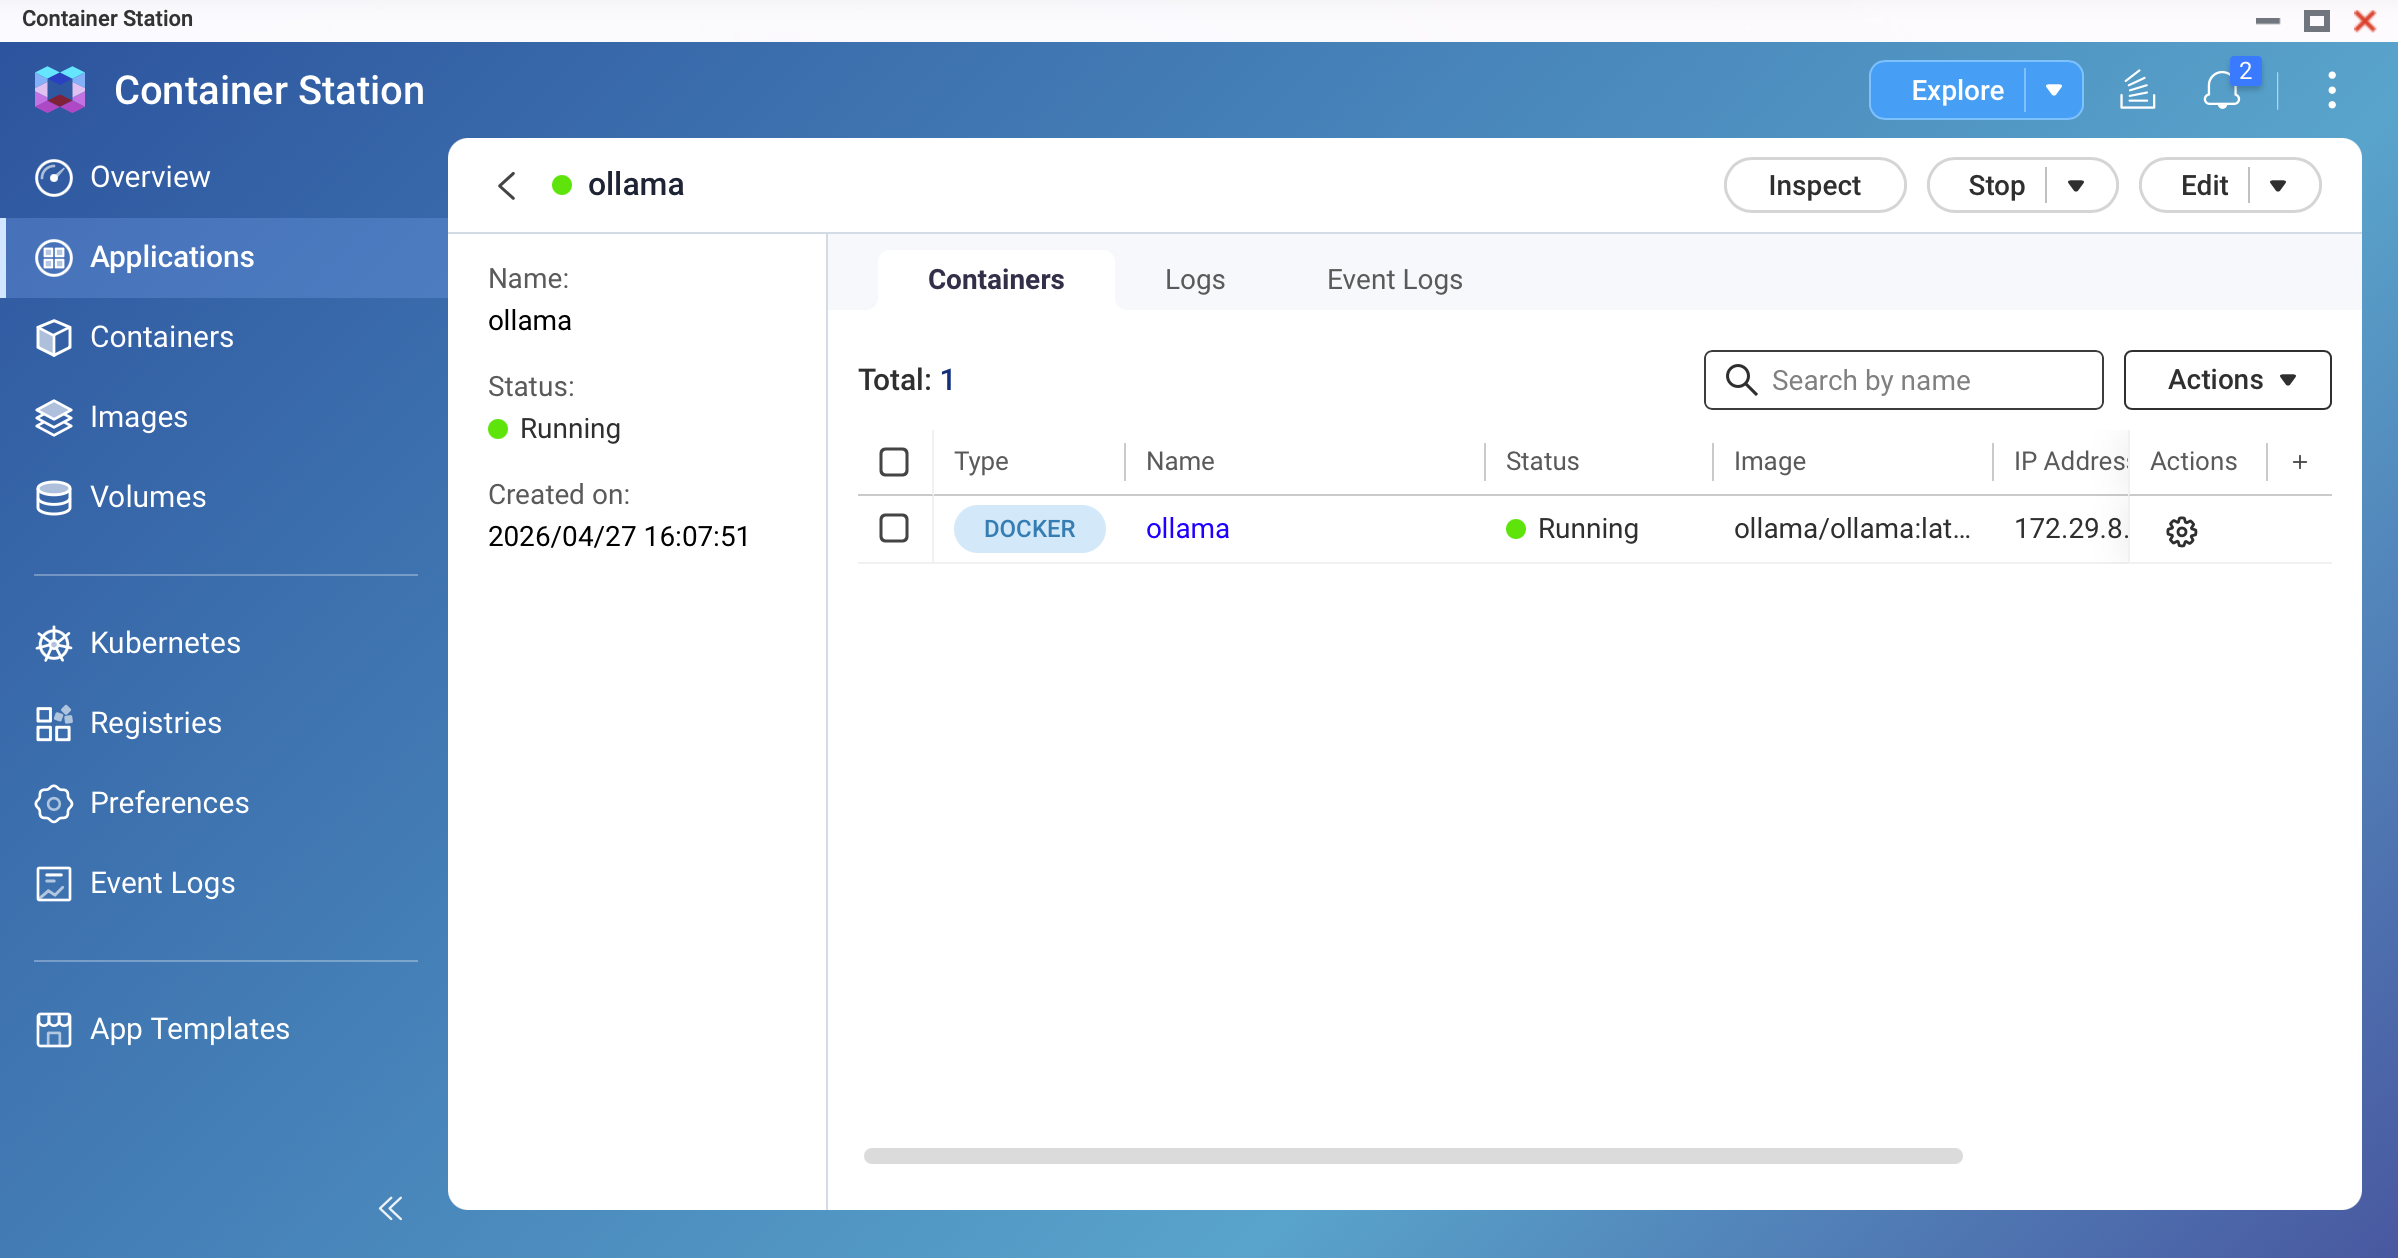 Captura de pantalla: Container Station — contenedor de ollama mostrando estado "Ejecutando"
Descargue su primer modelo.
Abra el Terminal del contenedor (o acceda por SSH a su NAS y ejecute su Docker) y ejecute:
# Para un modelo ligero de 3B (recomendado para la primera prueba): ollama pull llama3.2:3b # Para un modelo estándar de 9B (requiere 16 GB+ de RAM): ollama pull qwen3.5:9bLa descarga puede tardar varios minutos dependiendo de la velocidad de su internet. Un modelo 9B Q4_K_M es aproximadamente de 4–7 GB.
Nota- Verifique que tenga suficiente espacio en disco antes de descargar. Use
ollama listpara comprobar los modelos existentes y sus tamaños. - Para modelos NAS basados en ARM, recomendamos comenzar con el modelo <1B para monitorear el uso de memoria.
- Verifique que tenga suficiente espacio en disco antes de descargar. Use
Pruebe el modelo.
En el terminal del contenedor, ejecute:
ollama run qwen3.5:9bEscriba un mensaje y confirme que recibe una respuesta. Escriba
/byepara salir.
Método 2: Despliegue acelerado por GPU NVIDIA
Requisitos adicionales para el Modo GPU:
- GPU NVIDIA instalada y detectada por QTS/QuTS hero
- GPU configurada en Modo Container Station en el Panel de control
- Controlador de GPU NVIDIA y NvKernelDriver instalados desde App Center
Utilice la configuración de Docker Compose habilitada para GPU.
Reemplace el YAML del Método 1 con lo siguiente:
version: "3.8" services: ollama: image: ollama/ollama:latest container_name: ollama restart: unless-stopped ports: - "11434:11434" volumes: - /share/Container/ollama:/root/.ollama environment: - OLLAMA_HOST=0.0.0.0 - OLLAMA_KEEP_ALIVE=10m - NVIDIA_VISIBLE_DEVICES=all deploy: resources: reservations: devices: - driver: nvidia count: all capabilities: [gpu] networks: - ai-network networks: ai-network: name: ai-network driver: bridge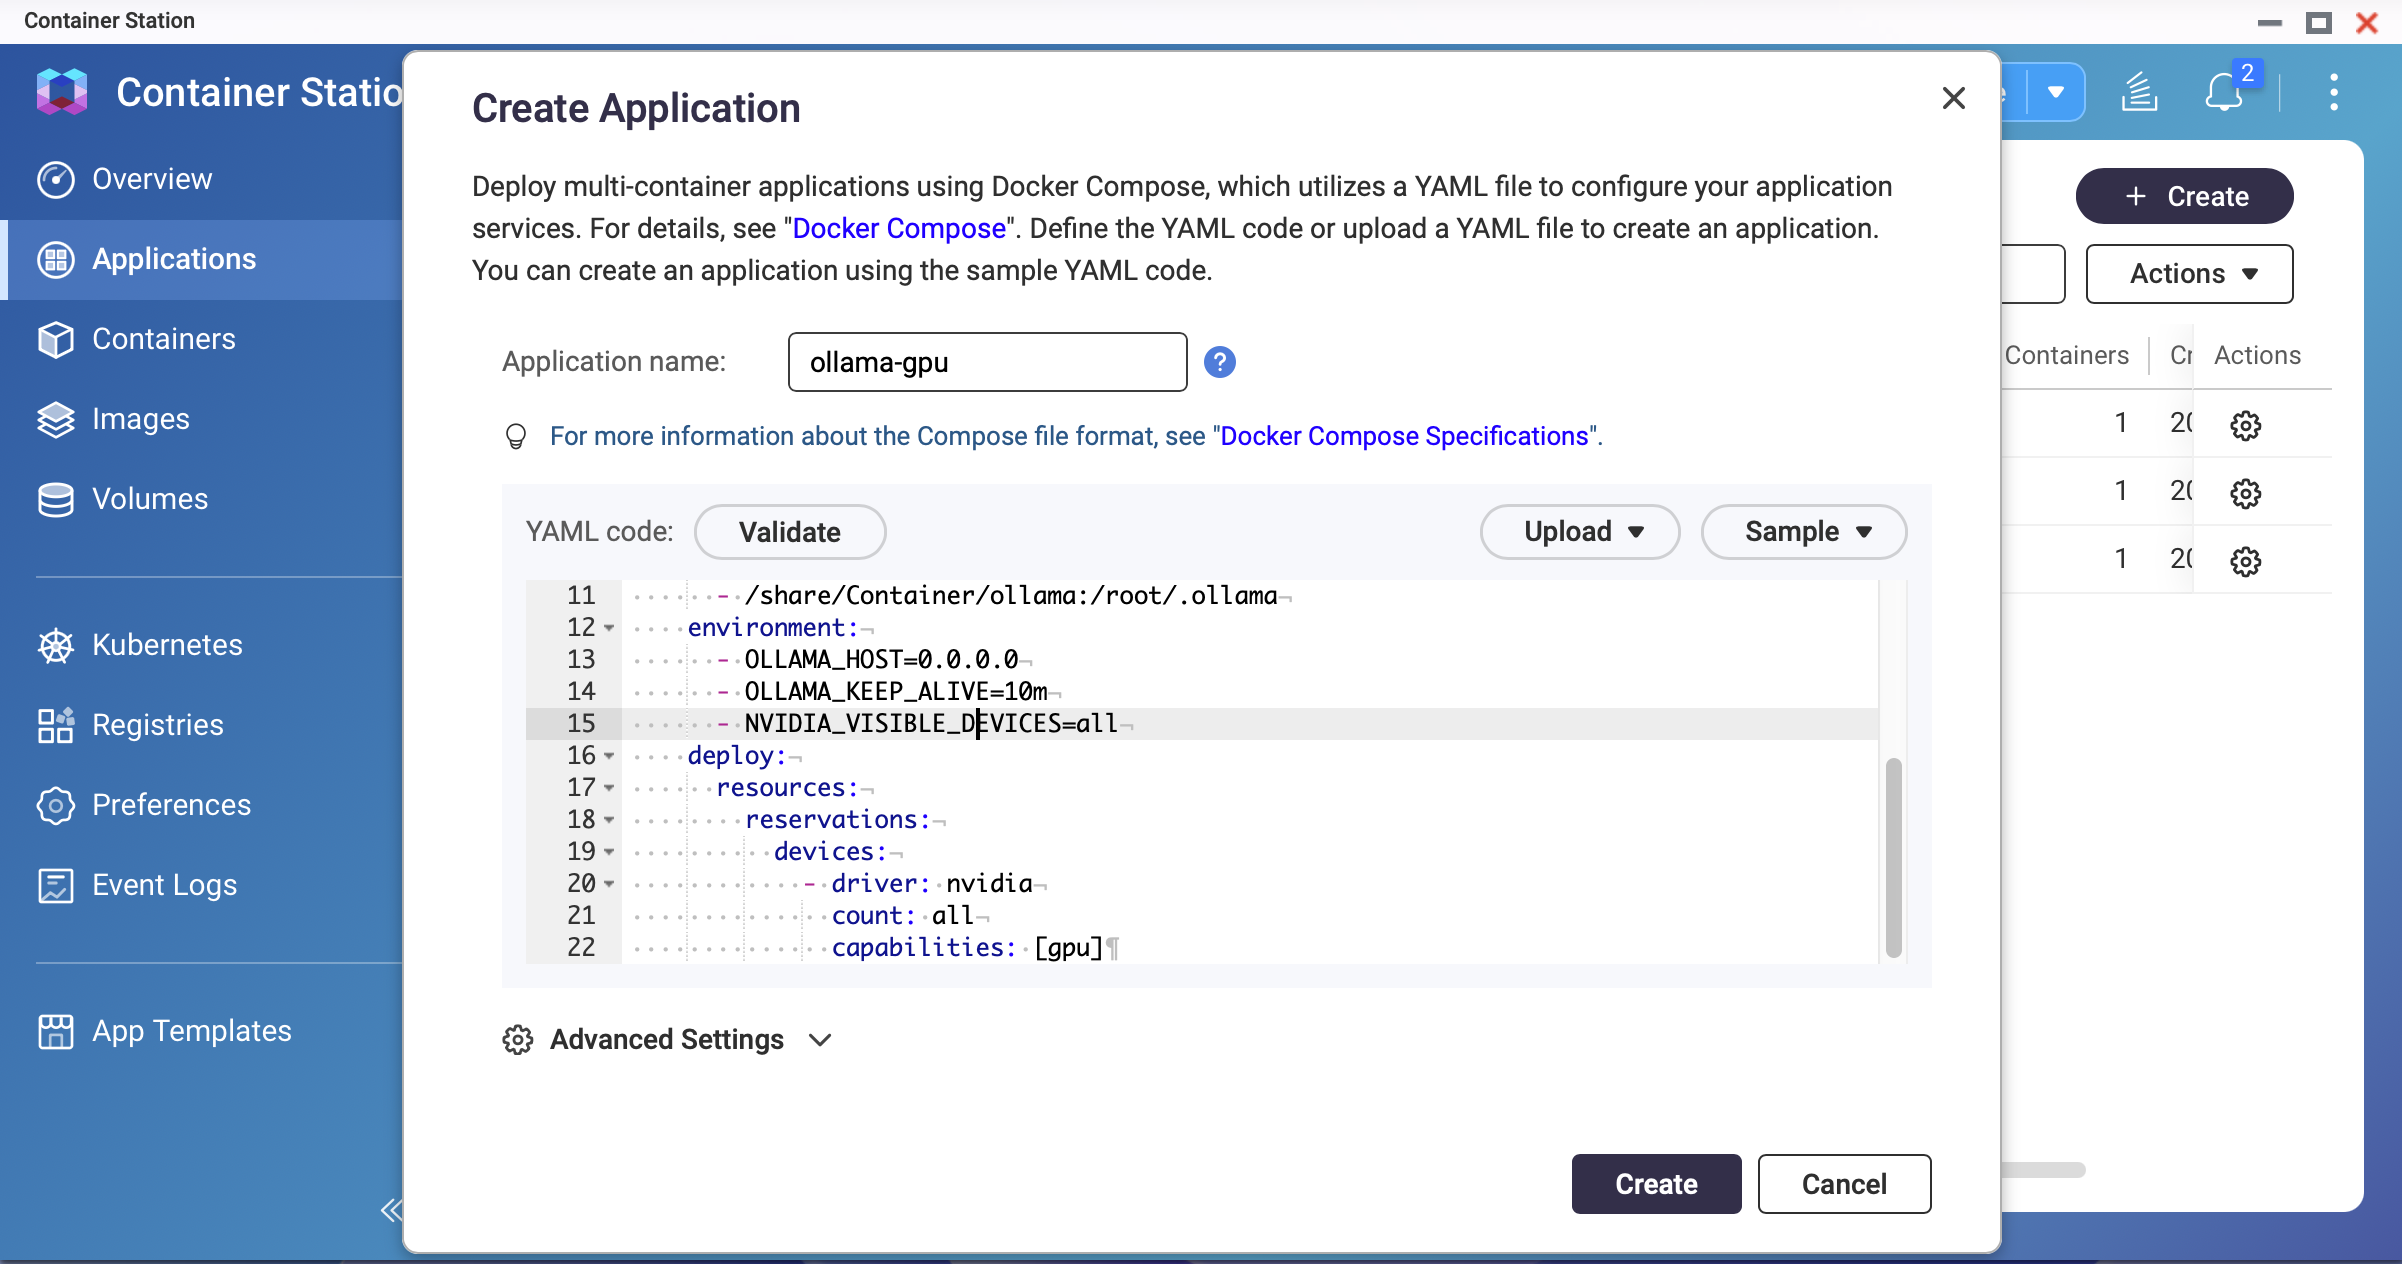 Captura de pantalla: Container Station — YAML de Docker Compose habilitado para GPUNotaLos controladores NVIDIA incluidos de QNAP pueden ser más antiguos que la última versión. Si el contenedor no se inicia con la GPU habilitada, verifique la versión del controlador con
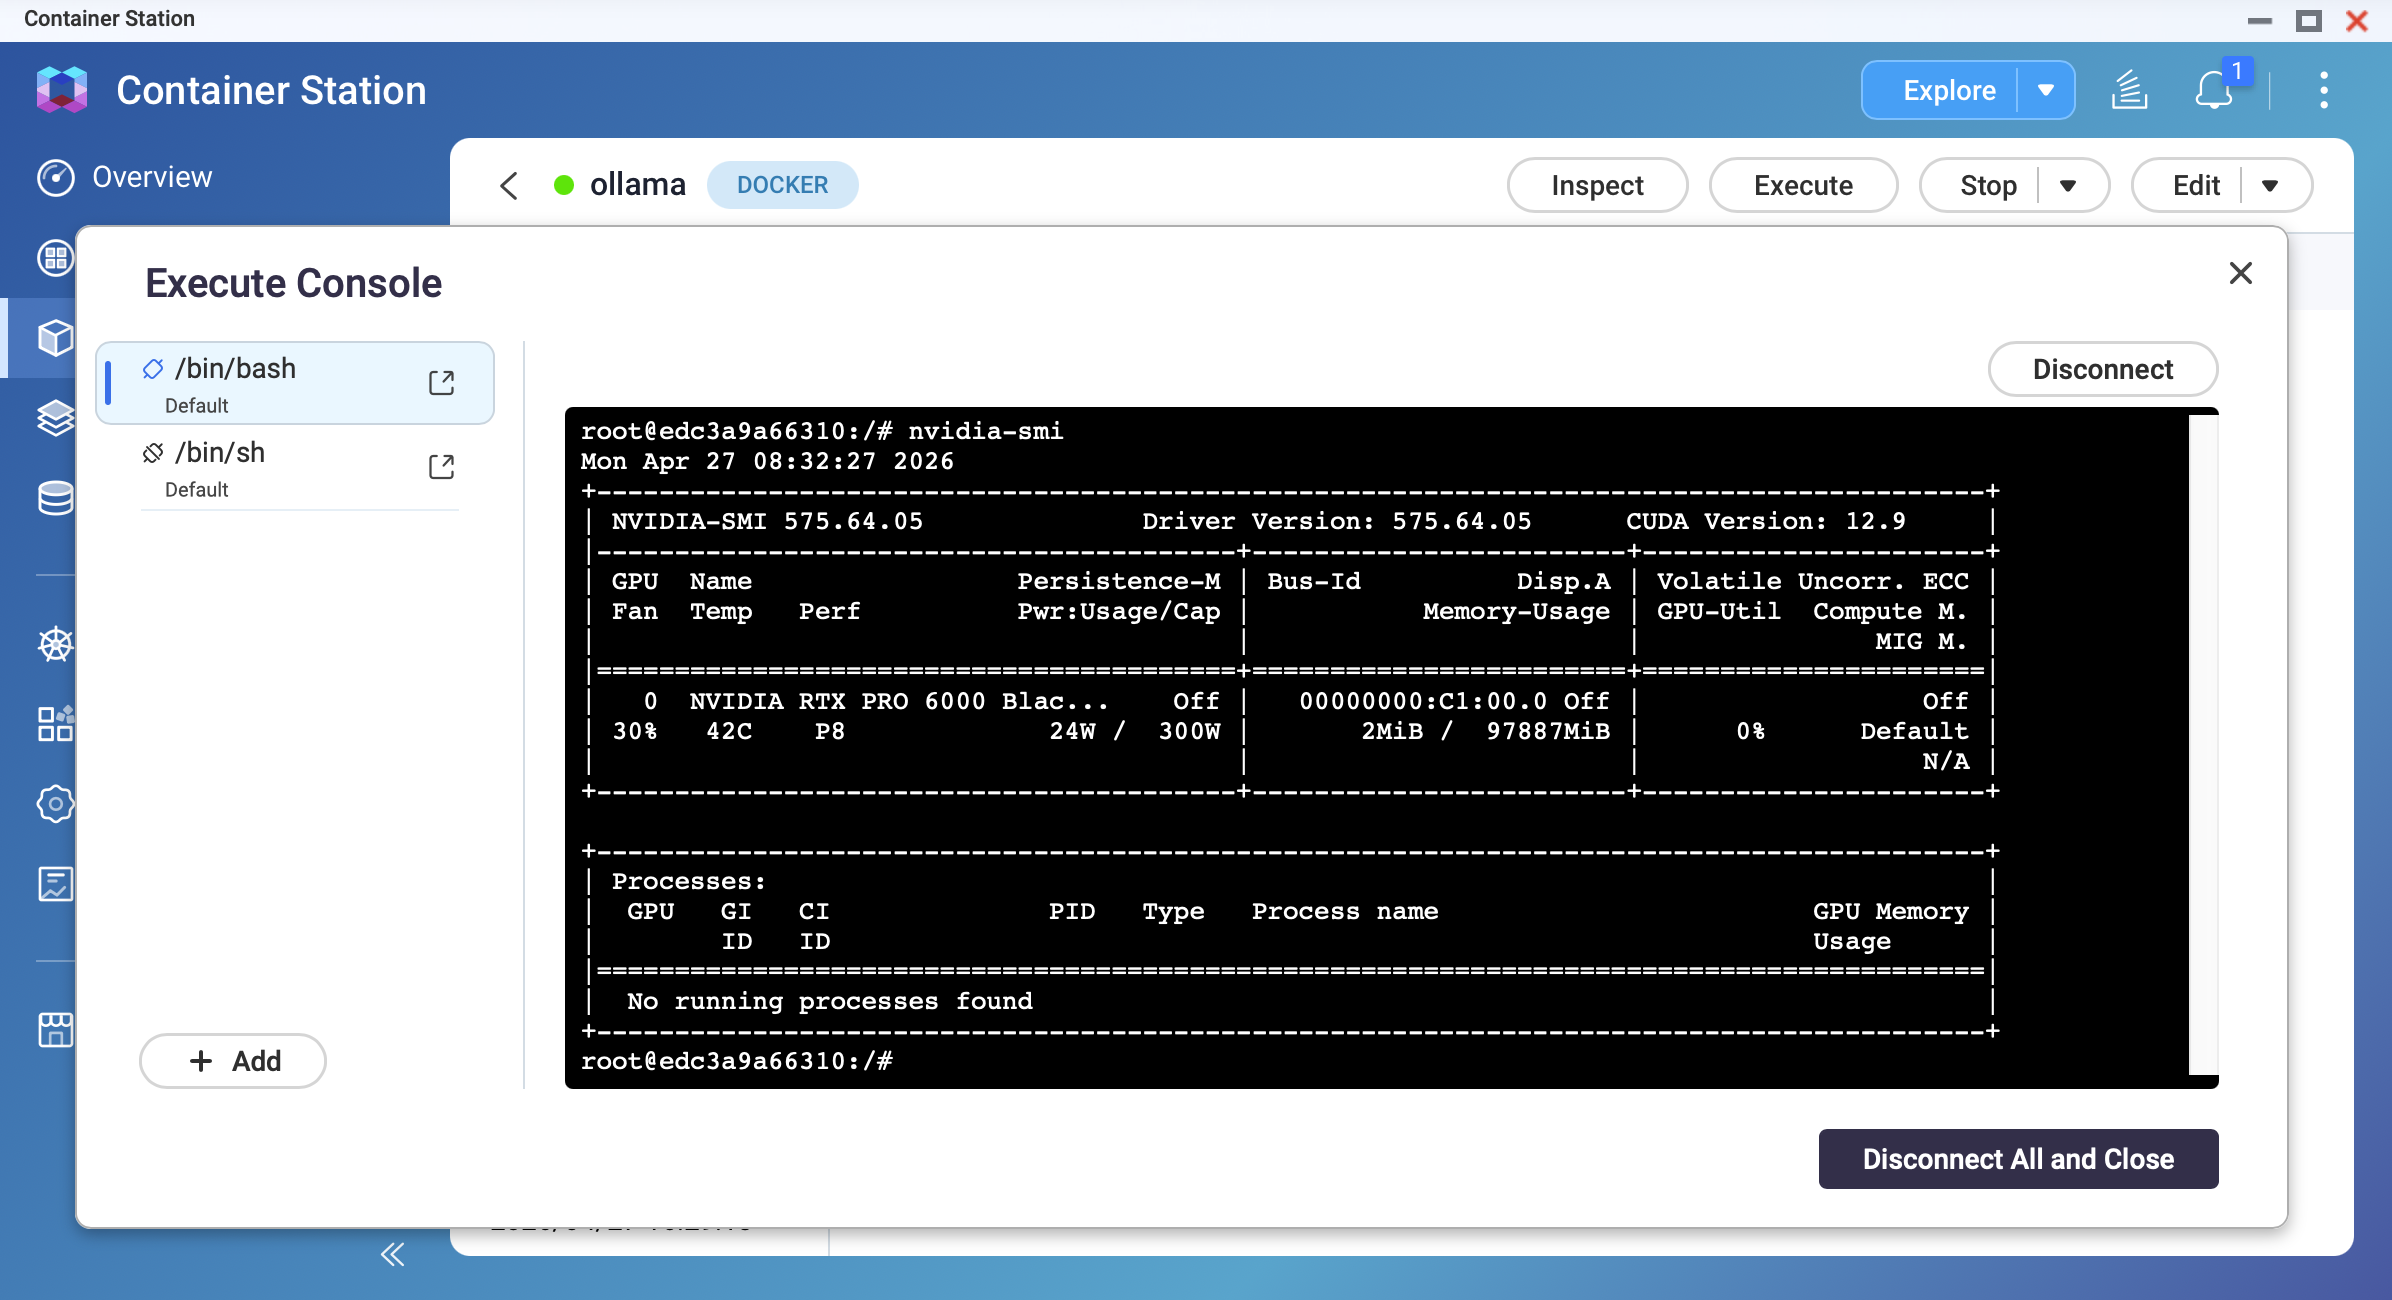
nvidia-smien el host y asegúrese de que sea compatible con la versión de imagen de OllamaDespliegue y verifique el acceso a la GPU.
Después de que el contenedor se inicie, abra su terminal y ejecute:
nvidia-smiDebería ver su modelo de GPU, versión del controlador e información de memoria.
Descargue un modelo y confirme la aceleración de GPU.
ollama pull qwen3.5:9b ollama run qwen3.5:9bMientras el modelo genera una respuesta, abra otro terminal y ejecute
nvidia-smi. Debería observar un aumento en el uso de memoria de la GPU y la utilización de la GPU.
Resultado
Después de completar este tutorial, tendrás:
- Ollama ejecutándose en tu NAS de QNAP en
http://<NAS-IP>:11434 - Datos del modelo persistidos en
/share/Container/ollama(sobrevive a reconstrucciones de contenedor) - Un LLM funcional accesible a través de la API de Ollama
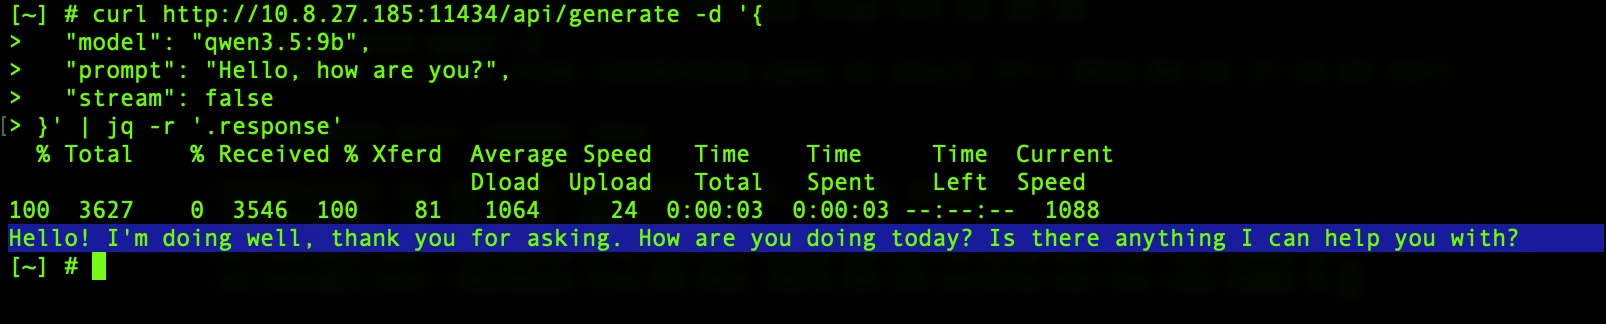
Puedes probar la API desde cualquier dispositivo en tu red local:
curl http://<NAS-IP>:11434/api/generate -d '{
  "model": "qwen3.5:9b",
  "prompt": "Hola, ¿cómo estás?",
  "stream": false
}'
OLLAMA_HOST=0.0.0.0 expone la API de Ollama en todas las interfaces de red. No expongas el puerto 11434 a Internet. Usa reglas de Firewall o la configuración de red de QNAP para restringir el acceso solo a tu red local.Solución de problemas
El contenedor se cierra inmediatamente después de iniciar
Esto puede ser causado por insuficiente RAM o incompatibilidad del controlador de GPU. Revisa los registros del contenedor en Container Station. Reduce las limitaciones de memoria o desactiva el modo GPU.
La descarga del modelo falla a mitad de camino
Esto puede ser resultado de espacio insuficiente en disco o tiempo de espera de red. Intenta liberar espacio en Almacenamiento. Vuelve a ejecutar ollama pull; el sistema se reanuda desde donde se detuvo.
La velocidad de respuesta es muy lenta (1–3 tokens por segundo)
El modelo puede estar ejecutándose en CPU en lugar de GPU, o el modelo es demasiado grande para tu RAM. Verifica el acceso a tu GPU con nvidia-smi dentro del contenedor. Intenta usar un modelo más pequeño.
El NAS se vuelve no responsivo durante la inferencia
Esto puede ser un problema de "falta de memoria": el modelo está consumiendo toda la memoria del sistema. Recomendamos reiniciar el NAS. Establece un límite de uso de memoria en la aplicación. O utiliza un modelo más pequeño.
Mensaje "No se puede conectar a Ollama" desde Open WebUI
Esto puede ser causado por una URL de API incorrecta o aislamiento de red de Docker. Puedes usar http://ollama:11434 si estás en la misma red de Docker.
Para obtener más ayuda, pregunte a otros usuarios y a los expertos de QNAP en la comunidad. Ir a la comunidad de QNAP


