


Como implementar Ollama no NAS QNAP usando Container Station
Produtos Aplicáveis
QTS, QuTS hero
Container Station
Cenário
Pretende executar modelos de linguagem grandes (LLMs) localmente no seu NAS QNAP para chat privado de IA, assistência de código ou análise de documentos sem enviar dados para a nuvem. Ollama é o motor de inferência mais popular e amigável para iniciantes para este propósito. Este tutorial explica como implementar Ollama no NAS QNAP usando Container Station.
Requisitos do Sistema
| Requisito | Detalhe |
|---|---|
| App QNAP | Container Station 3.x ou posterior |
| Arquitetura NAS | x86_64 (CPU Intel ou AMD) (Apenas alguns modelos baseados em ARM são suportados.) |
| Memória |
|
| Espaço Armazenamento |
|
| GPU (Opcional) | GPUs NVIDIA compatíveis (ver o Lista de compatibilidade) A GPU deve ser configurada para o Modo Container Station no Painel de Controlo. |
O Ollama tentará carregar todo o modelo na memória por padrão. Se o seu NAS tiver apenas 8–16 GB de RAM, carregar um modelo de 14B ou maior pode esgotar a memória do sistema, fazendo com que os serviços NAS se tornem não responsivos ou o sistema reinicie.
Risco de Perda de Dados
Se não montar um volume persistente para
/root/.ollama, todos os modelos e configurações descarregados serão perdidos quando o contentor for removido ou recriado. Siga sempre as instruções de montagem de volume neste tutorial.- Verifique o tamanho do modelo em relação à RAM disponível antecipadamente.
- Defina limites de memória para limitar o uso de memória do contentor.
- Comece com modelos pequenos (1B ou 3B) e avalie a estabilidade do sistema antes de tentar modelos maiores.
Procedimento
Método 1: Implementação Apenas com CPU (Sem GPU Necessária)
Crie pastas Armazenamento.
Abra File Station e crie a seguinte pasta para armazenar dados do modelo Ollama:
/share/Container/ollama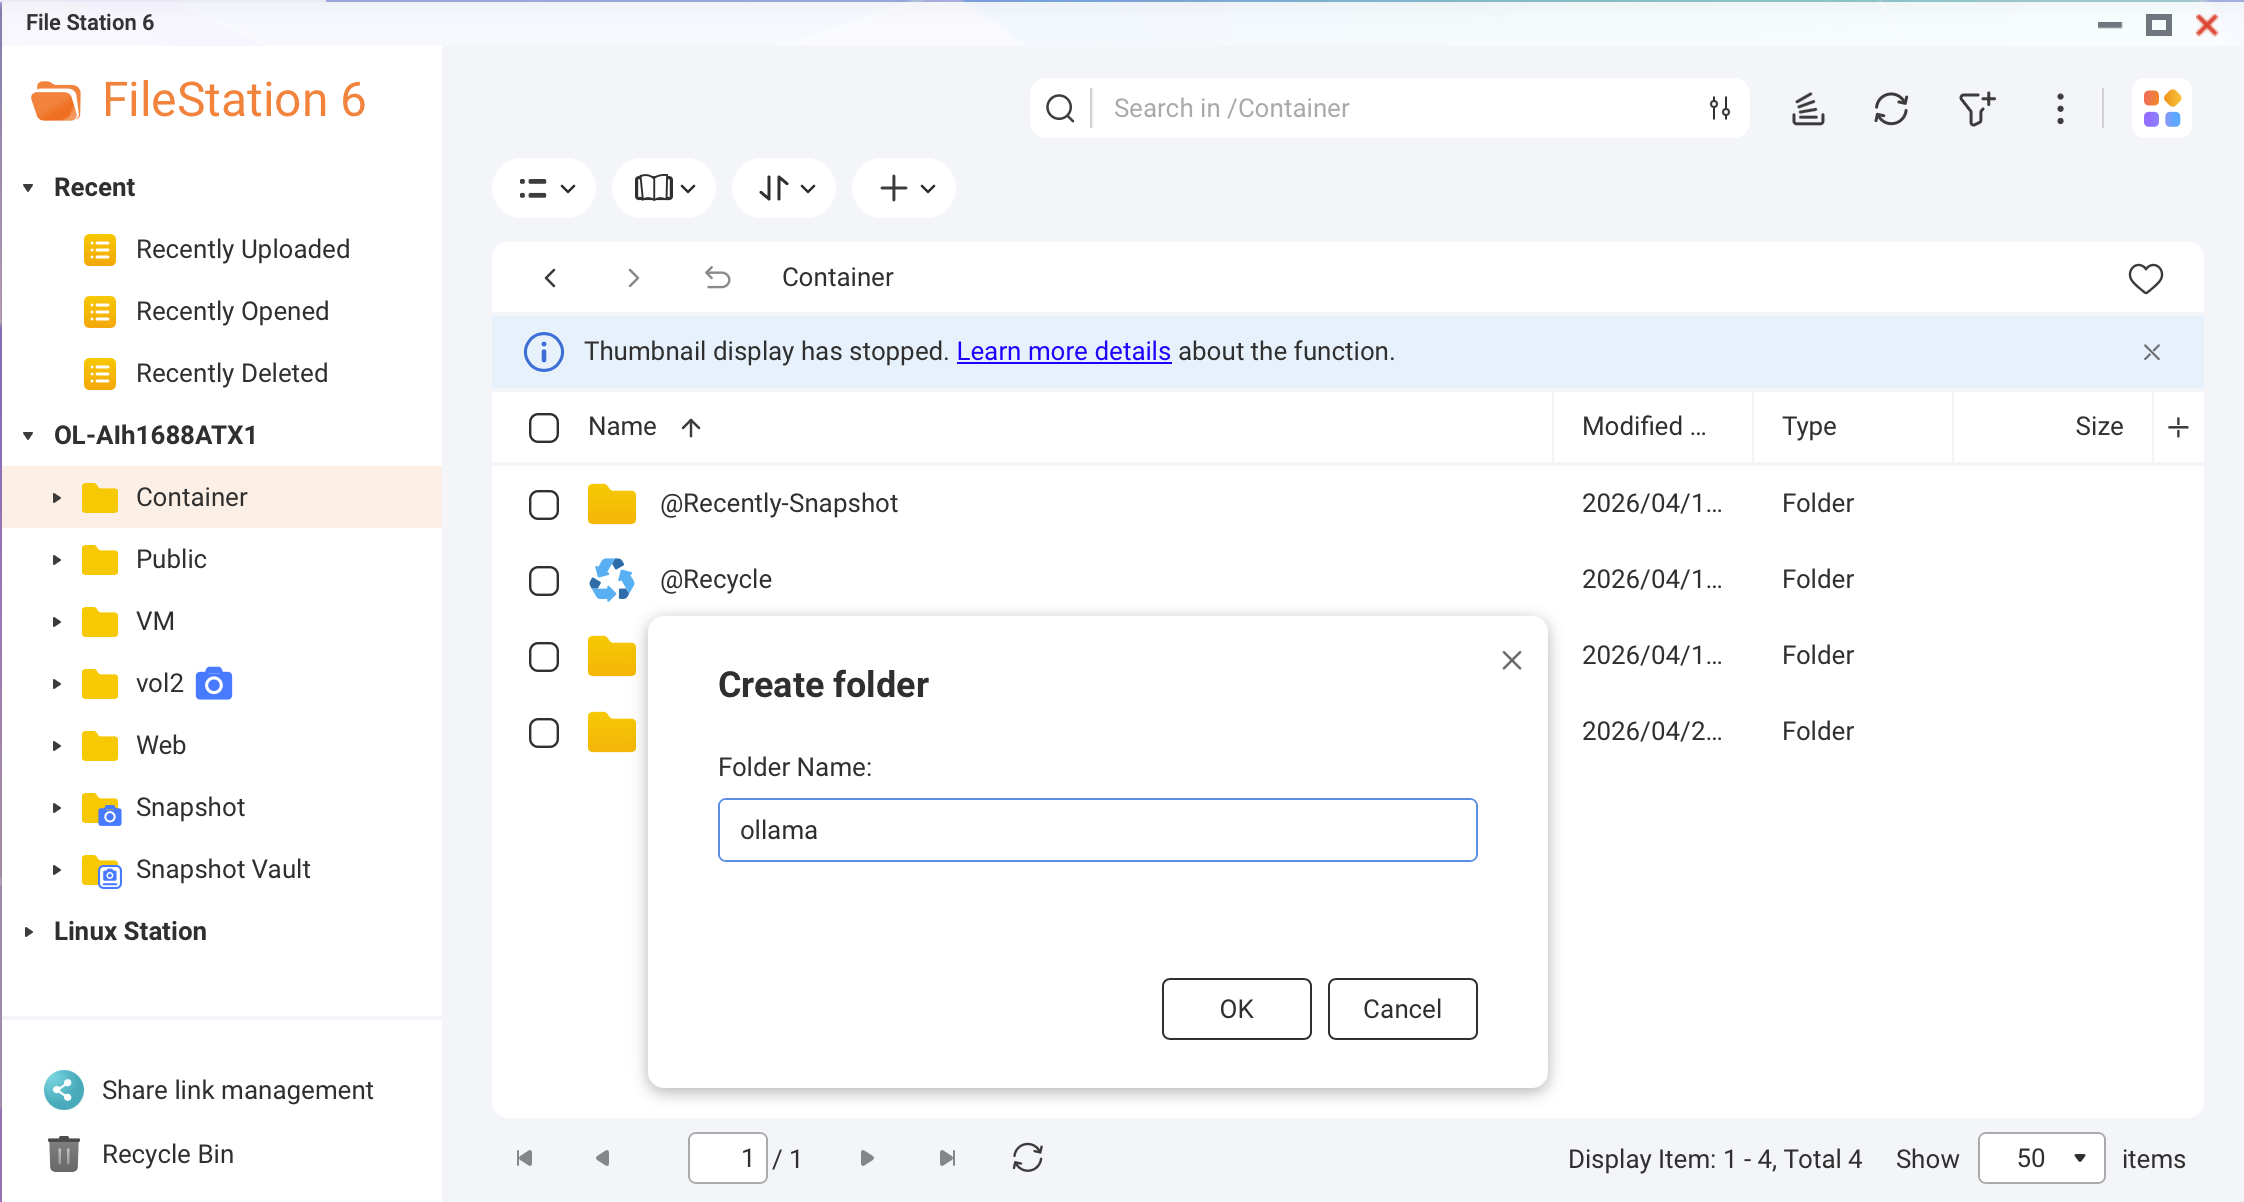 Captura de ecrã: File Station — criando a pasta Ollama em /share/Container/Melhores PráticasSe o seu NAS tiver uma cache SSD NVMe ou volume SSD, crie esta pasta no SSD. A velocidade de carregamento do modelo melhora até 10 vezes em comparação com HDDs.
Crie um ficheiro Docker Compose.
No Container Station, vá para Aplicações > Criar. Nomeie a aplicação
ollamae cole o seguinte YAML:version: "3.8" services: ollama: image: ollama/ollama:latest container_name: ollama restart: unless-stopped ports: - "11434:11434" volumes: - /share/Container/ollama:/root/.ollama environment: - OLLAMA_HOST=0.0.0.0 - OLLAMA_KEEP_ALIVE=10m networks: - ai-network networks: ai-network: name: ai-network driver: bridge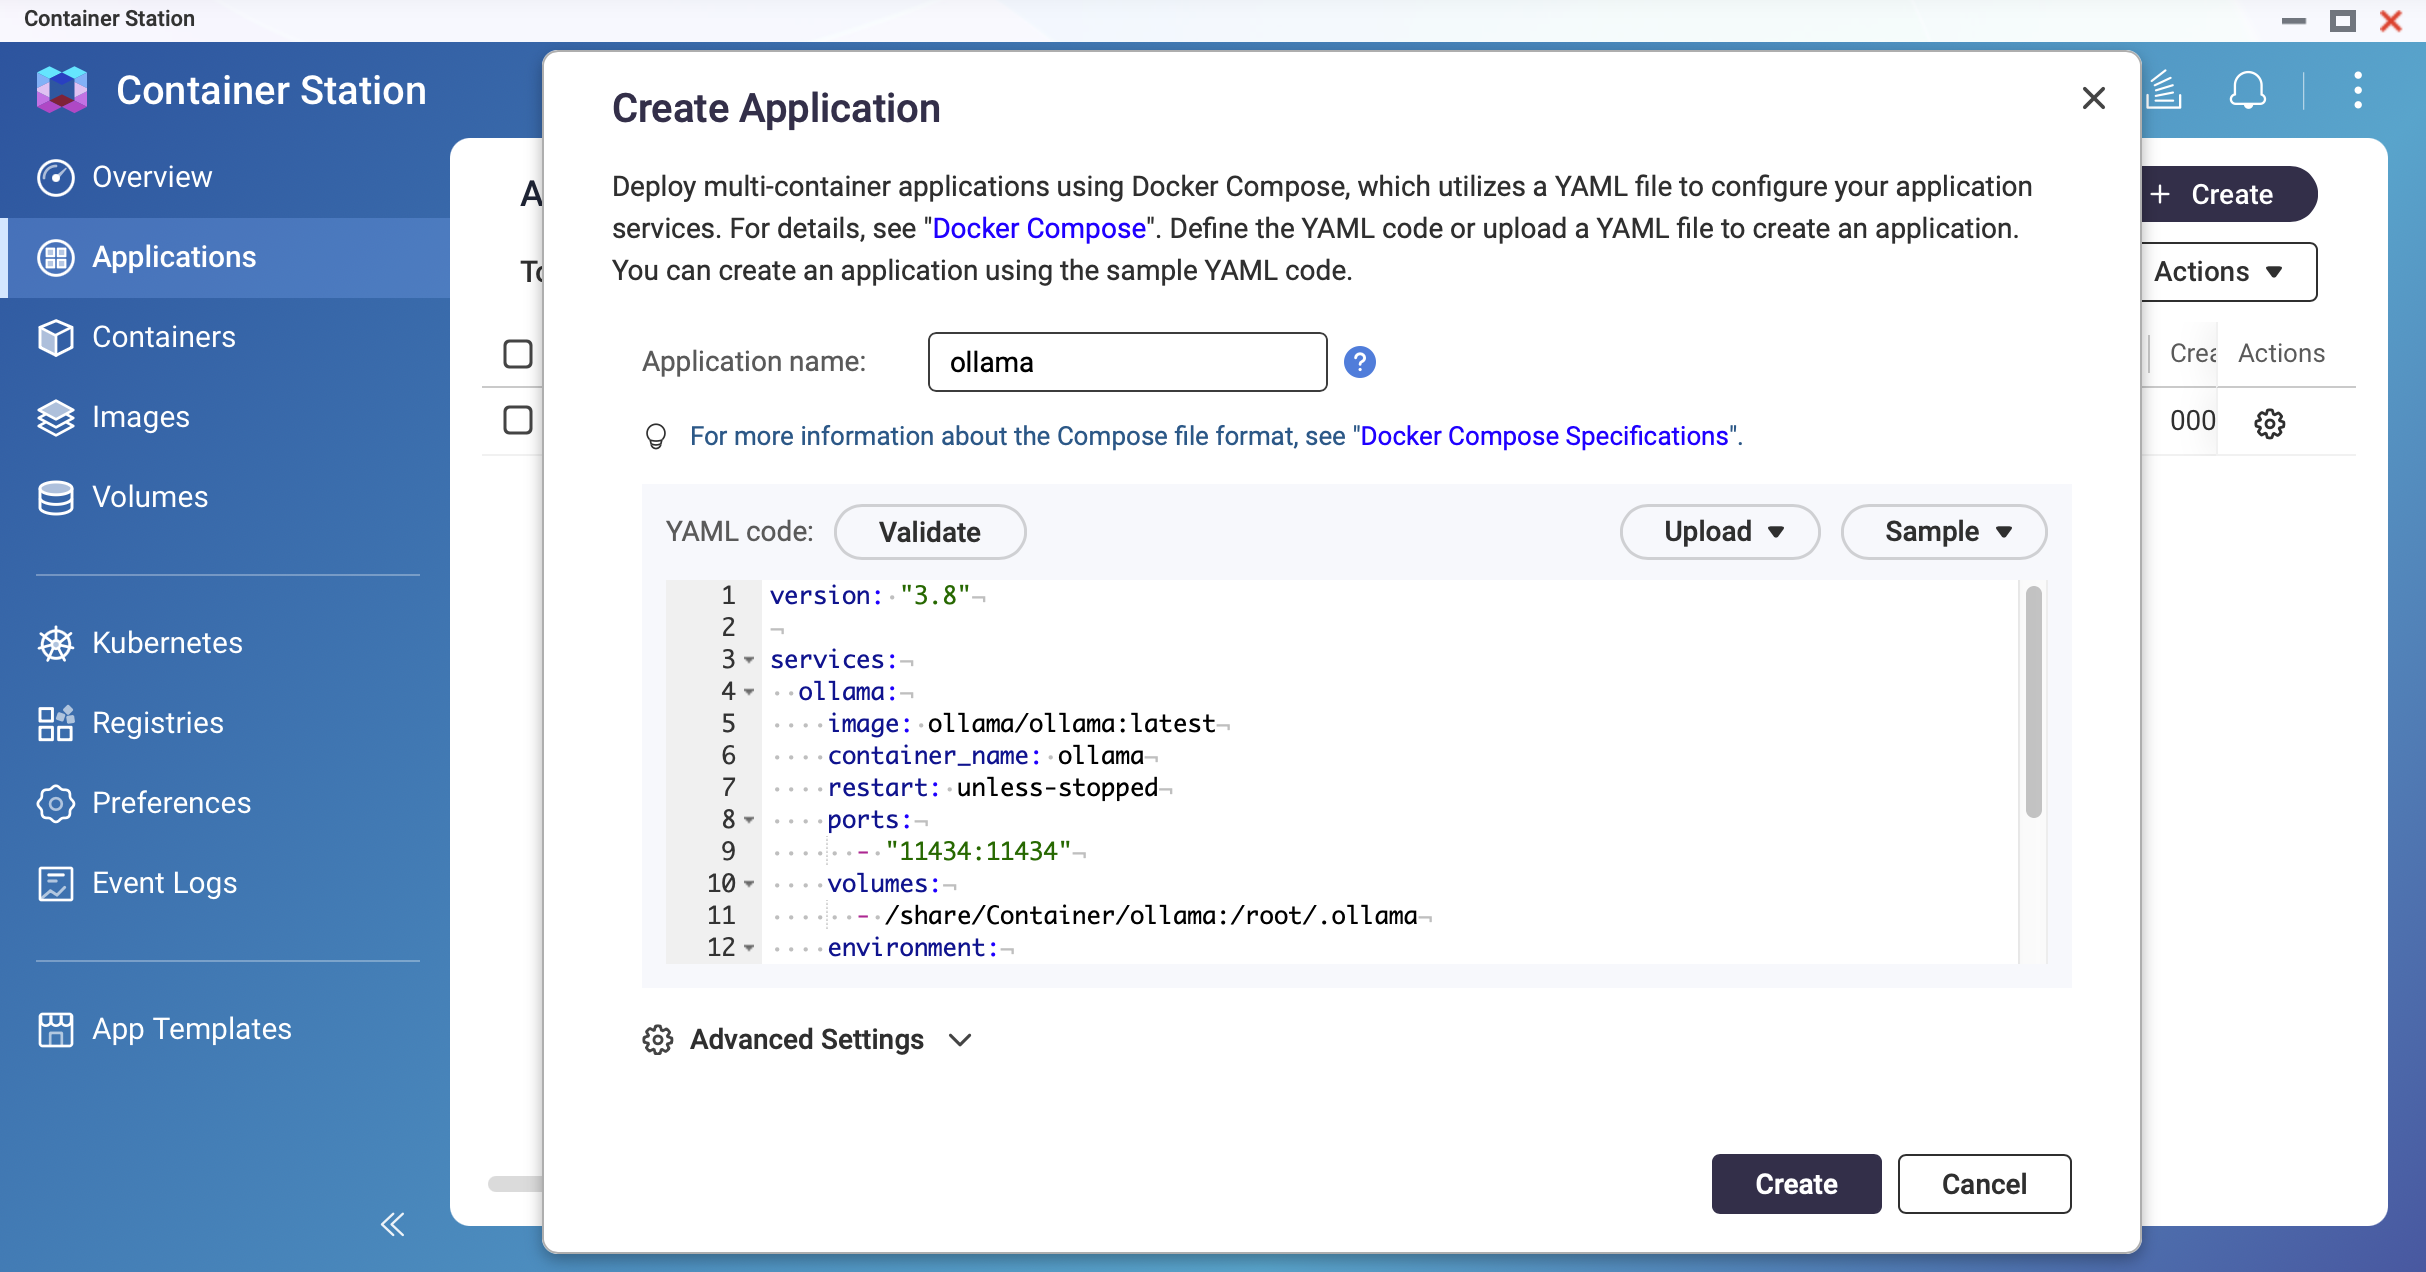 Captura de ecrã: Container Station — ecrã de criação de aplicação com editor YAML
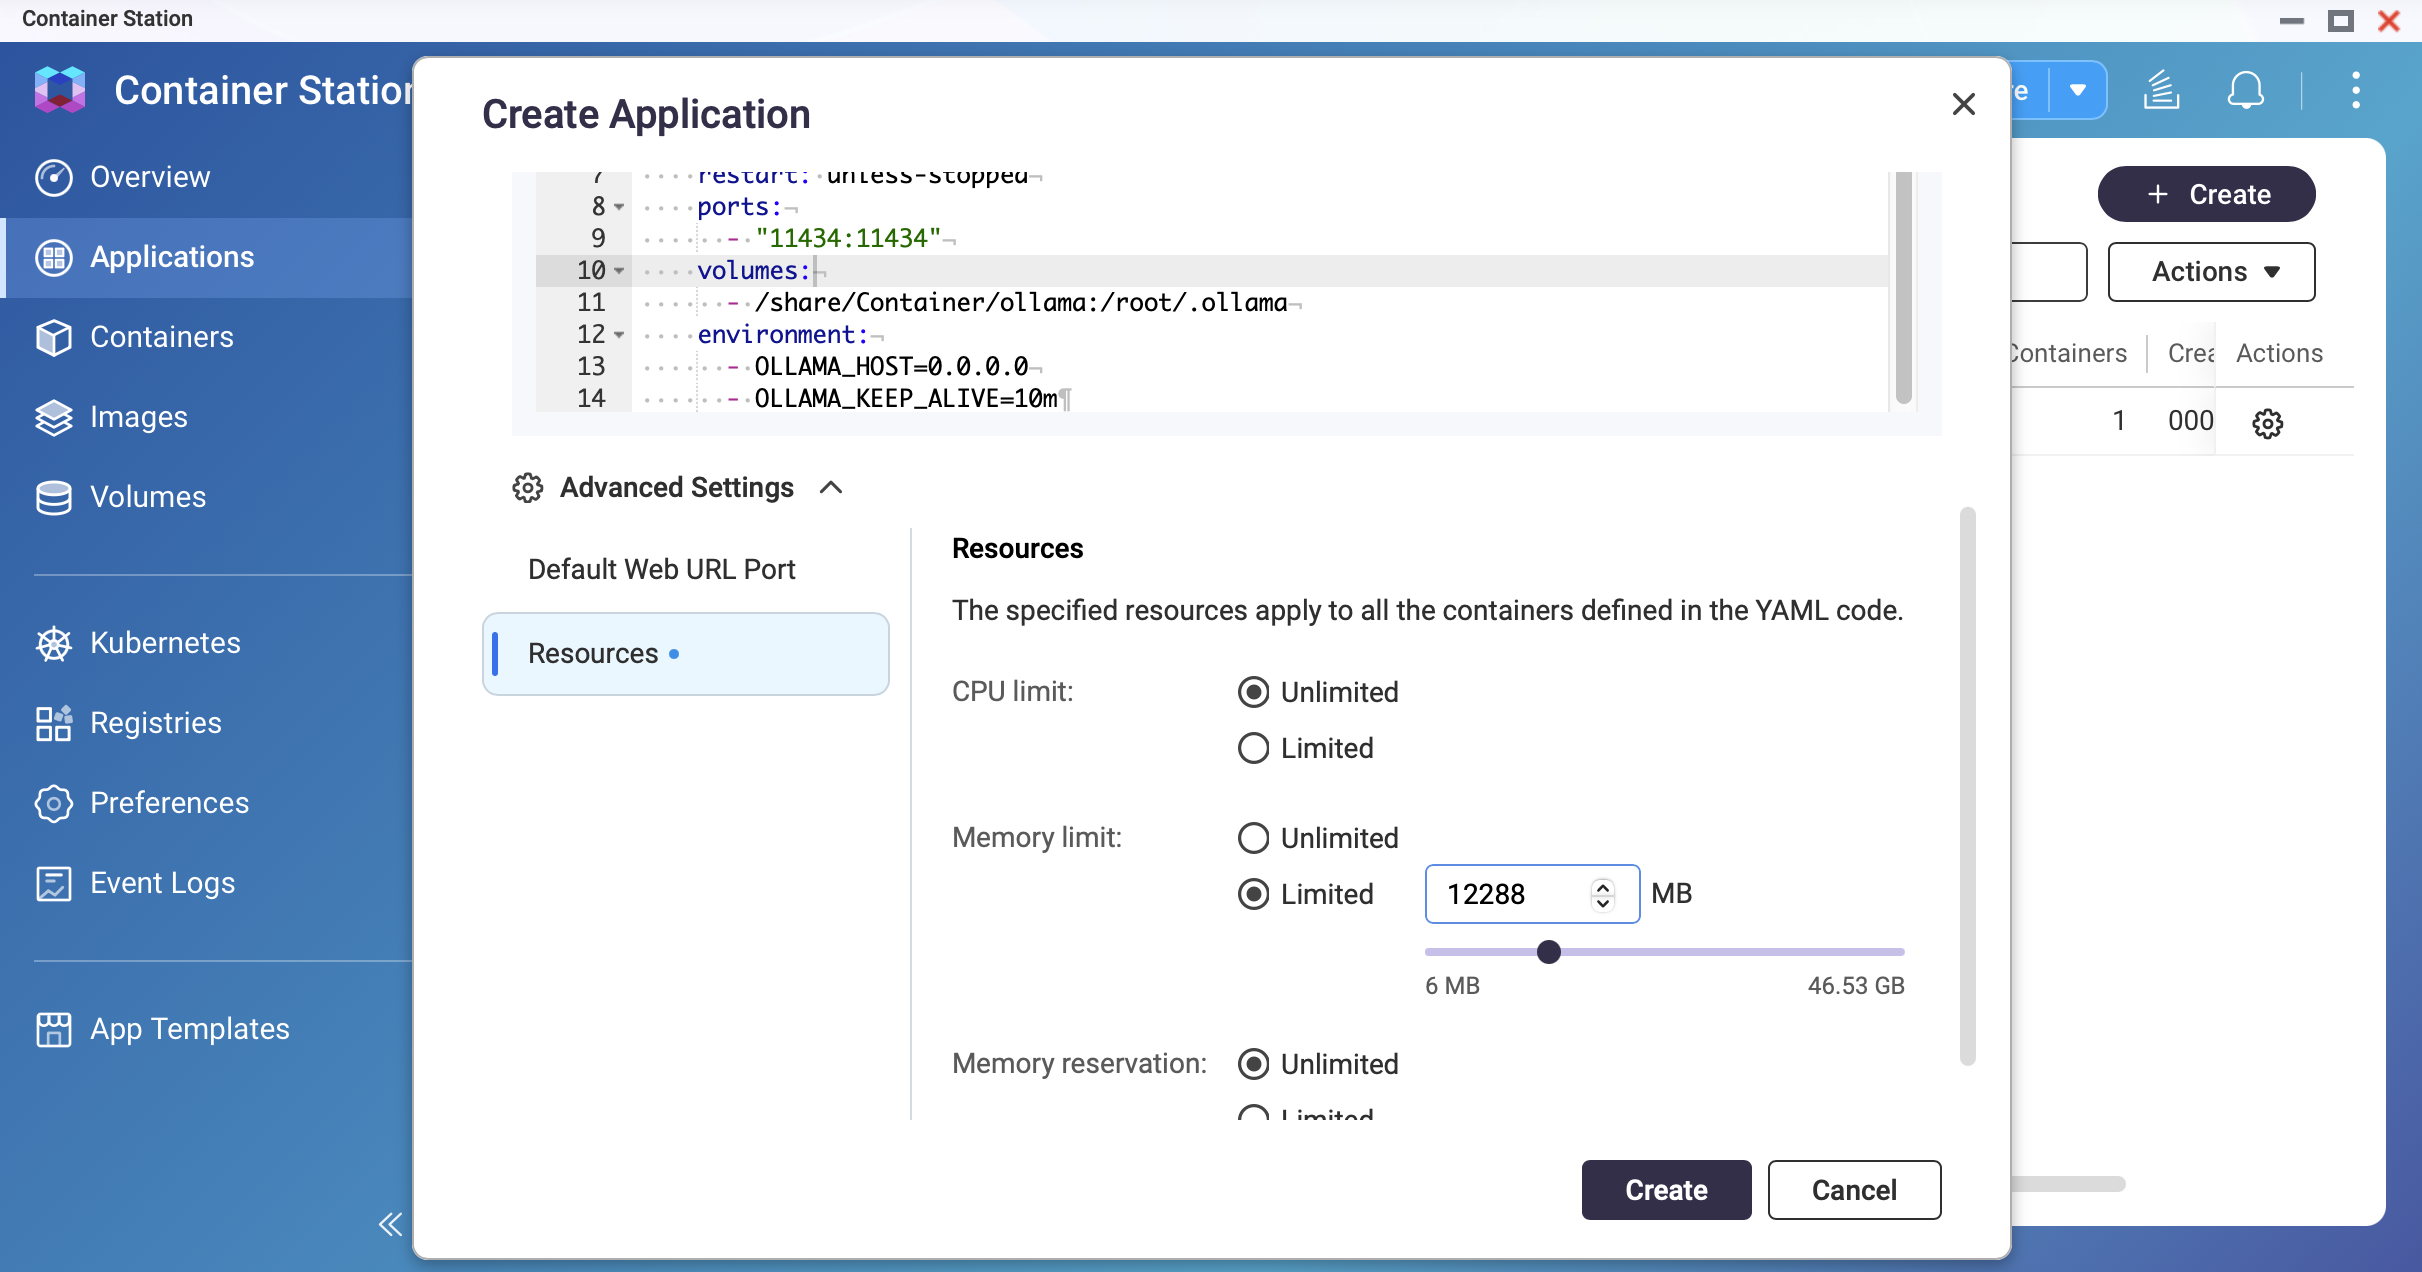 Captura de ecrã: Container Station — Defina o limite de memória
Implemente o contentor.
Clique em Criar. Container Station irá puxar a imagem Ollama e iniciar o contentor. Aguarde até que o estado mostre A correr.
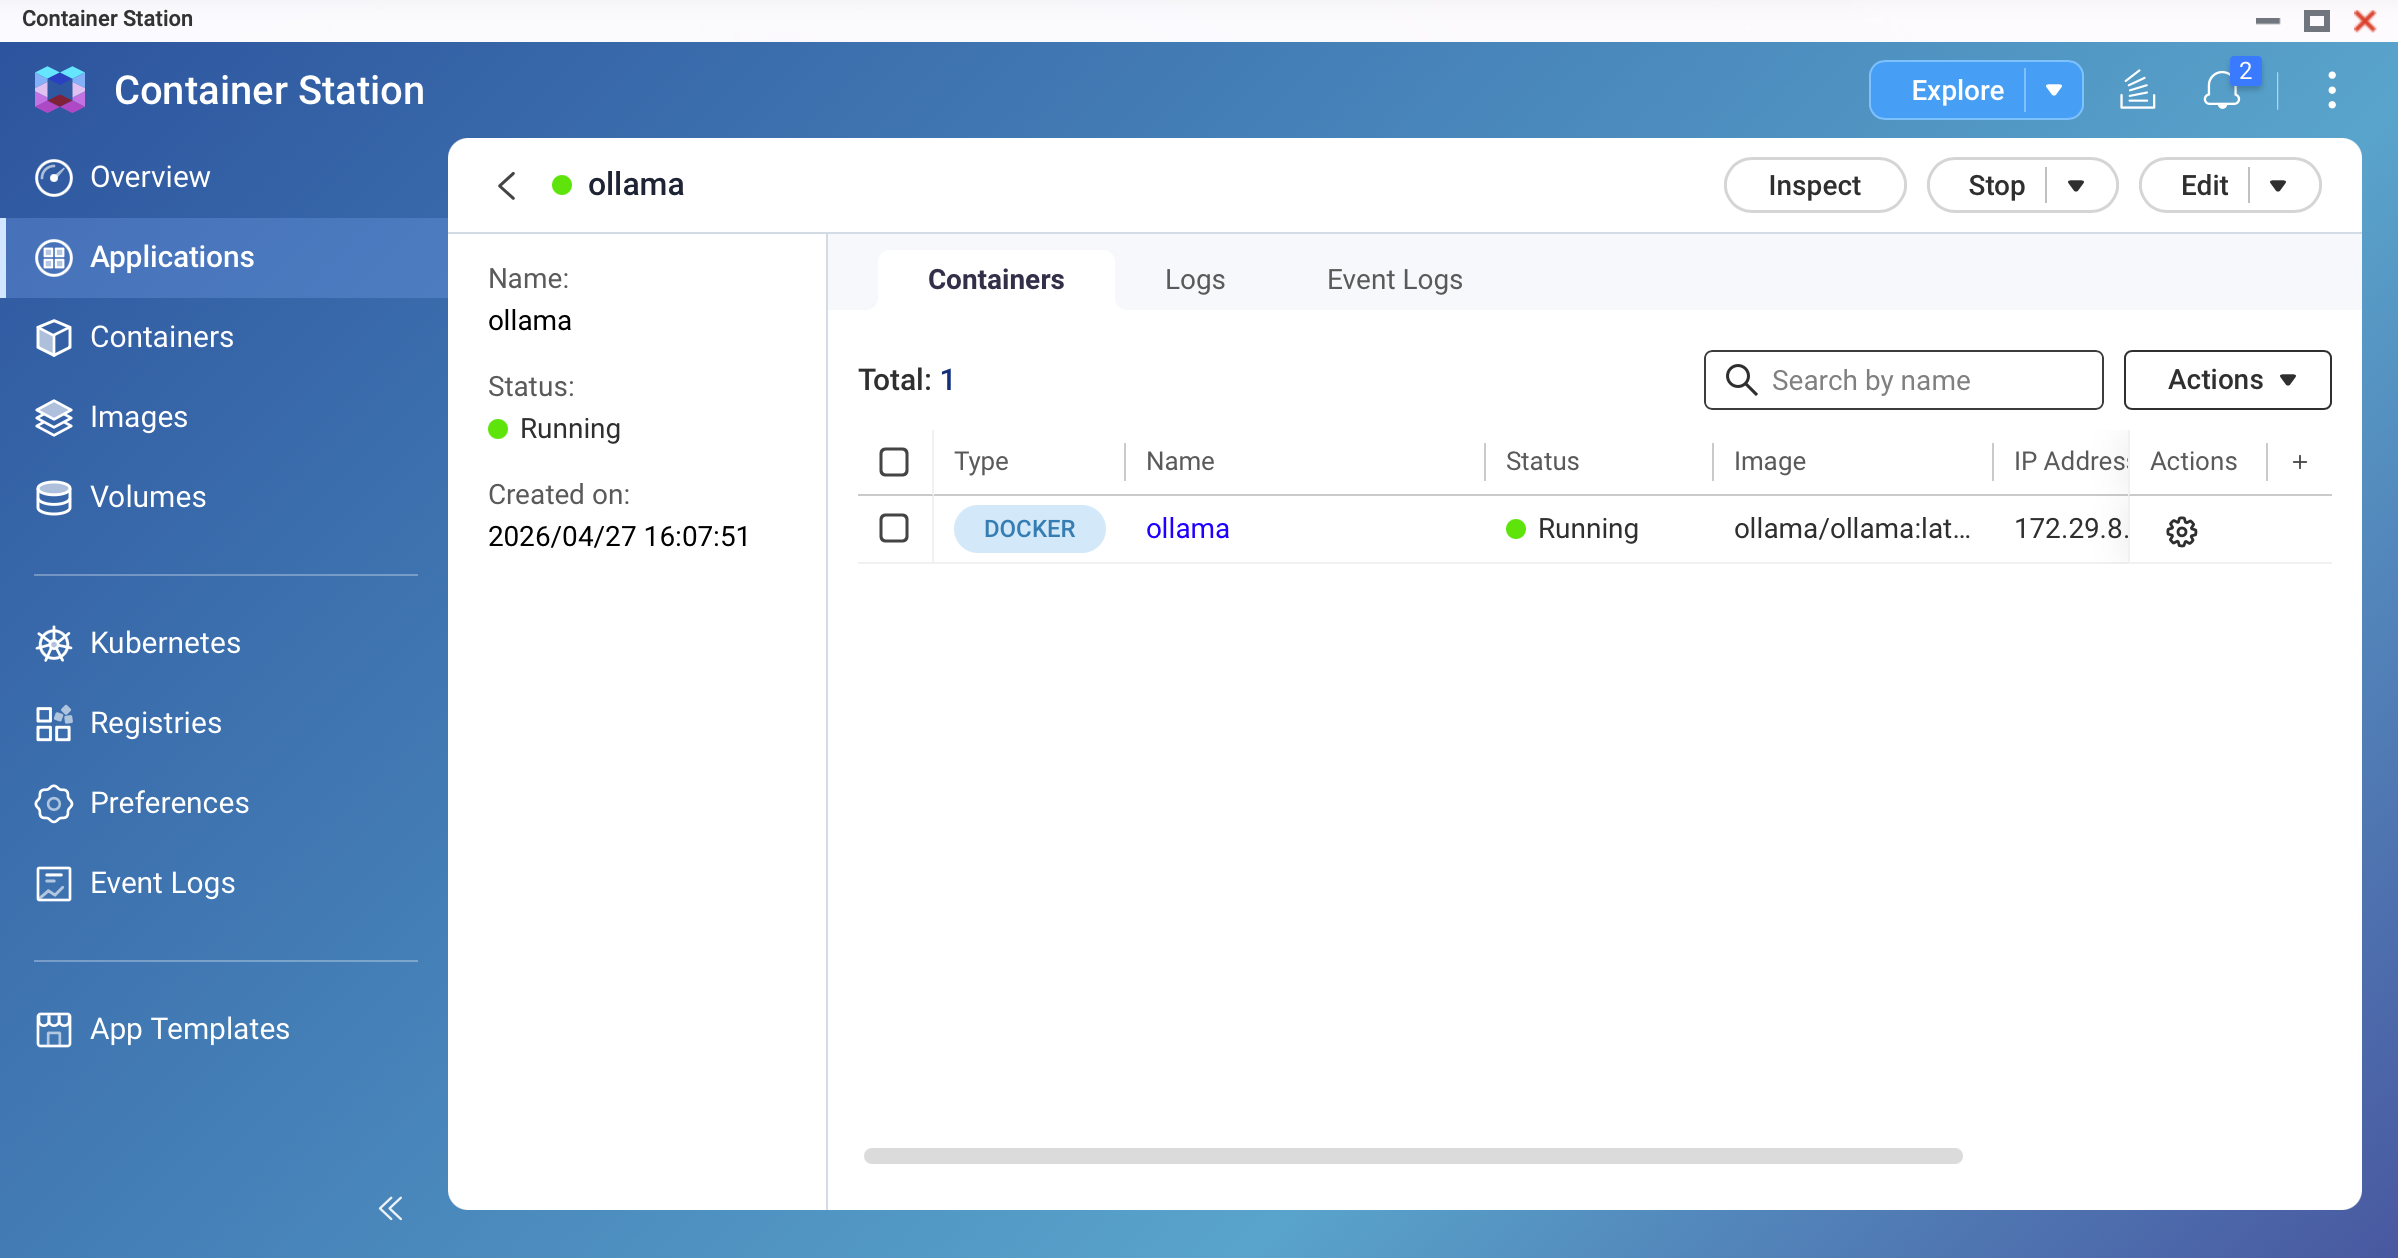 Captura de ecrã: Container Station — contentor ollama mostrando estado "A correr"
Puxe o seu primeiro modelo.
Abra o Terminal do contentor (ou aceda ao seu NAS via SSH e execute o seu Docker) e execute:
# Para um modelo 3B leve (recomendado para o primeiro teste): ollama pull llama3.2:3b # Para um modelo 9B padrão (requer 16 GB+ RAM): ollama pull qwen3.5:9bO download pode demorar vários minutos, dependendo da velocidade da sua internet. Um modelo 9B Q4_K_M tem aproximadamente 4–7 GB.
Nota- Verifique se tem espaço suficiente em disco antes de puxar. Use
ollama listpara verificar os modelos existentes e os seus tamanhos. - Para modelos NAS baseados em ARM, recomendamos começar com o modelo <1B para monitorizar o uso de memória.
- Verifique se tem espaço suficiente em disco antes de puxar. Use
Teste o modelo.
No terminal do contentor, execute:
ollama run qwen3.5:9bDigite um prompt e confirme que recebe uma resposta. Digite
/byepara sair.
Método 2: Implementação Acelerada por GPU NVIDIA
Pré-requisitos adicionais para o Modo GPU:
- GPU NVIDIA instalada e detetada pelo QTS/QuTS hero
- GPU configurada para o Modo Container Station no Painel de Controlo
- Driver NVIDIA GPU e NvKernelDriver instalados a partir de App Center
Utilize a configuração de Compose Docker com suporte para GPU.
Substitua o YAML do Método 1 pelo seguinte:
version: "3.8" services: ollama: image: ollama/ollama:latest container_name: ollama restart: unless-stopped ports: - "11434:11434" volumes: - /share/Container/ollama:/root/.ollama environment: - OLLAMA_HOST=0.0.0.0 - OLLAMA_KEEP_ALIVE=10m - NVIDIA_VISIBLE_DEVICES=all deploy: resources: reservations: devices: - driver: nvidia count: all capabilities: [gpu] networks: - ai-network networks: ai-network: name: ai-network driver: bridge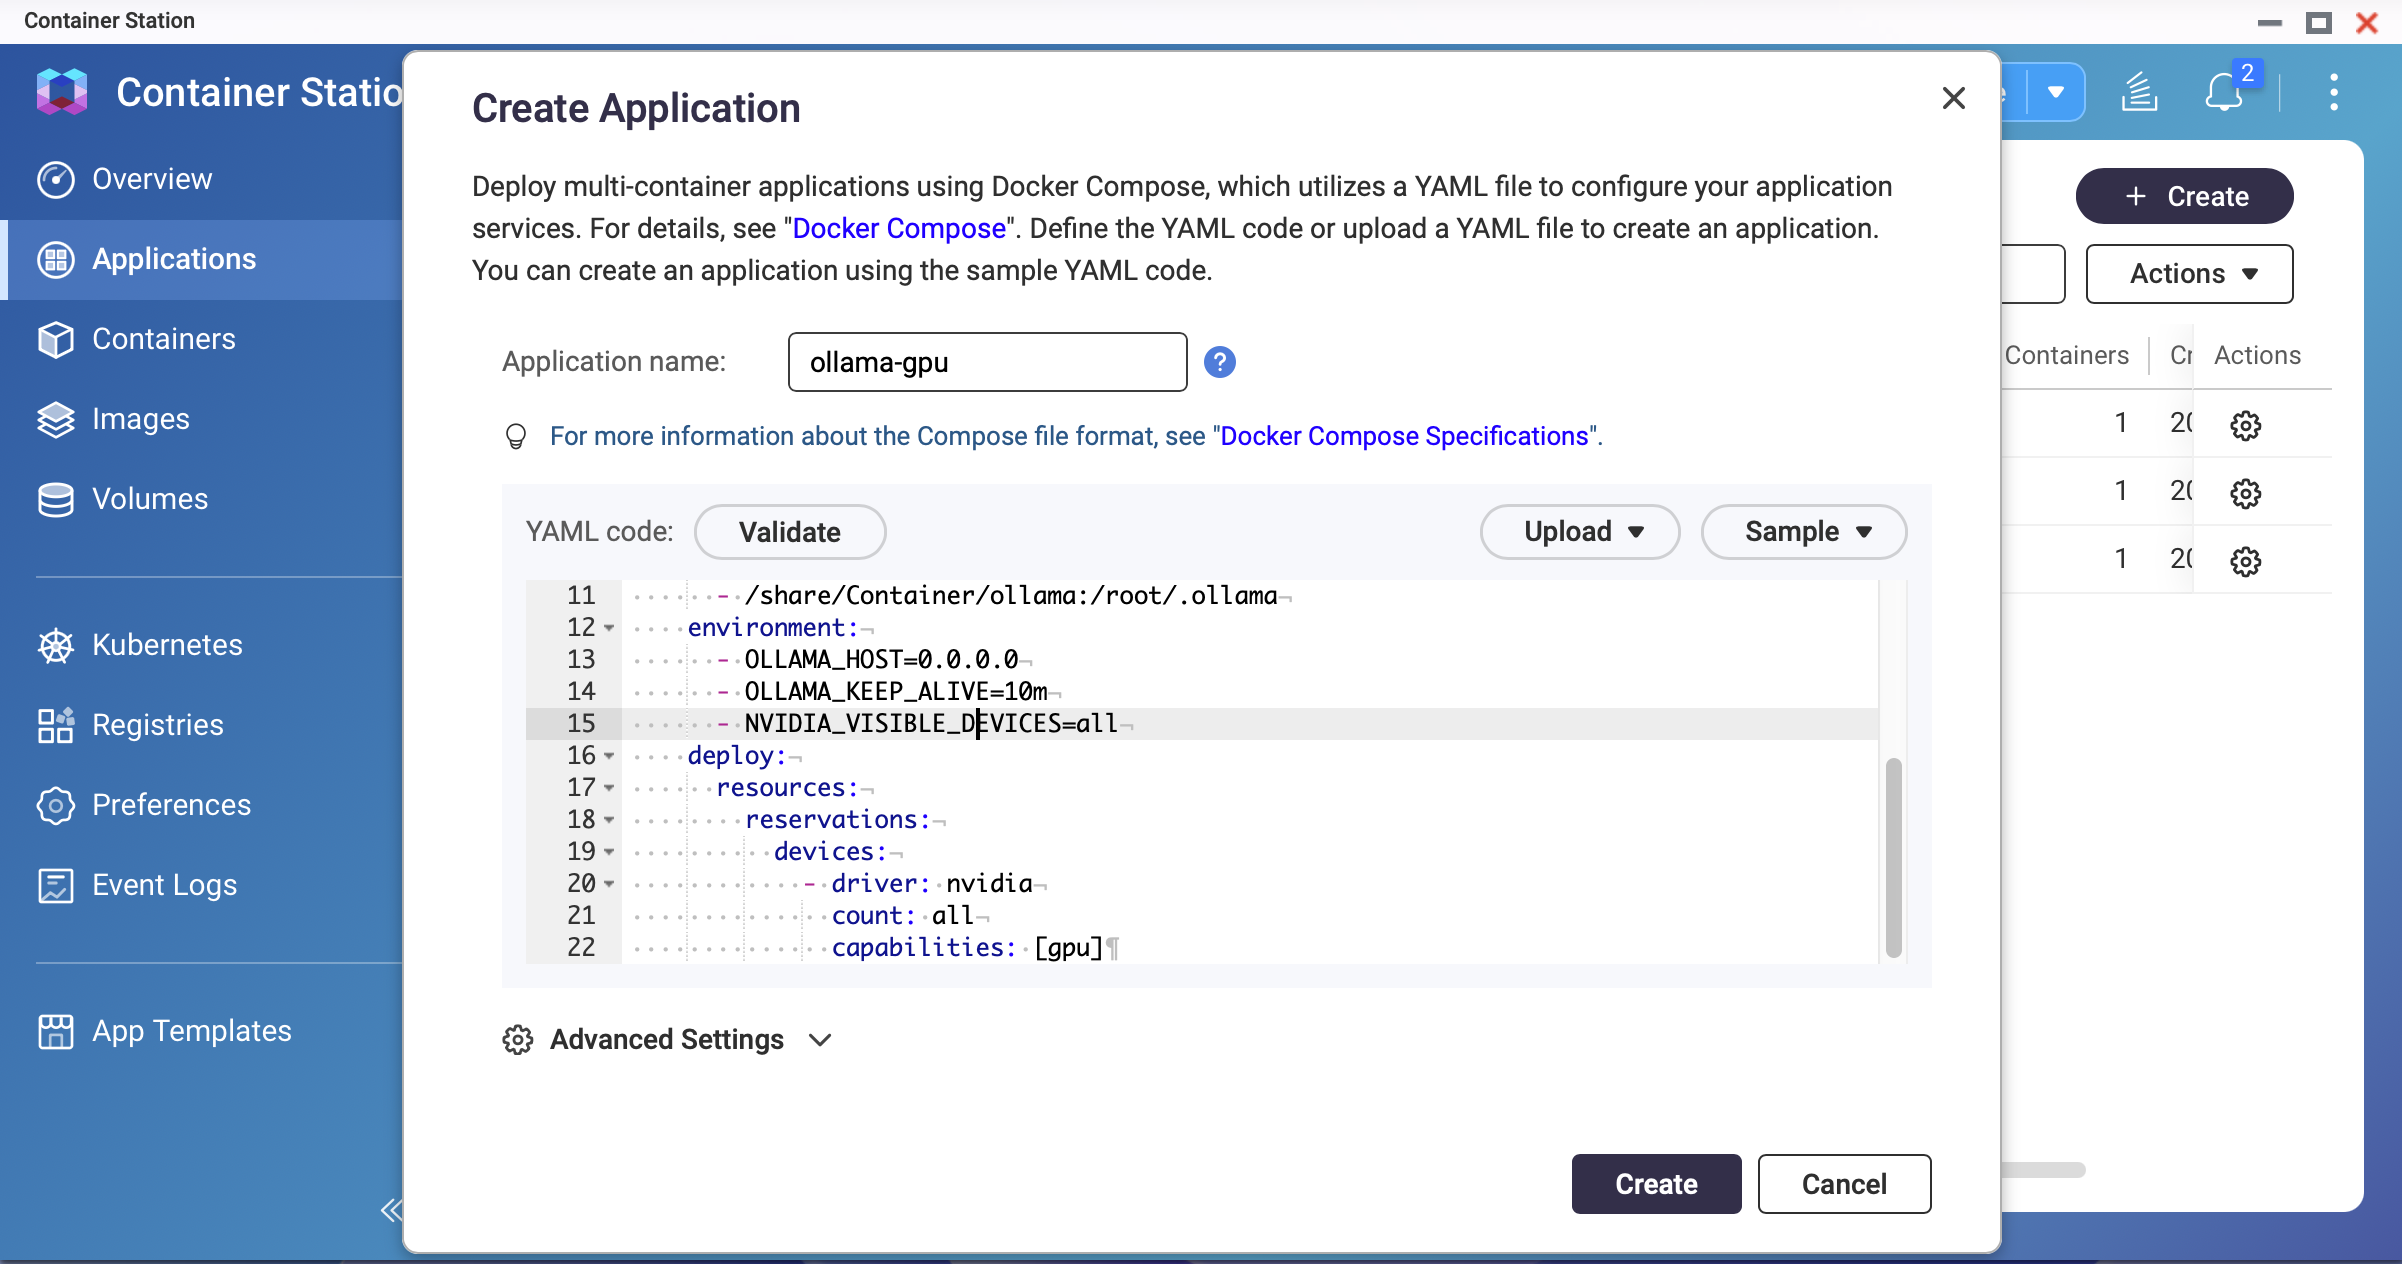 Captura de ecrã: Container Station — Compose YAML com suporte para GPU DockerNotaOs drivers NVIDIA fornecidos pela QNAP podem ser mais antigos do que a versão mais recente. Se o contentor não iniciar com GPU ativada, verifique a versão do driver com
nvidia-smino host e certifique-se de que é compatível com a versão da imagem OllamaImplemente e verifique o acesso à GPU.
Após o início do contentor, abra o seu terminal e execute:
nvidia-smiDeverá ver o modelo da sua GPU, a versão do driver e informações de memória.
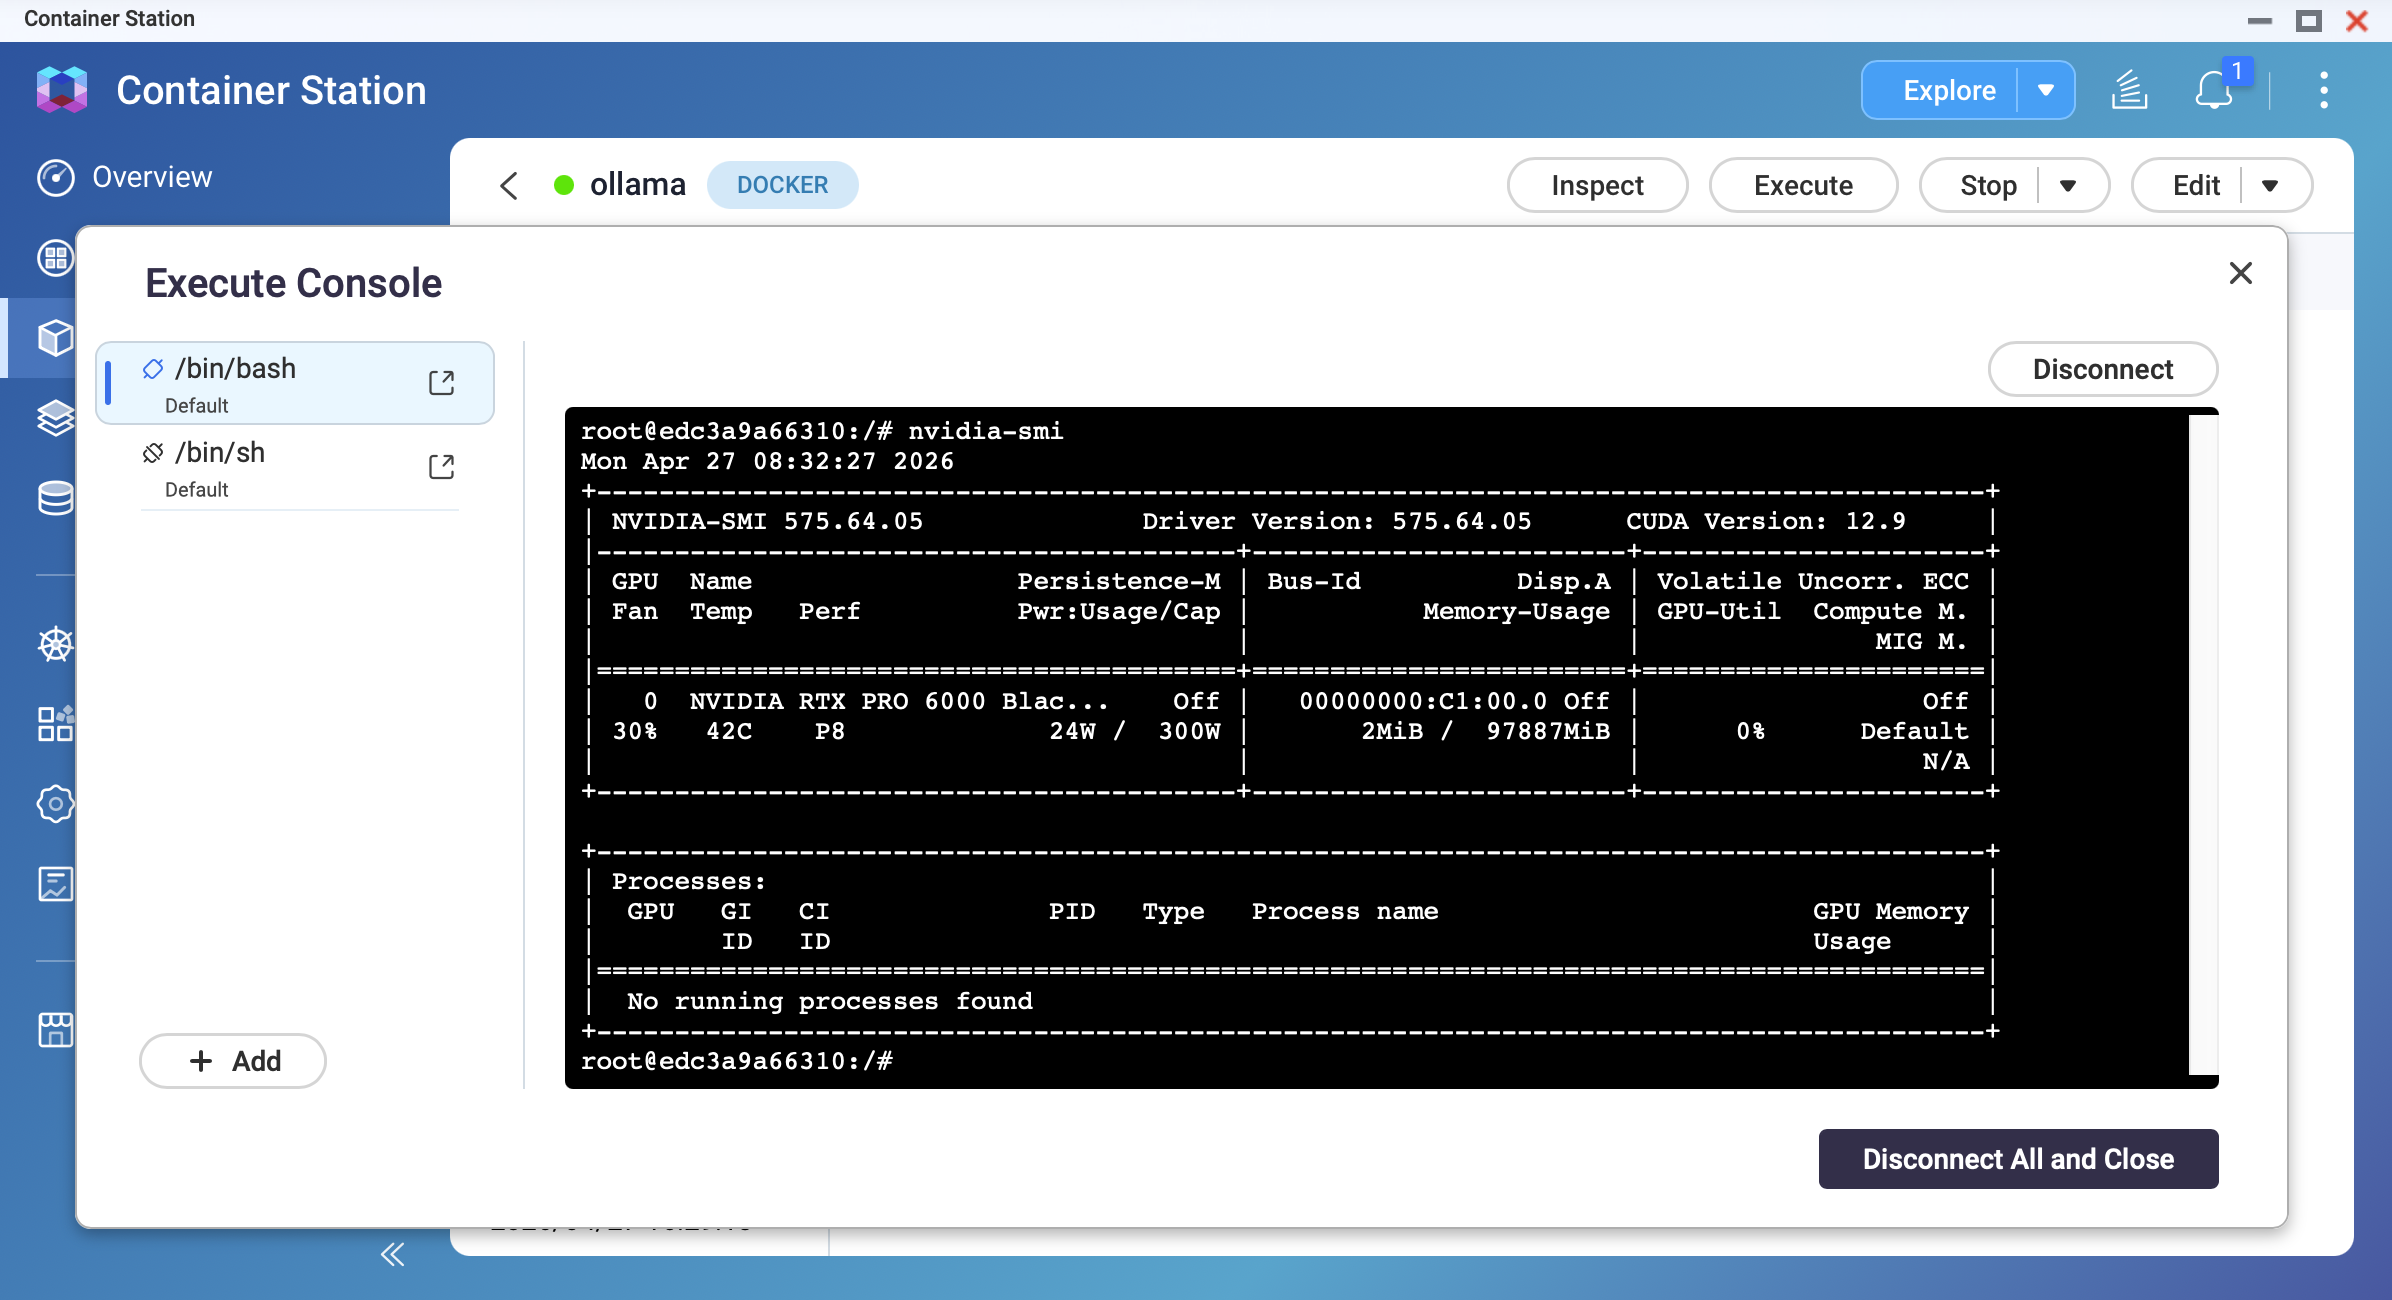
Transfira um modelo e confirme a aceleração da GPU.
ollama pull qwen3.5:9b ollama run qwen3.5:9bEnquanto o modelo está a gerar uma resposta, abra outro terminal e execute
nvidia-smi. Deverá observar o aumento do uso de memória da GPU e da utilização da GPU.
Resultado
Após completar este tutorial, terá:
- Ollama a funcionar no seu NAS QNAP em
http://<NAS-IP>:11434 - Dados do modelo persistidos em
/share/Container/ollama(sobrevivem a reconstruções de contentores) - Um LLM funcional acessível através da API Ollama
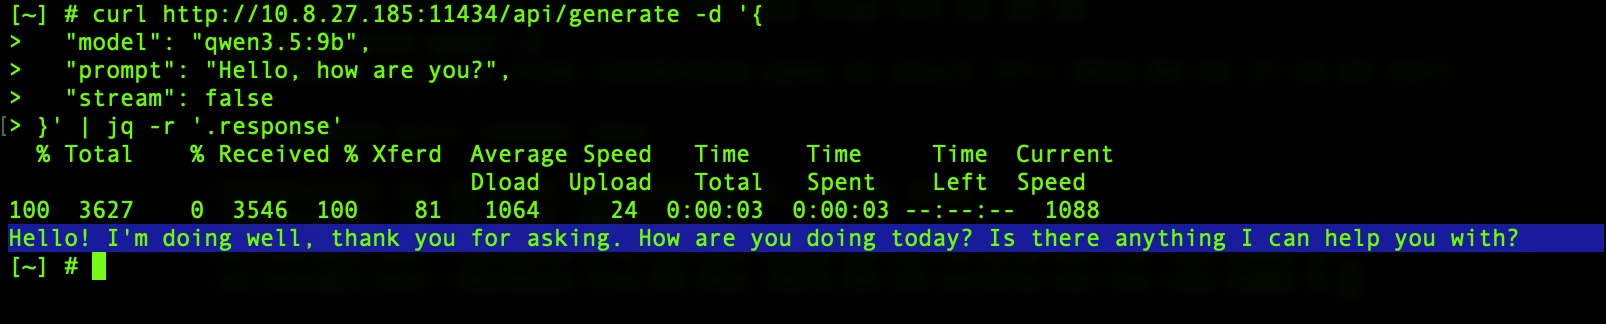
Pode testar a API a partir de qualquer dispositivo na sua rede local:
curl http://<NAS-IP>:11434/api/generate -d '{
  "model": "qwen3.5:9b",
  "prompt": "Olá, como está?",
  "stream": false
}'
OLLAMA_HOST=0.0.0.0 expõe a API Ollama em todas as interfaces de rede. Não exponha a porta 11434 à internet. Utilize regras Firewall ou as definições de rede da QNAP para restringir o acesso apenas à sua rede local.Resolução de problemas
O contentor sai imediatamente após iniciar
Isso pode ser causado por RAM insuficiente ou incompatibilidade de drivers da GPU. Verifique os logs do contentor em Container Station. Reduza as limitações de memória ou desative o modo GPU.
Falha na transferência do modelo a meio
Isso pode resultar de espaço insuficiente em disco ou timeout de rede. Tente liberar espaço em Armazenamento. Execute novamente ollama pull; o sistema retoma de onde parou.
A velocidade de resposta é muito lenta (1–3 tokens por segundo)
O modelo pode estar a funcionar no CPU em vez de na GPU, ou o modelo é demasiado grande para a sua RAM. Verifique o acesso à GPU com nvidia-smi dentro do contentor. Tente usar um modelo menor.
O NAS torna-se não responsivo durante a inferência
Isso pode ser um problema de "falta de memória": o modelo está a consumir toda a memória do sistema. Recomendamos reiniciar o NAS. Defina um limite de uso de memória na aplicação. Ou use um modelo menor.
Mensagem "Não é possível conectar ao Ollama" do Open WebUI
Isso pode ser causado por um URL de API errado ou isolamento de rede Docker. Pode usar http://ollama:11434 se estiver na mesma rede Docker.
Para obter mais ajuda, pergunte a outros usuários e aos especialistas da QNAP na comunidade. Ir para a Comunidade QNAP


