


Jak nasadit Ollama na QNAP NAS pomocí Container Station
Použitelné produkty
QTS, QuTS hero
Container Station
Scénář
Chcete provozovat velké jazykové modely (LLM) lokálně na vašem QNAP NAS pro soukromý AI chat, asistenci při kódování nebo analýzu dokumentů bez odesílání dat do cloudu. Ollama je nejpopulárnější a uživatelsky nejpřívětivější inferenční engine pro tento účel. Tento návod vysvětluje, jak nasadit Ollama na QNAP NAS pomocí Container Station.
Požadavky na systém
| Požadavek | Detail |
|---|---|
| QNAP App | Container Station 3.x nebo novější |
| Architektura NAS | x86_64 (Intel nebo AMD CPU) (Podporováno je pouze několik modelů založených na ARM.) |
| Paměť |
|
| Úložiště Prostor |
|
| GPU (Volitelné) | Kompatibilní NVIDIA GPU (viz Seznam kompatibilních zařízení) GPU by mělo být nastaveno na Container Station Režim v Ovládací panely. |
Ollama se pokusí načíst celý model do paměti ve výchozím nastavení. Pokud má váš NAS pouze 8–16 GB RAM, načtení modelu 14B nebo většího může vyčerpat systémovou paměť, což způsobí, že služby NAS přestanou reagovat nebo se systém restartuje.
Riziko ztráty dat
Pokud nenamontujete trvalý svazek pro
/root/.ollama, všechny stažené modely a konfigurace budou ztraceny, když bude kontejner odstraněn nebo znovu vytvořen. Vždy dodržujte pokyny pro montáž svazku v tomto návodu.- Předem zkontrolujte velikost modelu vůči dostupné RAM.
- Nastavte limity paměti pro omezení využití paměti kontejneru.
- Začněte s malými modely (1B nebo 3B) a posuďte stabilitu systému před pokusem o větší modely.
Postup
Metoda 1: Nasazení pouze s CPU (není vyžadováno GPU)
Vytvořte složky Úložiště.
Otevřete File Station a vytvořte následující složku pro uložení dat modelu Ollama:
/share/Container/ollama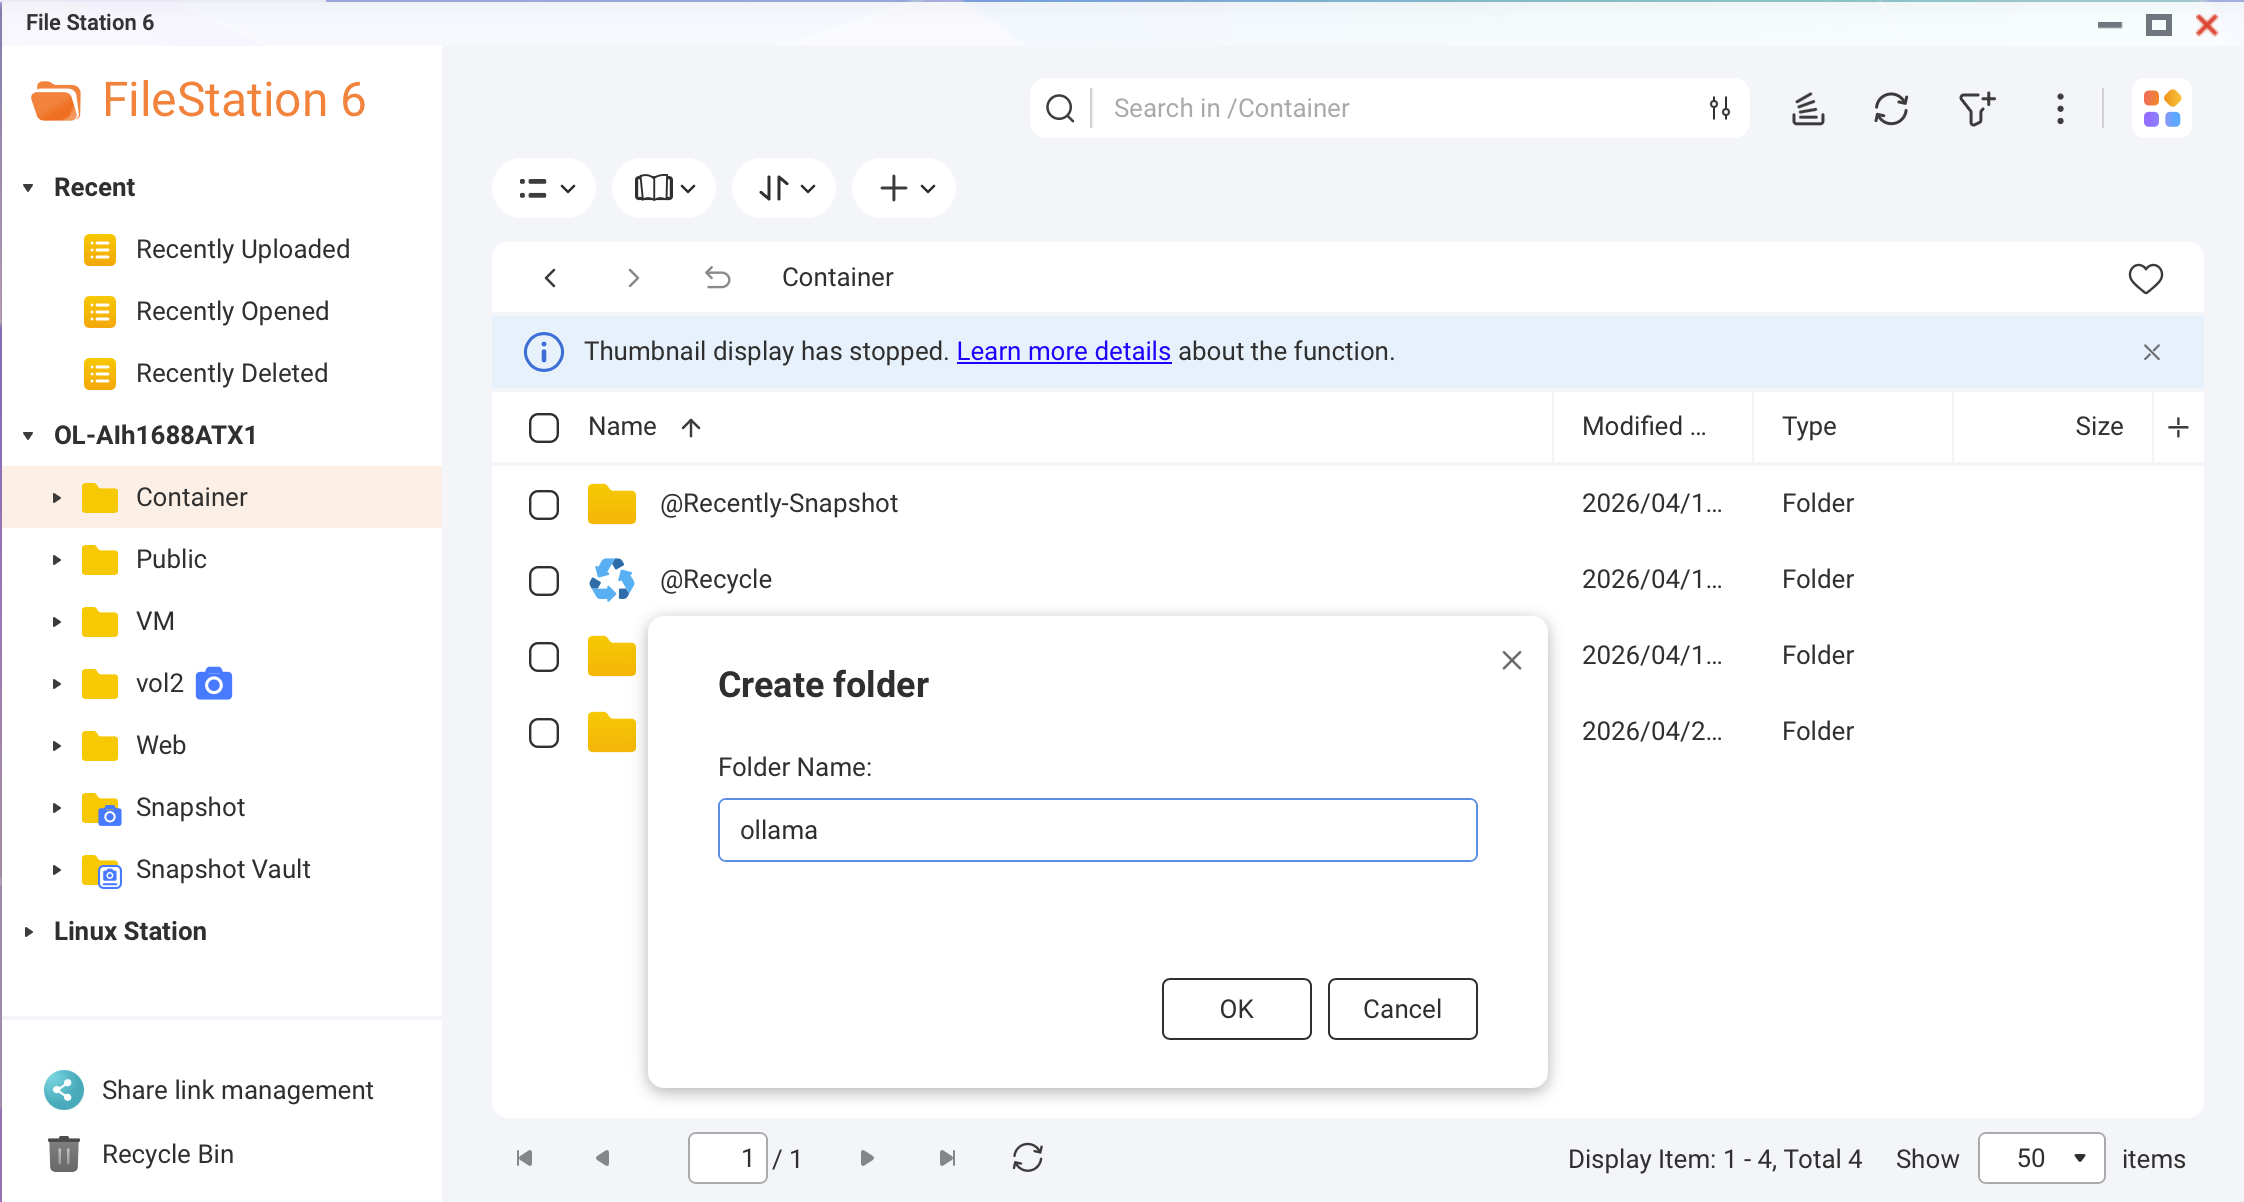 Snímek obrazovky: File Station — vytváření složky Ollama v /share/Container/Osvědčené postupyPokud má váš NAS NVMe SSD cache nebo SSD svazek, vytvořte tuto složku na SSD. Rychlost načítání modelu se zlepší až 10krát ve srovnání s HDD.
Vytvořte soubor Docker Compose.
V Container Station přejděte na Aplikace > Vytvořit. Pojmenujte aplikaci
ollamaa vložte následující YAML:version: "3.8" services: ollama: image: ollama/ollama:latest container_name: ollama restart: unless-stopped ports: - "11434:11434" volumes: - /share/Container/ollama:/root/.ollama environment: - OLLAMA_HOST=0.0.0.0 - OLLAMA_KEEP_ALIVE=10m networks: - ai-network networks: ai-network: name: ai-network driver: bridge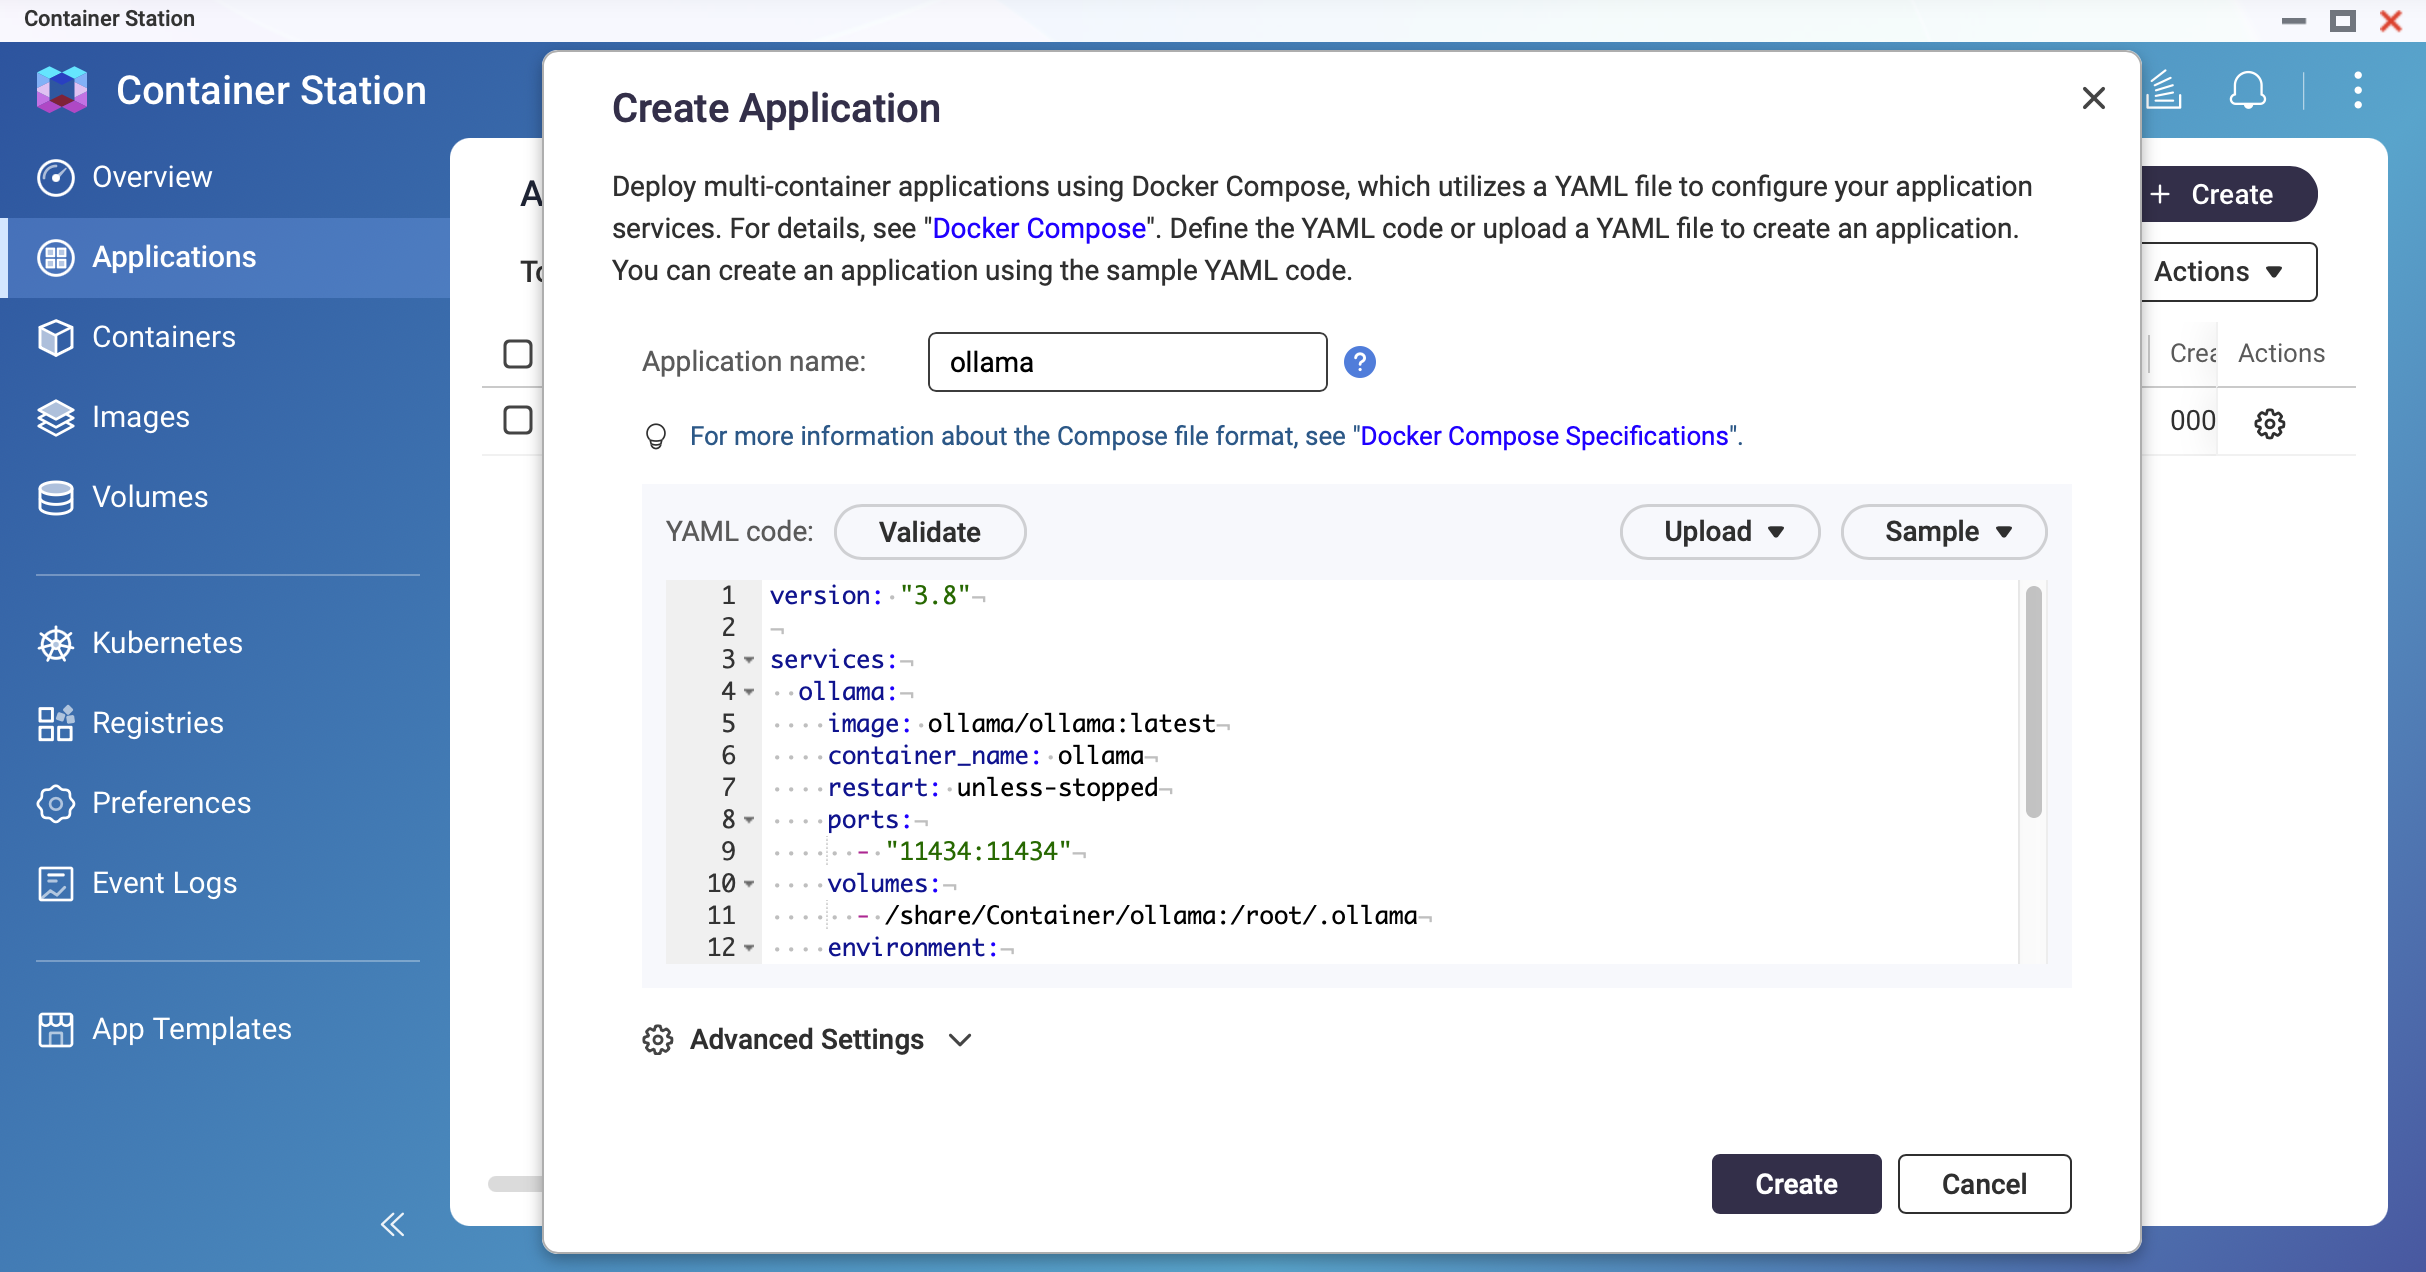 Snímek obrazovky: Container Station — obrazovka pro vytvoření aplikace s editorem YAML
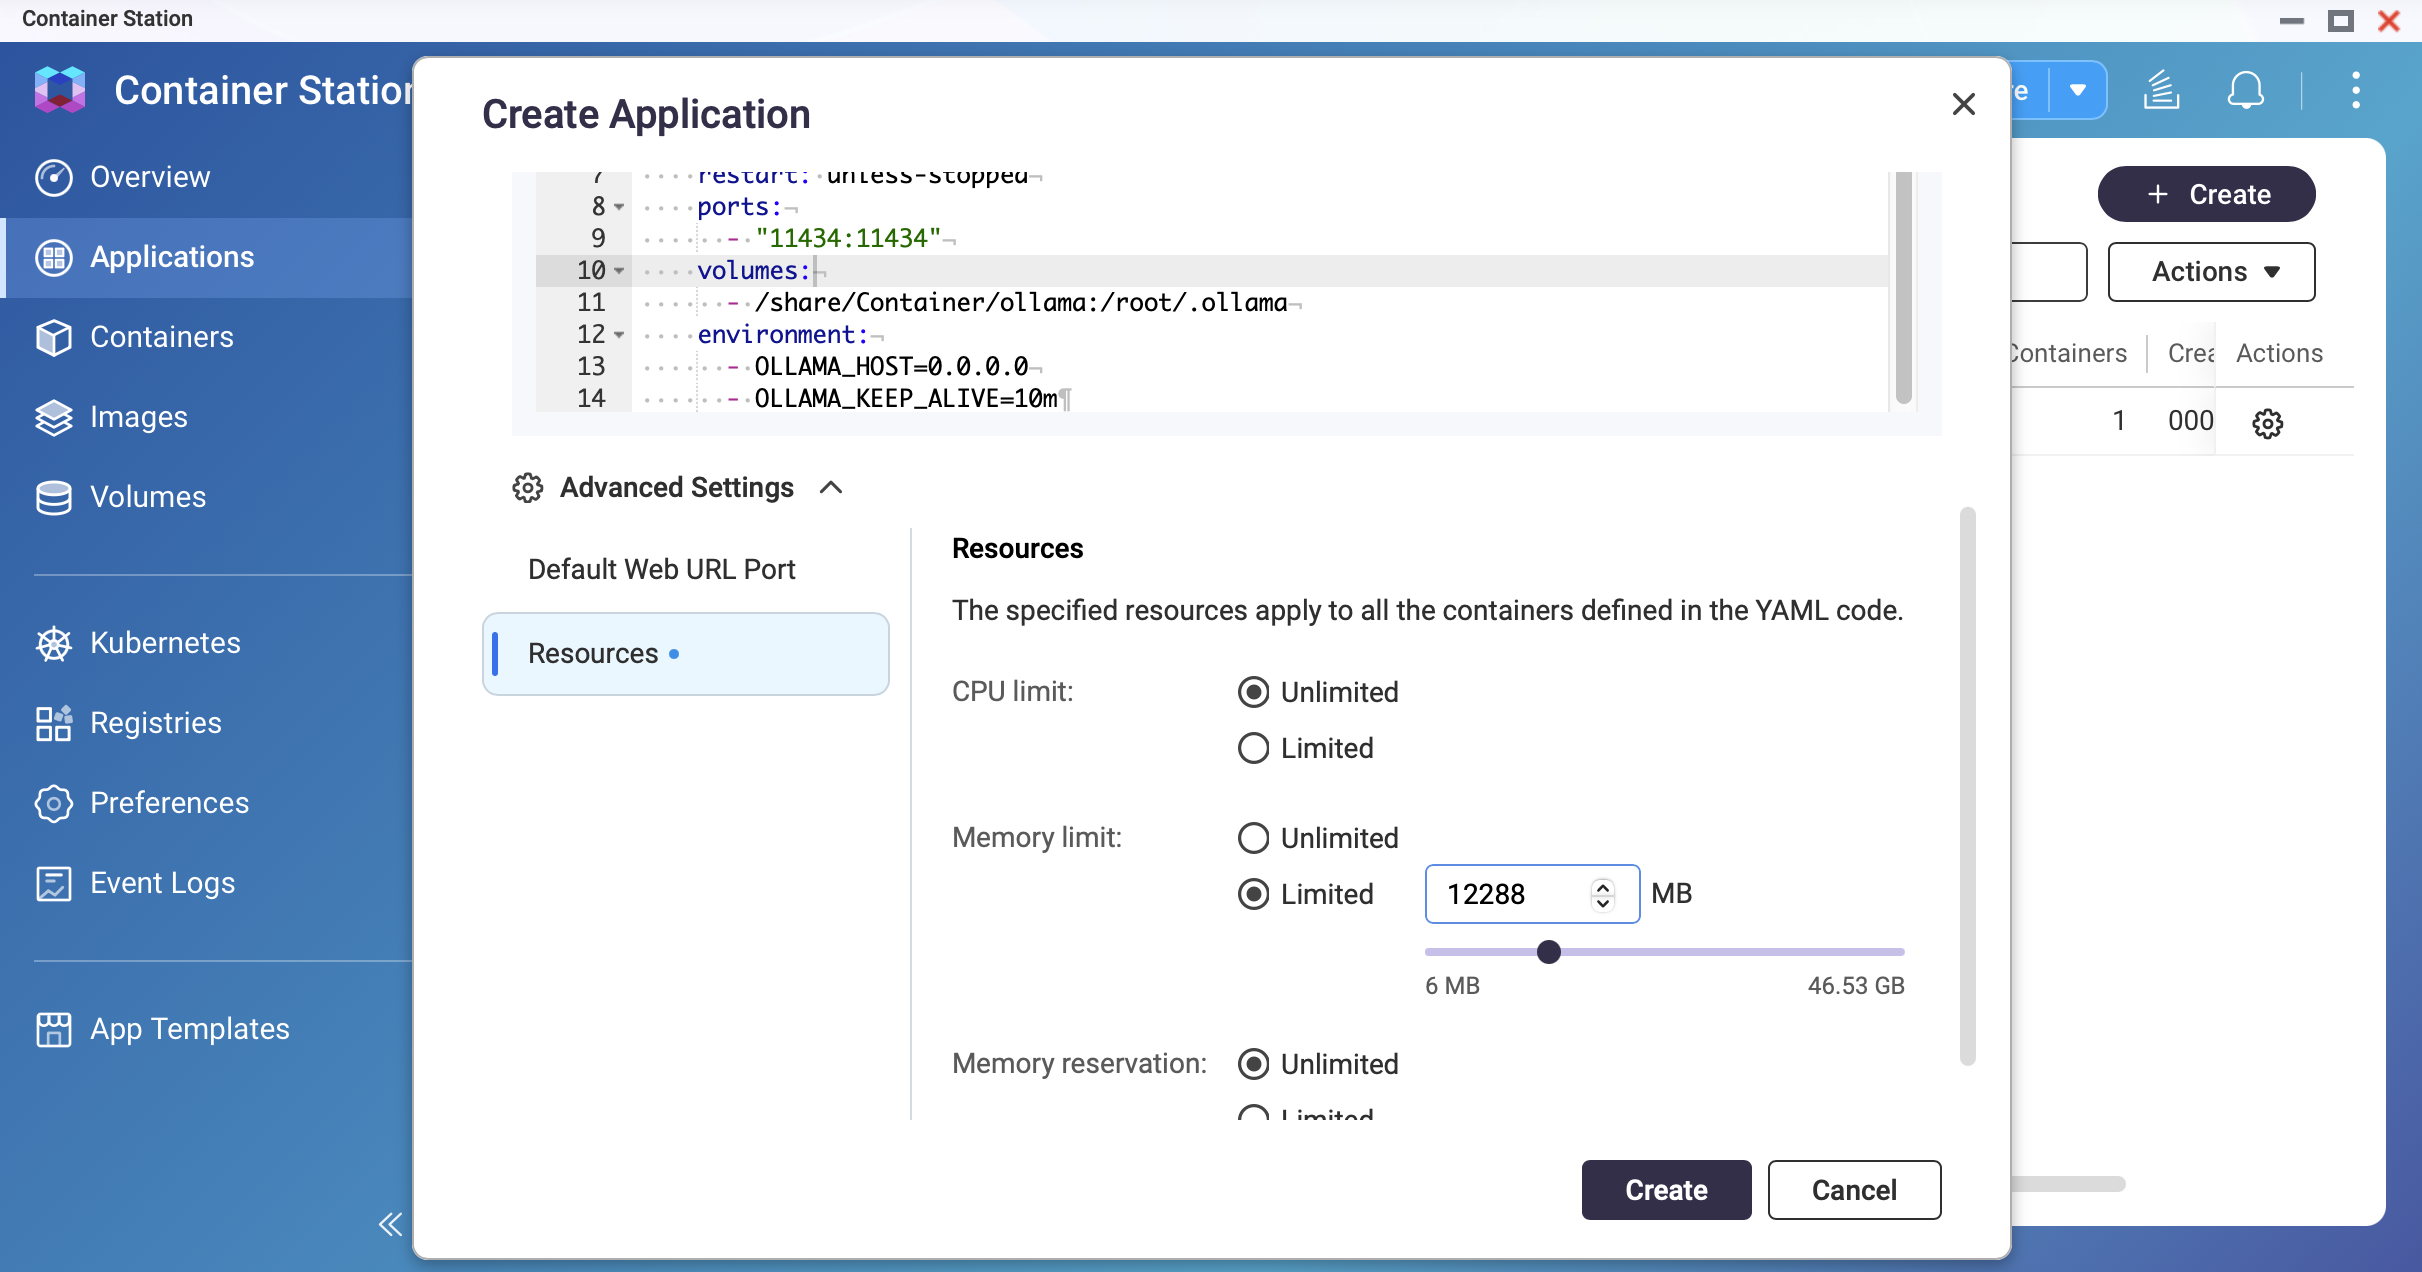 Snímek obrazovky: Container Station — Nastavení limitu paměti
Nasaďte kontejner.
Klikněte na Vytvořit. Container Station stáhne obraz Ollama a spustí kontejner. Počkejte, dokud se stav nezobrazí jako Běží.
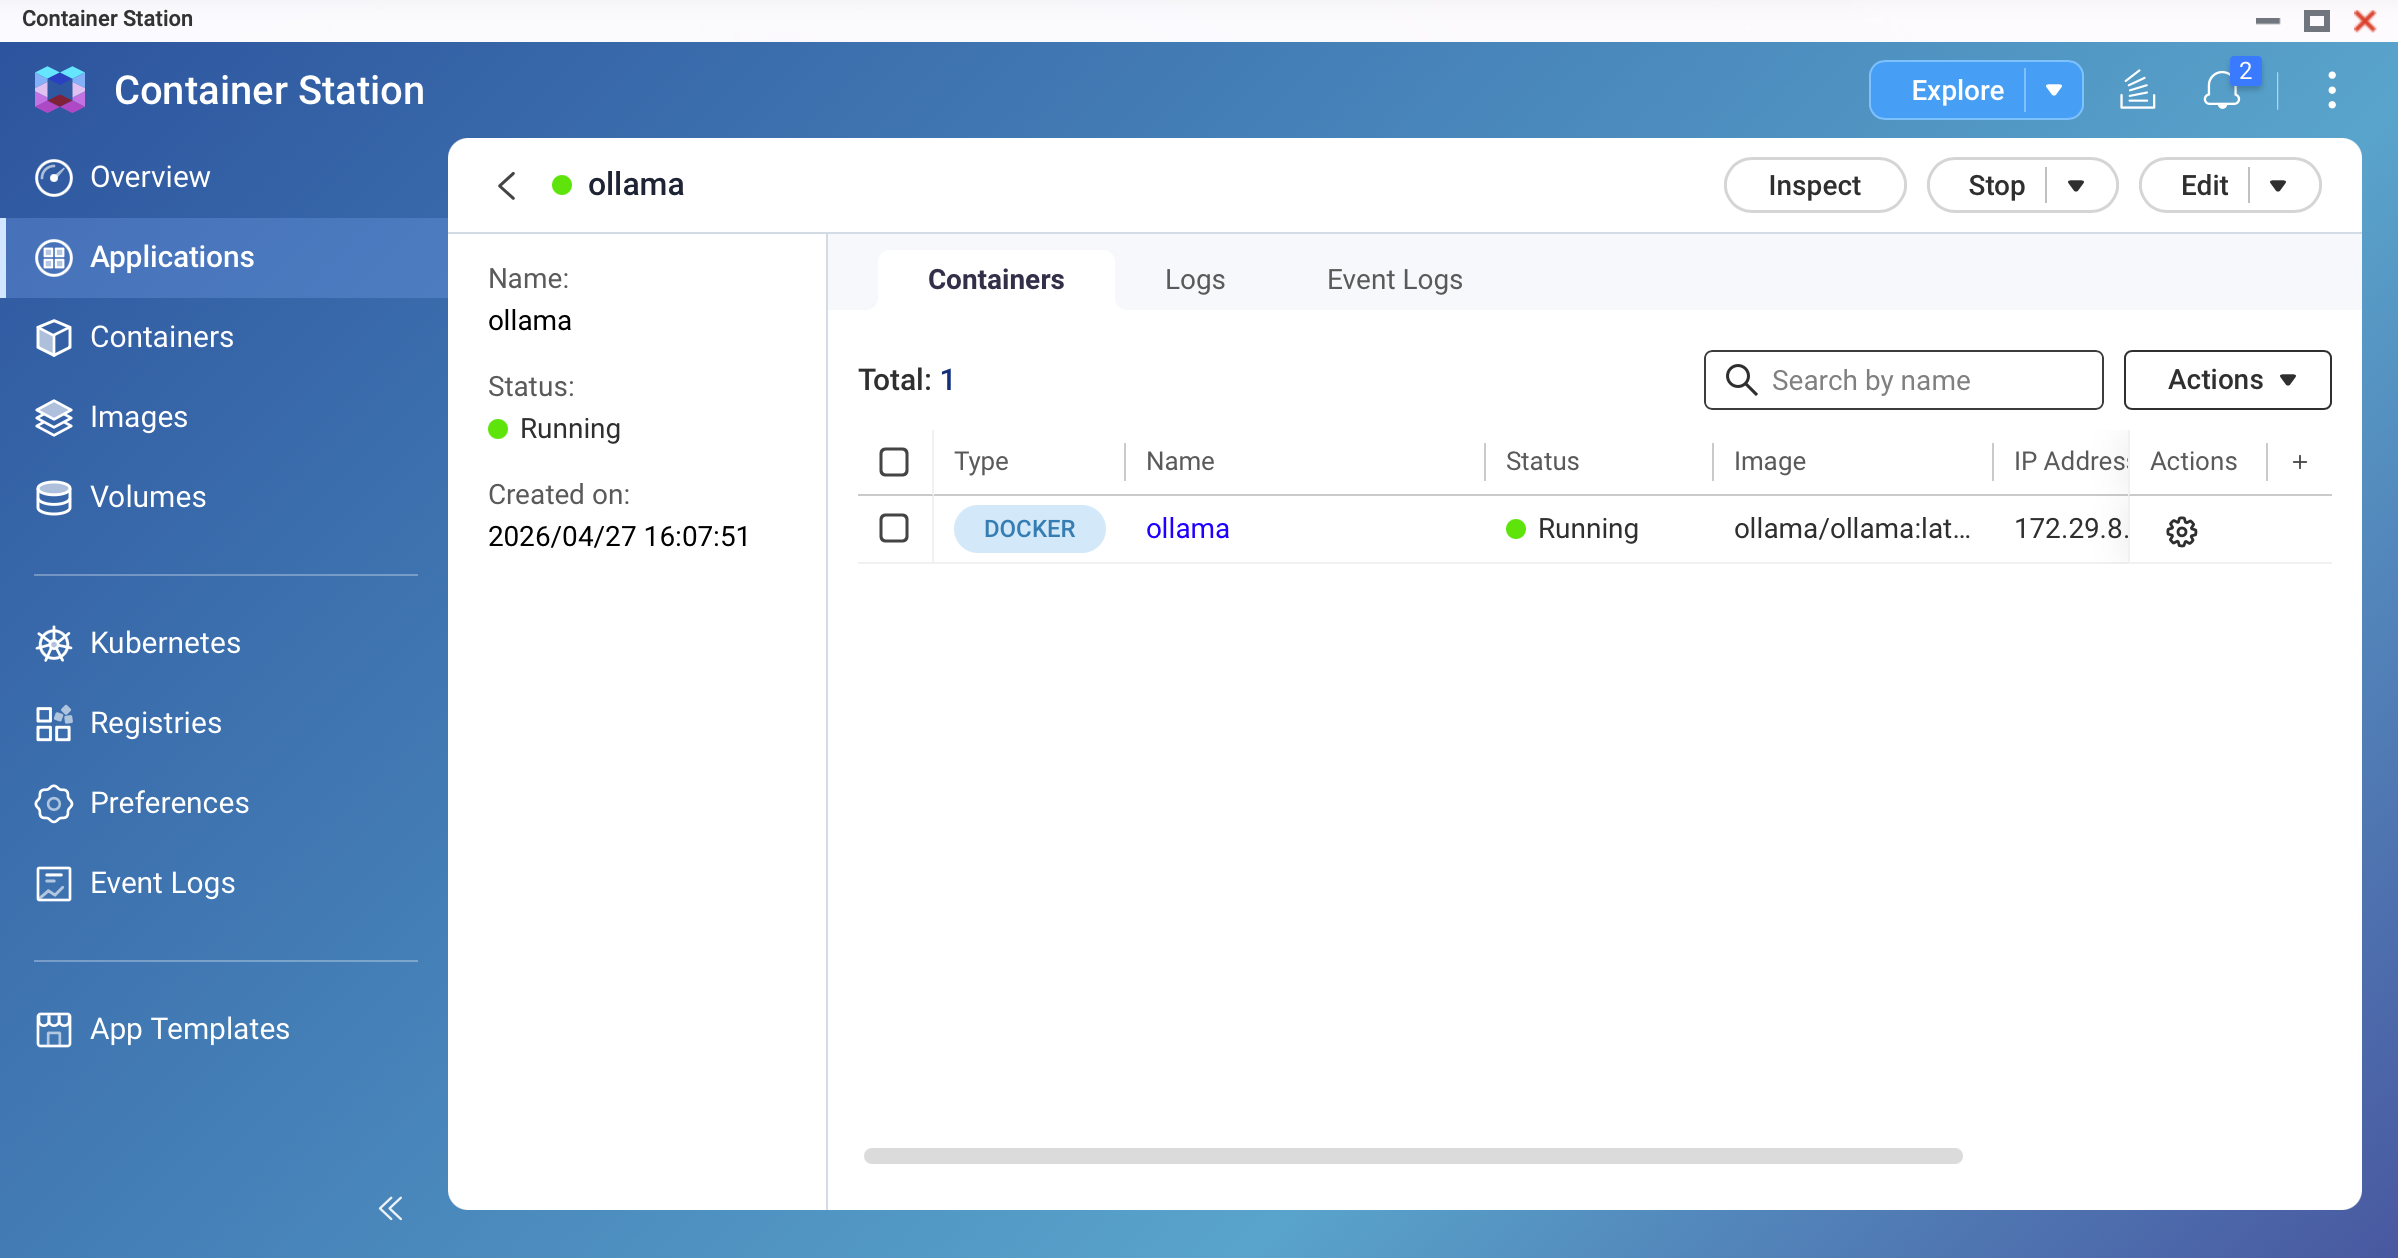 Snímek obrazovky: Container Station — kontejner ollama ukazuje stav "Běží"
Stáhněte si svůj první model.
Otevřete Terminál kontejneru (nebo se připojte přes SSH k vašemu NAS a spusťte Docker) a zadejte:
# Pro lehký model 3B (doporučeno pro první test): ollama pull llama3.2:3b # Pro standardní model 9B (vyžaduje 16 GB+ RAM): ollama pull qwen3.5:9bStahování může trvat několik minut v závislosti na rychlosti vašeho internetu. Model 9B Q4_K_M má přibližně 4–7 GB.
Poznámka- Ověřte, že máte dostatek místa na disku před stažením. Použijte
ollama listk ověření existujících modelů a jejich velikostí. - Pro modely NAS založené na ARM doporučujeme začít s modelem <1B pro sledování využití paměti.
- Ověřte, že máte dostatek místa na disku před stažením. Použijte
Otestujte model.
V terminálu kontejneru spusťte:
ollama run qwen3.5:9bZadejte výzvu a potvrďte, že obdržíte odpověď. Zadejte
/byepro ukončení.
Metoda 2: Nasazení s akcelerací pomocí NVIDIA GPU
Další předpoklady pro režim GPU:
- NVIDIA GPU nainstalována a detekována systémem QTS/QuTS hero
- GPU nastavena na režim Container Station v Ovládací panely
- Ovladač NVIDIA GPU a NvKernelDriver nainstalovány z App Center
Použijte konfiguraci Docker Compose s podporou GPU.
Nahraďte YAML z Metody 1 následujícím:
version: "3.8" services: ollama: image: ollama/ollama:latest container_name: ollama restart: unless-stopped ports: - "11434:11434" volumes: - /share/Container/ollama:/root/.ollama environment: - OLLAMA_HOST=0.0.0.0 - OLLAMA_KEEP_ALIVE=10m - NVIDIA_VISIBLE_DEVICES=all deploy: resources: reservations: devices: - driver: nvidia count: all capabilities: [gpu] networks: - ai-network networks: ai-network: name: ai-network driver: bridge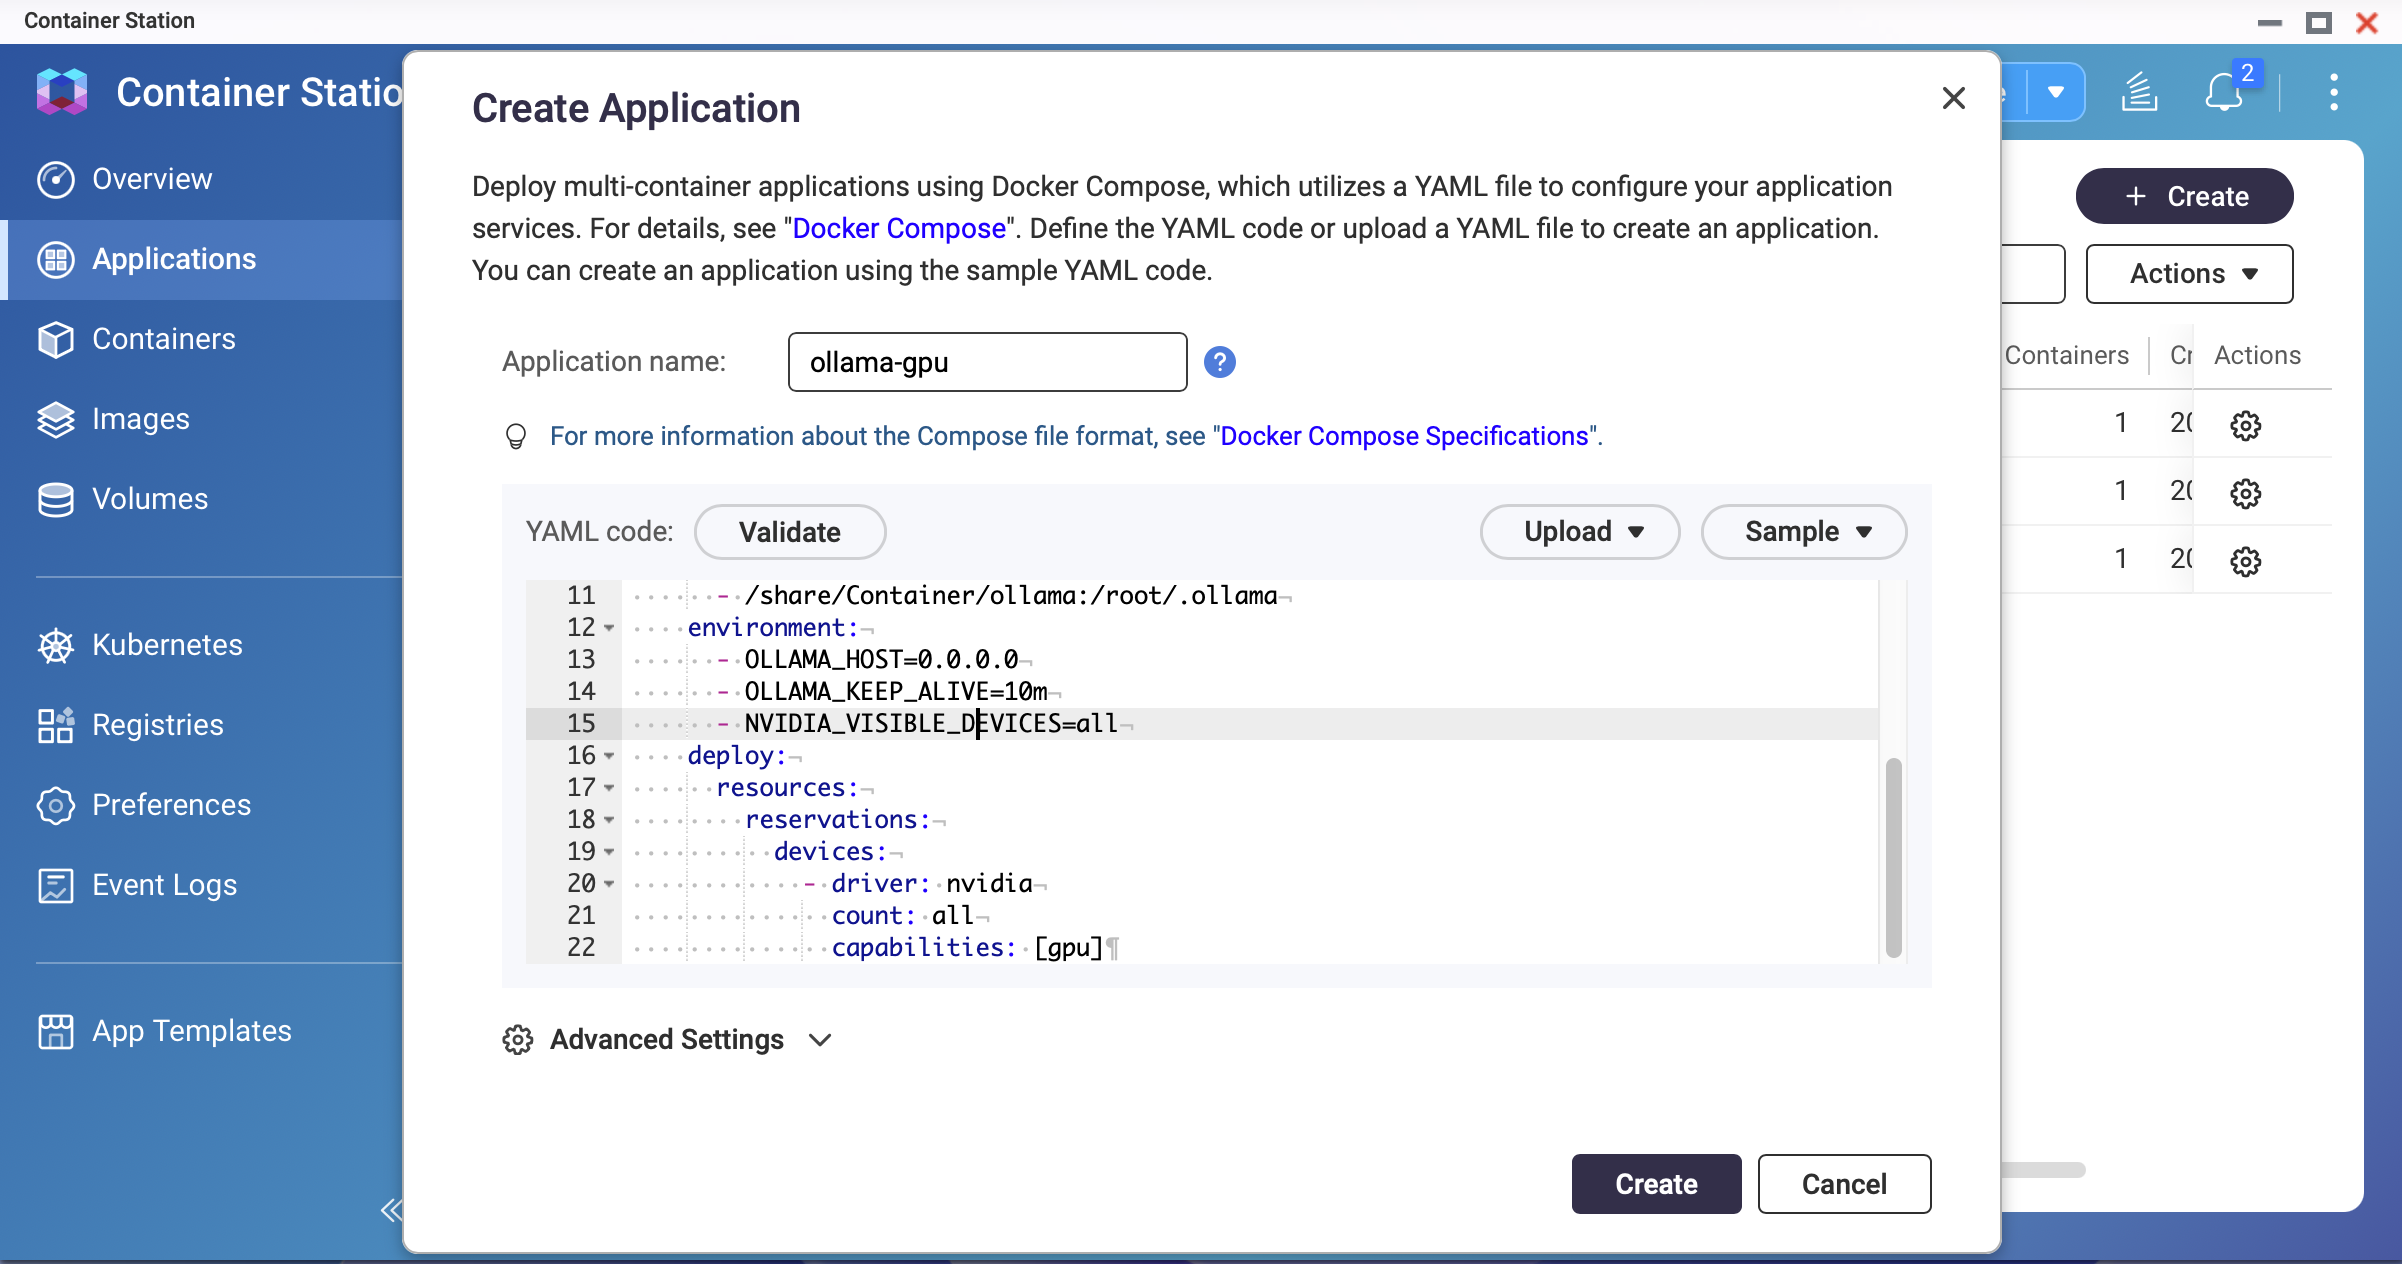 Snímek obrazovky: Container Station — YAML pro Docker Compose s podporou GPUPoznámkaOvladače NVIDIA dodávané s QNAP mohou být starší než nejnovější verze. Pokud se kontejner nespustí s povoleným GPU, zkontrolujte verzi ovladače pomocí
nvidia-smina hostiteli a ujistěte se, že je kompatibilní s verzí obrazu OllamaNasadit a ověřit přístup k GPU.
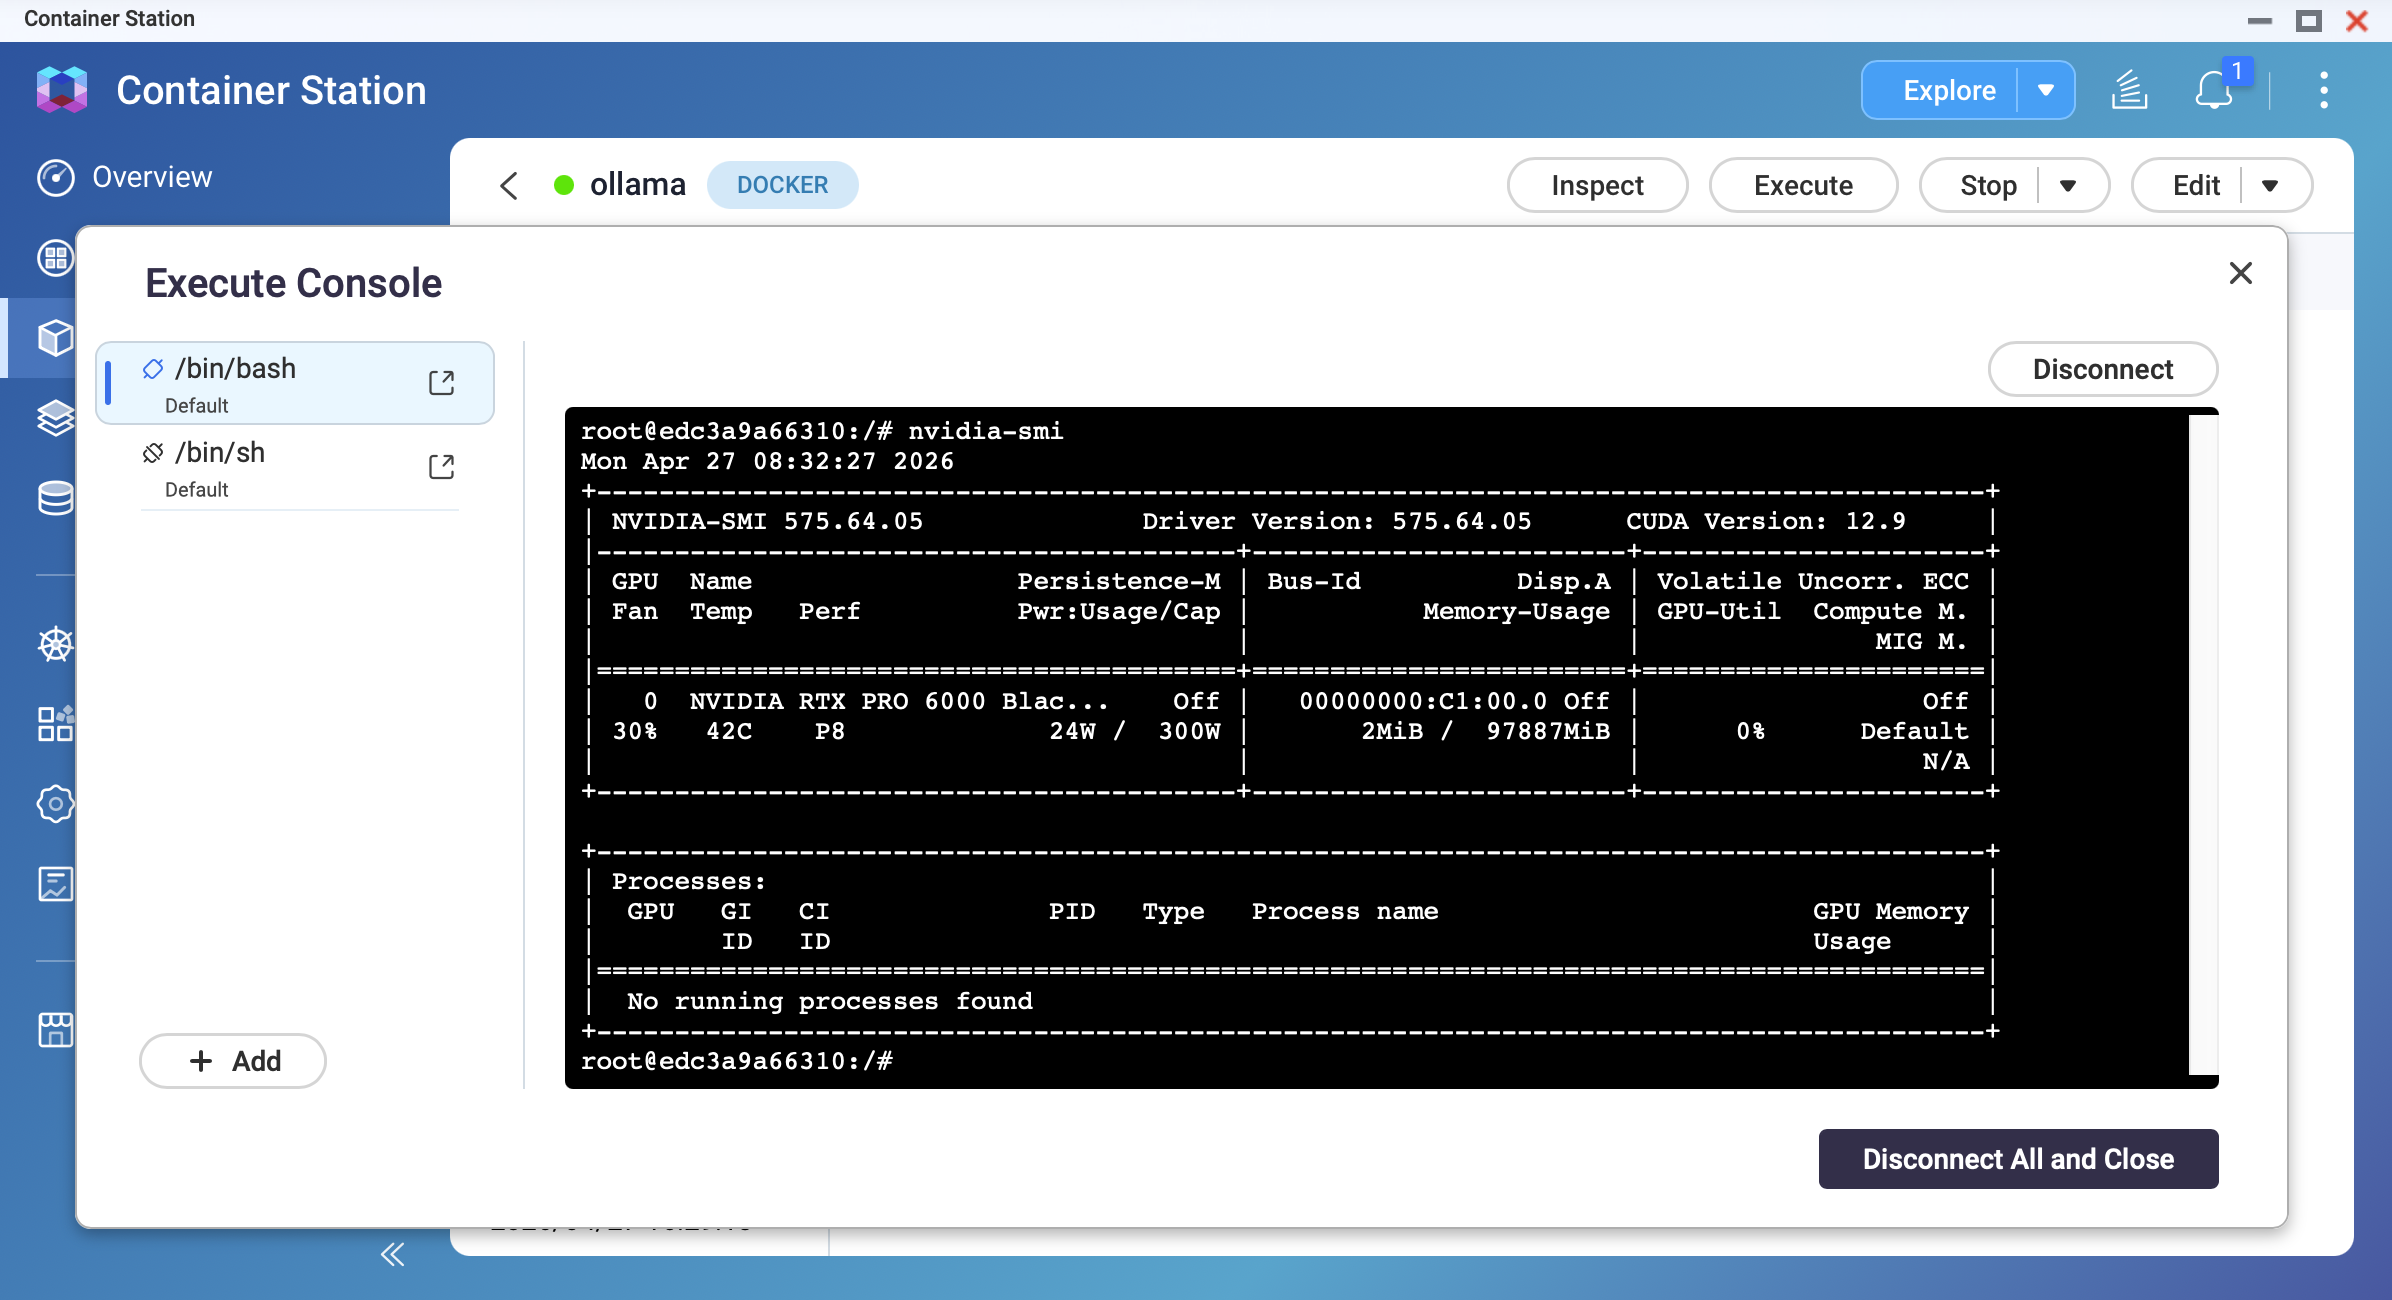
Po spuštění kontejneru otevřete jeho terminál a spusťte:
nvidia-smiMěli byste vidět model GPU, verzi ovladače a informace o paměti.
Stáhněte model a potvrďte akceleraci pomocí GPU.
ollama pull qwen3.5:9b ollama run qwen3.5:9bZatímco model generuje odpověď, otevřete další terminál a spusťte
nvidia-smi. Měli byste pozorovat zvýšení využití paměti GPU a využití GPU.
Výsledek
Po dokončení tohoto tutoriálu budete mít:
- Ollama běžící na vašem QNAP NAS na
http://<NAS-IP>:11434 - Data modelu uložená v
/share/Container/ollama(přežijí přestavby kontejneru) - Funkční LLM přístupné přes Ollama API
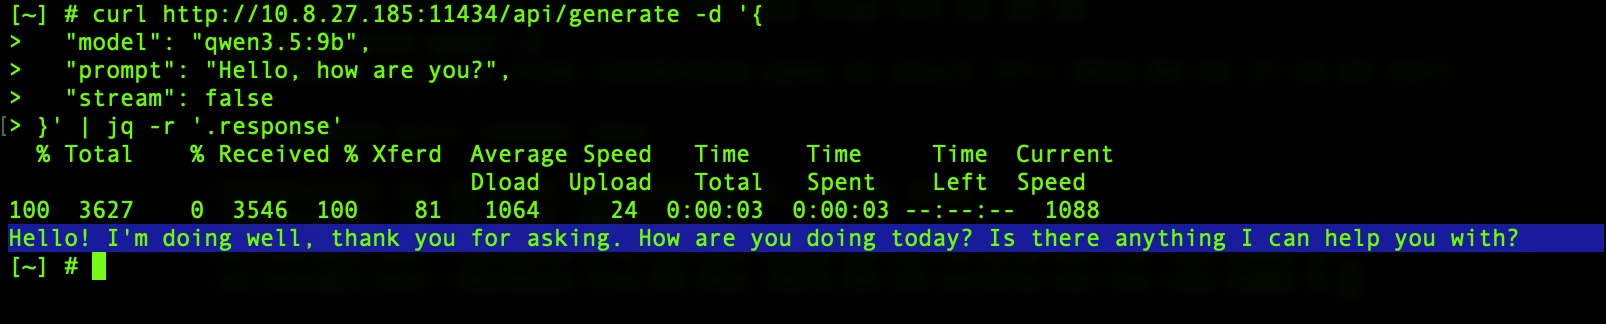
API můžete otestovat z jakéhokoli zařízení ve vaší místní síti:
curl http://<NAS-IP>:11434/api/generate -d '{
  "model": "qwen3.5:9b",
  "prompt": "Hello, how are you?",
  "stream": false
}'
OLLAMA_HOST=0.0.0.0 vystavuje Ollama API na všech síťových rozhraních. Neotevírejte port 11434 do internetu. Použijte pravidla Brána firewall nebo síťová nastavení QNAP k omezení přístupu pouze na vaši místní síť.Řešení problémů
Kontejner se ihned po spuštění ukončí
To může být způsobeno nedostatkem RAM nebo nesouladem ovladače GPU. Zkontrolujte protokoly kontejneru v Container Station. Snižte omezení paměti nebo deaktivujte režim GPU.
Stažení modelu selže v polovině
To může být způsobeno nedostatkem místa na disku nebo vypršením časového limitu sítě. Pokuste se uvolnit místo Úložiště. Znovu spusťte ollama pull; systém pokračuje tam, kde přestal.
Rychlost odezvy je velmi pomalá (1–3 tokeny za sekundu)
Model může běžet na CPU místo GPU, nebo je model příliš velký pro vaši RAM. Ověřte přístup k GPU pomocí nvidia-smi uvnitř kontejneru. Zkuste použít menší model.
NAS se během inference stává nereagujícím
Může se jednat o problém s nedostatkem paměti: model spotřebovává veškerou systémovou paměť. Doporučujeme restartovat NAS. Nastavte limit využití paměti v aplikaci. Nebo použijte menší model.
Zpráva "Nelze se připojit k Ollama" z Open WebUI
To může být způsobeno nesprávnou URL API nebo izolací sítě Docker. Můžete použít http://ollama:11434, pokud jste na stejné síti Docker.
Pro další pomoc se zeptejte ostatních uživatelů a odborníků QNAP v komunitě. Přejít do komunity QNAP


