


Hoe Ollama op de QNAP NAS te implementeren met behulp van Container Station
Toepasselijke Producten
QTS, QuTS hero
Container Station
Scenario
U wilt grote taalmodellen (LLM's) lokaal op uw QNAP NAS draaien voor privé AI-chat, code-assistentie of documentanalyse zonder gegevens naar de cloud te sturen. Ollama is de meest populaire en gebruiksvriendelijke inferentie-engine voor dit doel. Deze tutorial legt uit hoe u Ollama op de QNAP NAS kunt implementeren met behulp van Container Station.
Systeemvereisten
| Vereiste | Detail |
|---|---|
| QNAP App | Container Station 3.x of later |
| NAS Architectuur | x86_64 (Intel of AMD CPU) (Slechts enkele op ARM gebaseerde modellen worden ondersteund.) |
| Geheugen |
|
| Opslag Ruimte |
|
| GPU (Optioneel) | Compatibele NVIDIA GPU's (zie de Compatibiliteitsoverzicht) GPU moet worden ingesteld op Container Station Modus in de Configuratiescherm. |
Ollama zal standaard proberen het hele model in het geheugen te laden. Als uw NAS slechts 8–16 GB RAM heeft, kan het laden van een 14B of groter model het systeemgeheugen uitputten, waardoor NAS-diensten niet meer reageren of het systeem opnieuw opstart.
Gegevensverlies Risico
Als u geen persistent volume monteert voor
/root/.ollama, gaan alle gedownloade modellen en configuraties verloren wanneer de container wordt verwijderd of opnieuw wordt gemaakt. Volg altijd de instructies voor volumemontage in deze tutorial.- Controleer van tevoren de modelgrootte ten opzichte van uw beschikbare RAM.
- Stel geheugenlimieten in om het geheugengebruik van de container te beperken.
- Begin met kleine modellen (1B of 3B) en beoordeel de systeemstabiliteit voordat u grotere modellen probeert.
Procedure
Methode 1: Alleen CPU-implementatie (Geen GPU vereist)
Maak Opslag mappen aan.
Open File Station en maak de volgende map aan om Ollama-modelgegevens op te slaan:
/share/Container/ollama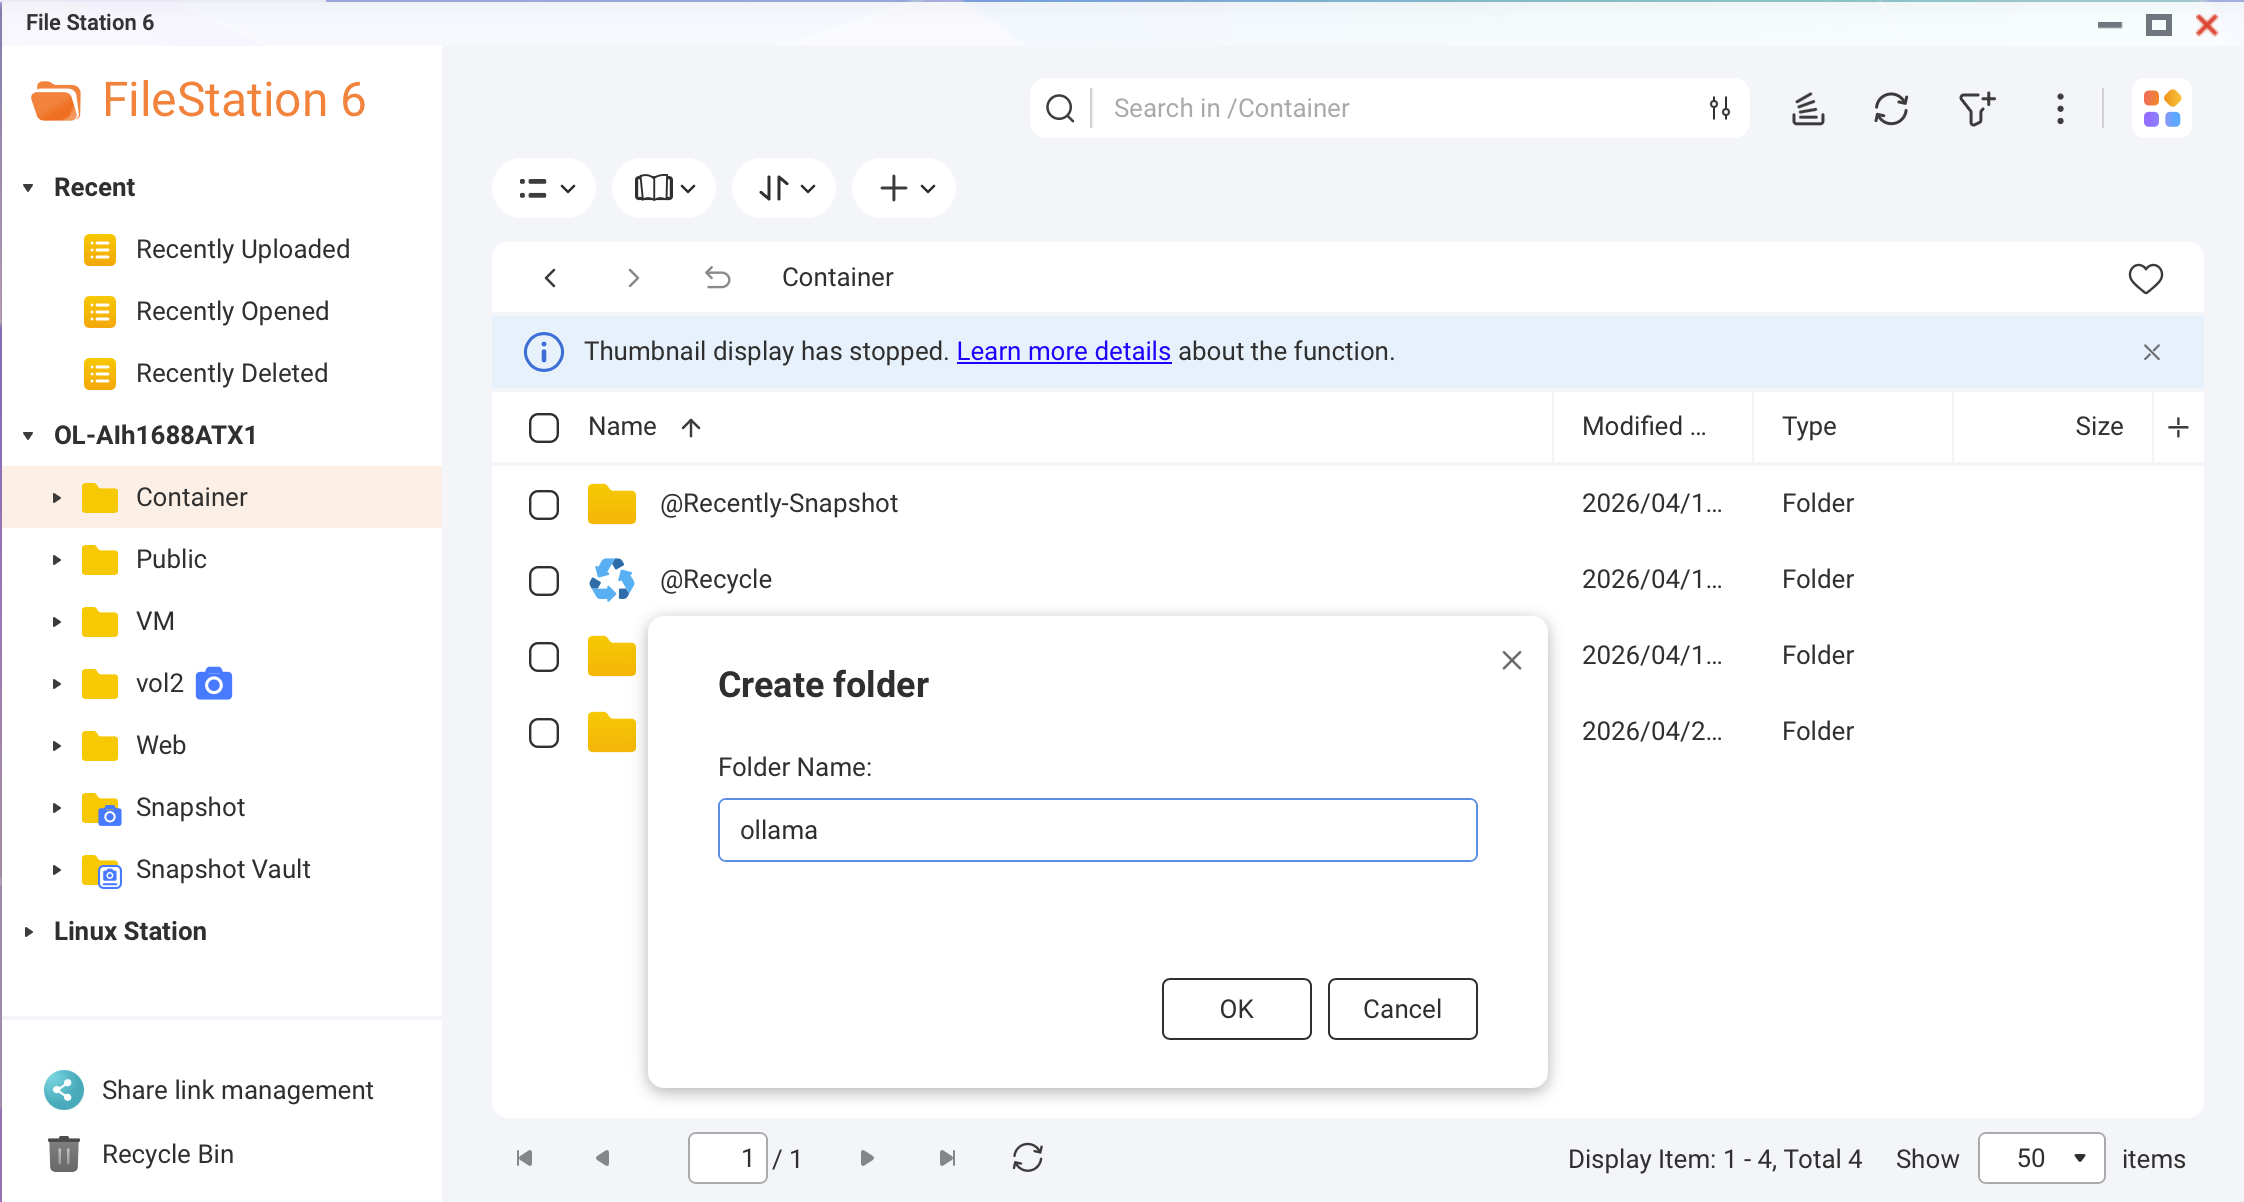 Schermafbeelding: File Station — het aanmaken van de Ollama-map onder /share/Container/Best PracticeAls uw NAS een NVMe SSD-cache of SSD-volume heeft, maak deze map dan op de SSD. De laadsnelheid van het model verbetert tot 10 keer in vergelijking met HDD's.
Maak een Docker Compose-bestand.
In Container Station, ga naar Applications > Create. Geef de applicatie een naam
ollamaen plak de volgende YAML:version: "3.8" services: ollama: image: ollama/ollama:latest container_name: ollama restart: unless-stopped ports: - "11434:11434" volumes: - /share/Container/ollama:/root/.ollama environment: - OLLAMA_HOST=0.0.0.0 - OLLAMA_KEEP_ALIVE=10m networks: - ai-network networks: ai-network: name: ai-network driver: bridge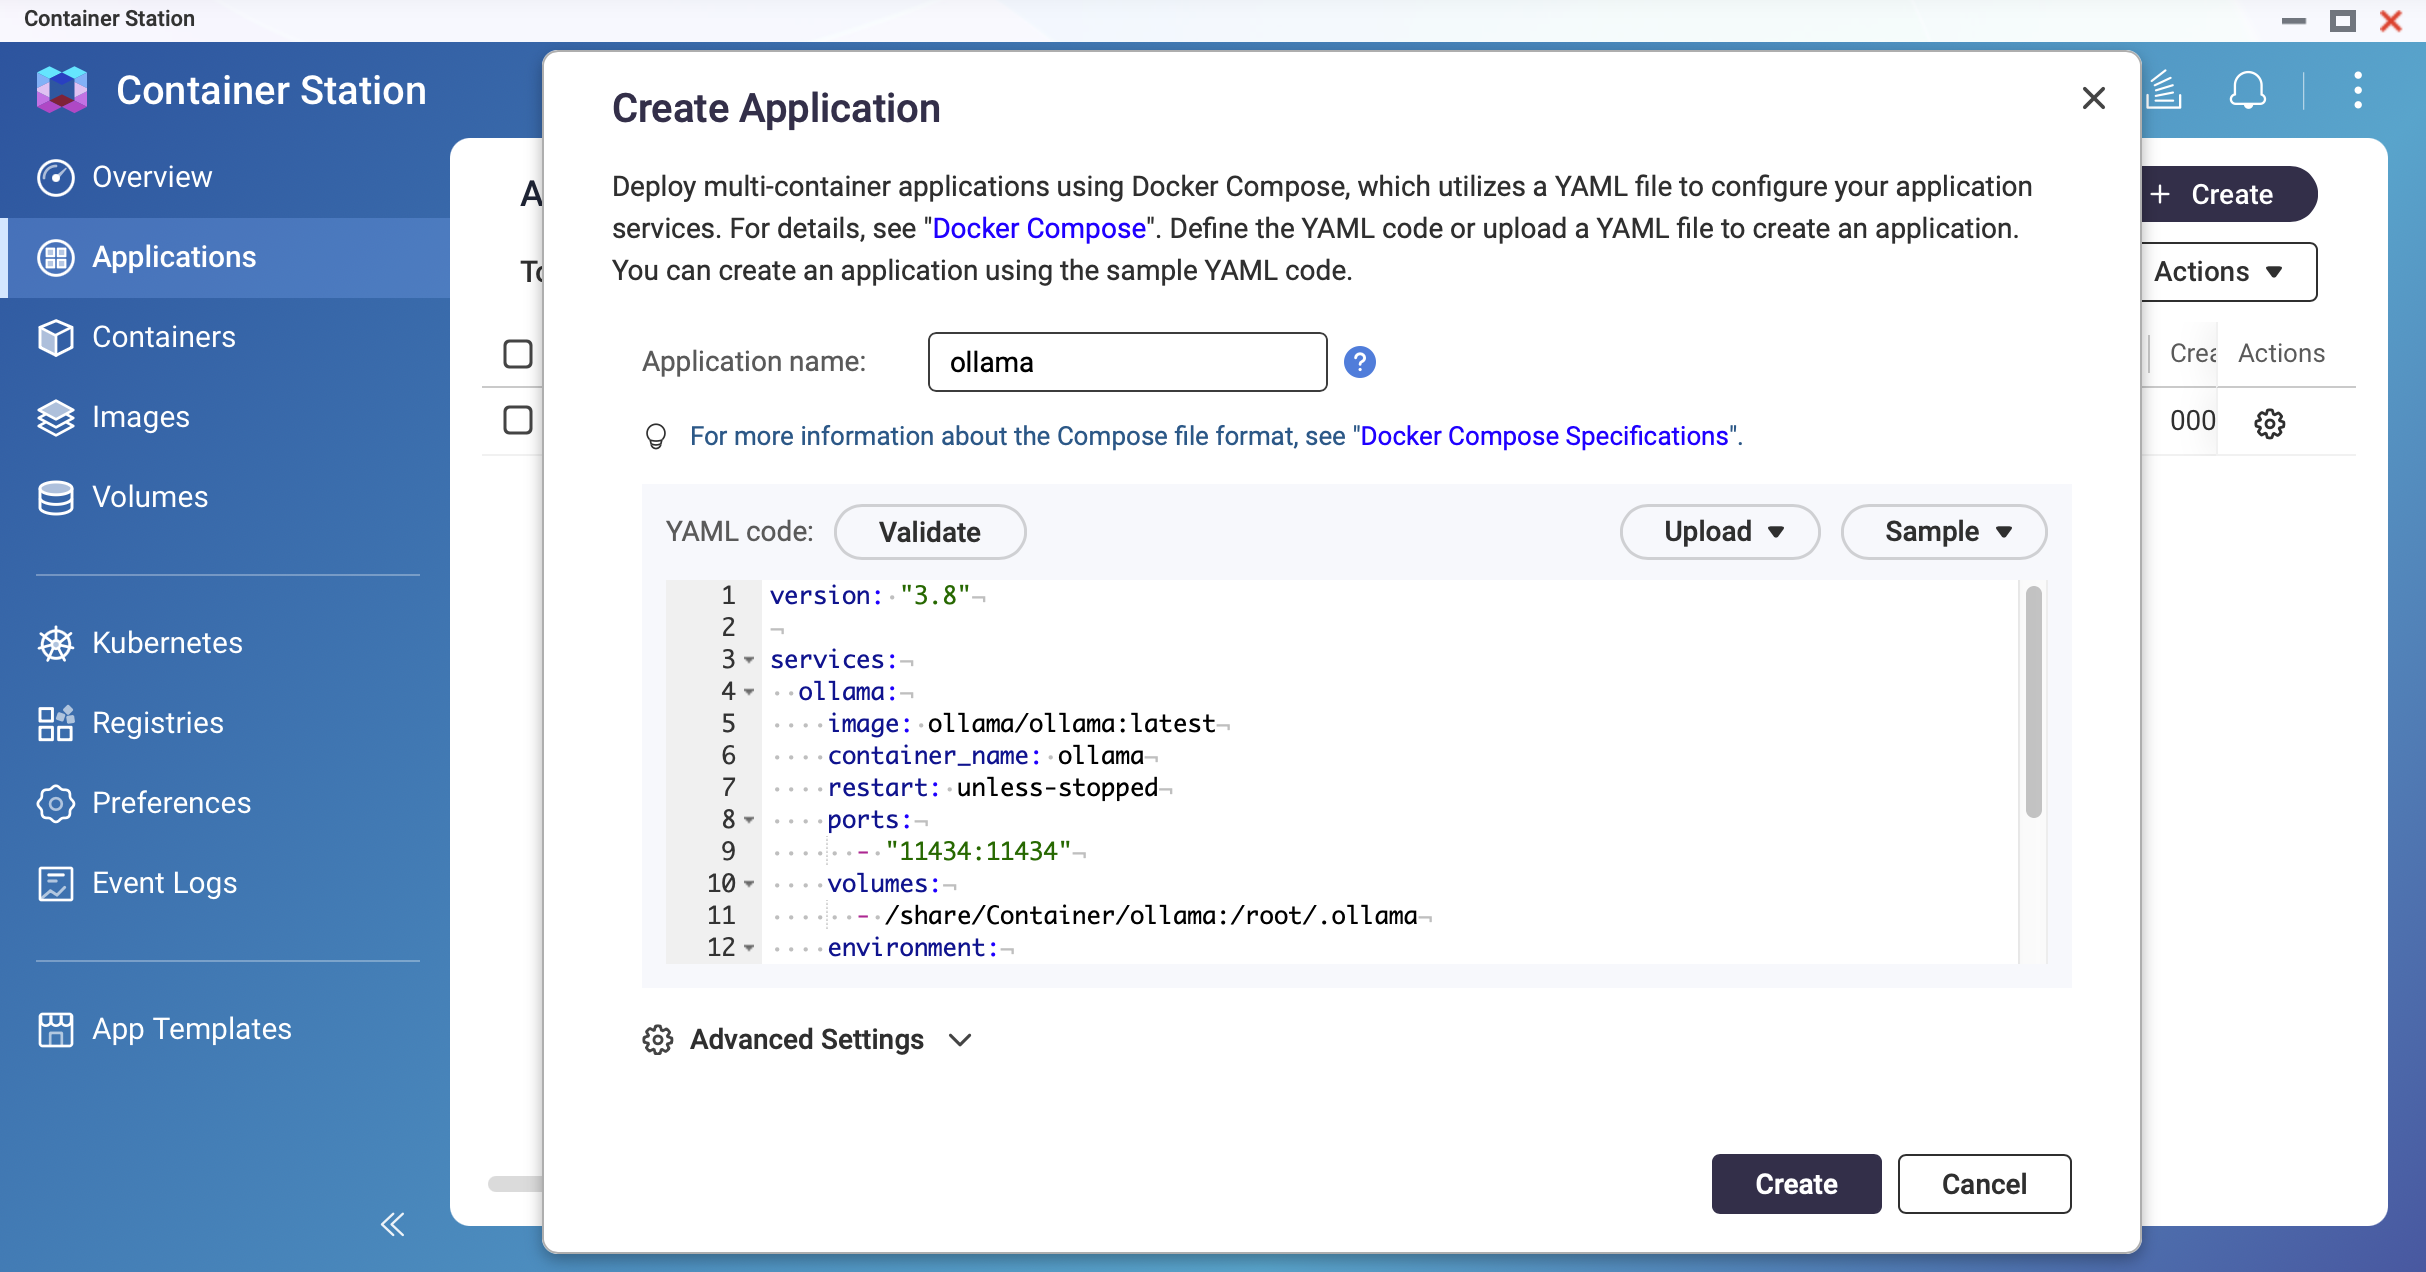 Schermafbeelding: Container Station — Applicatie-aanmaakscherm met YAML-editor
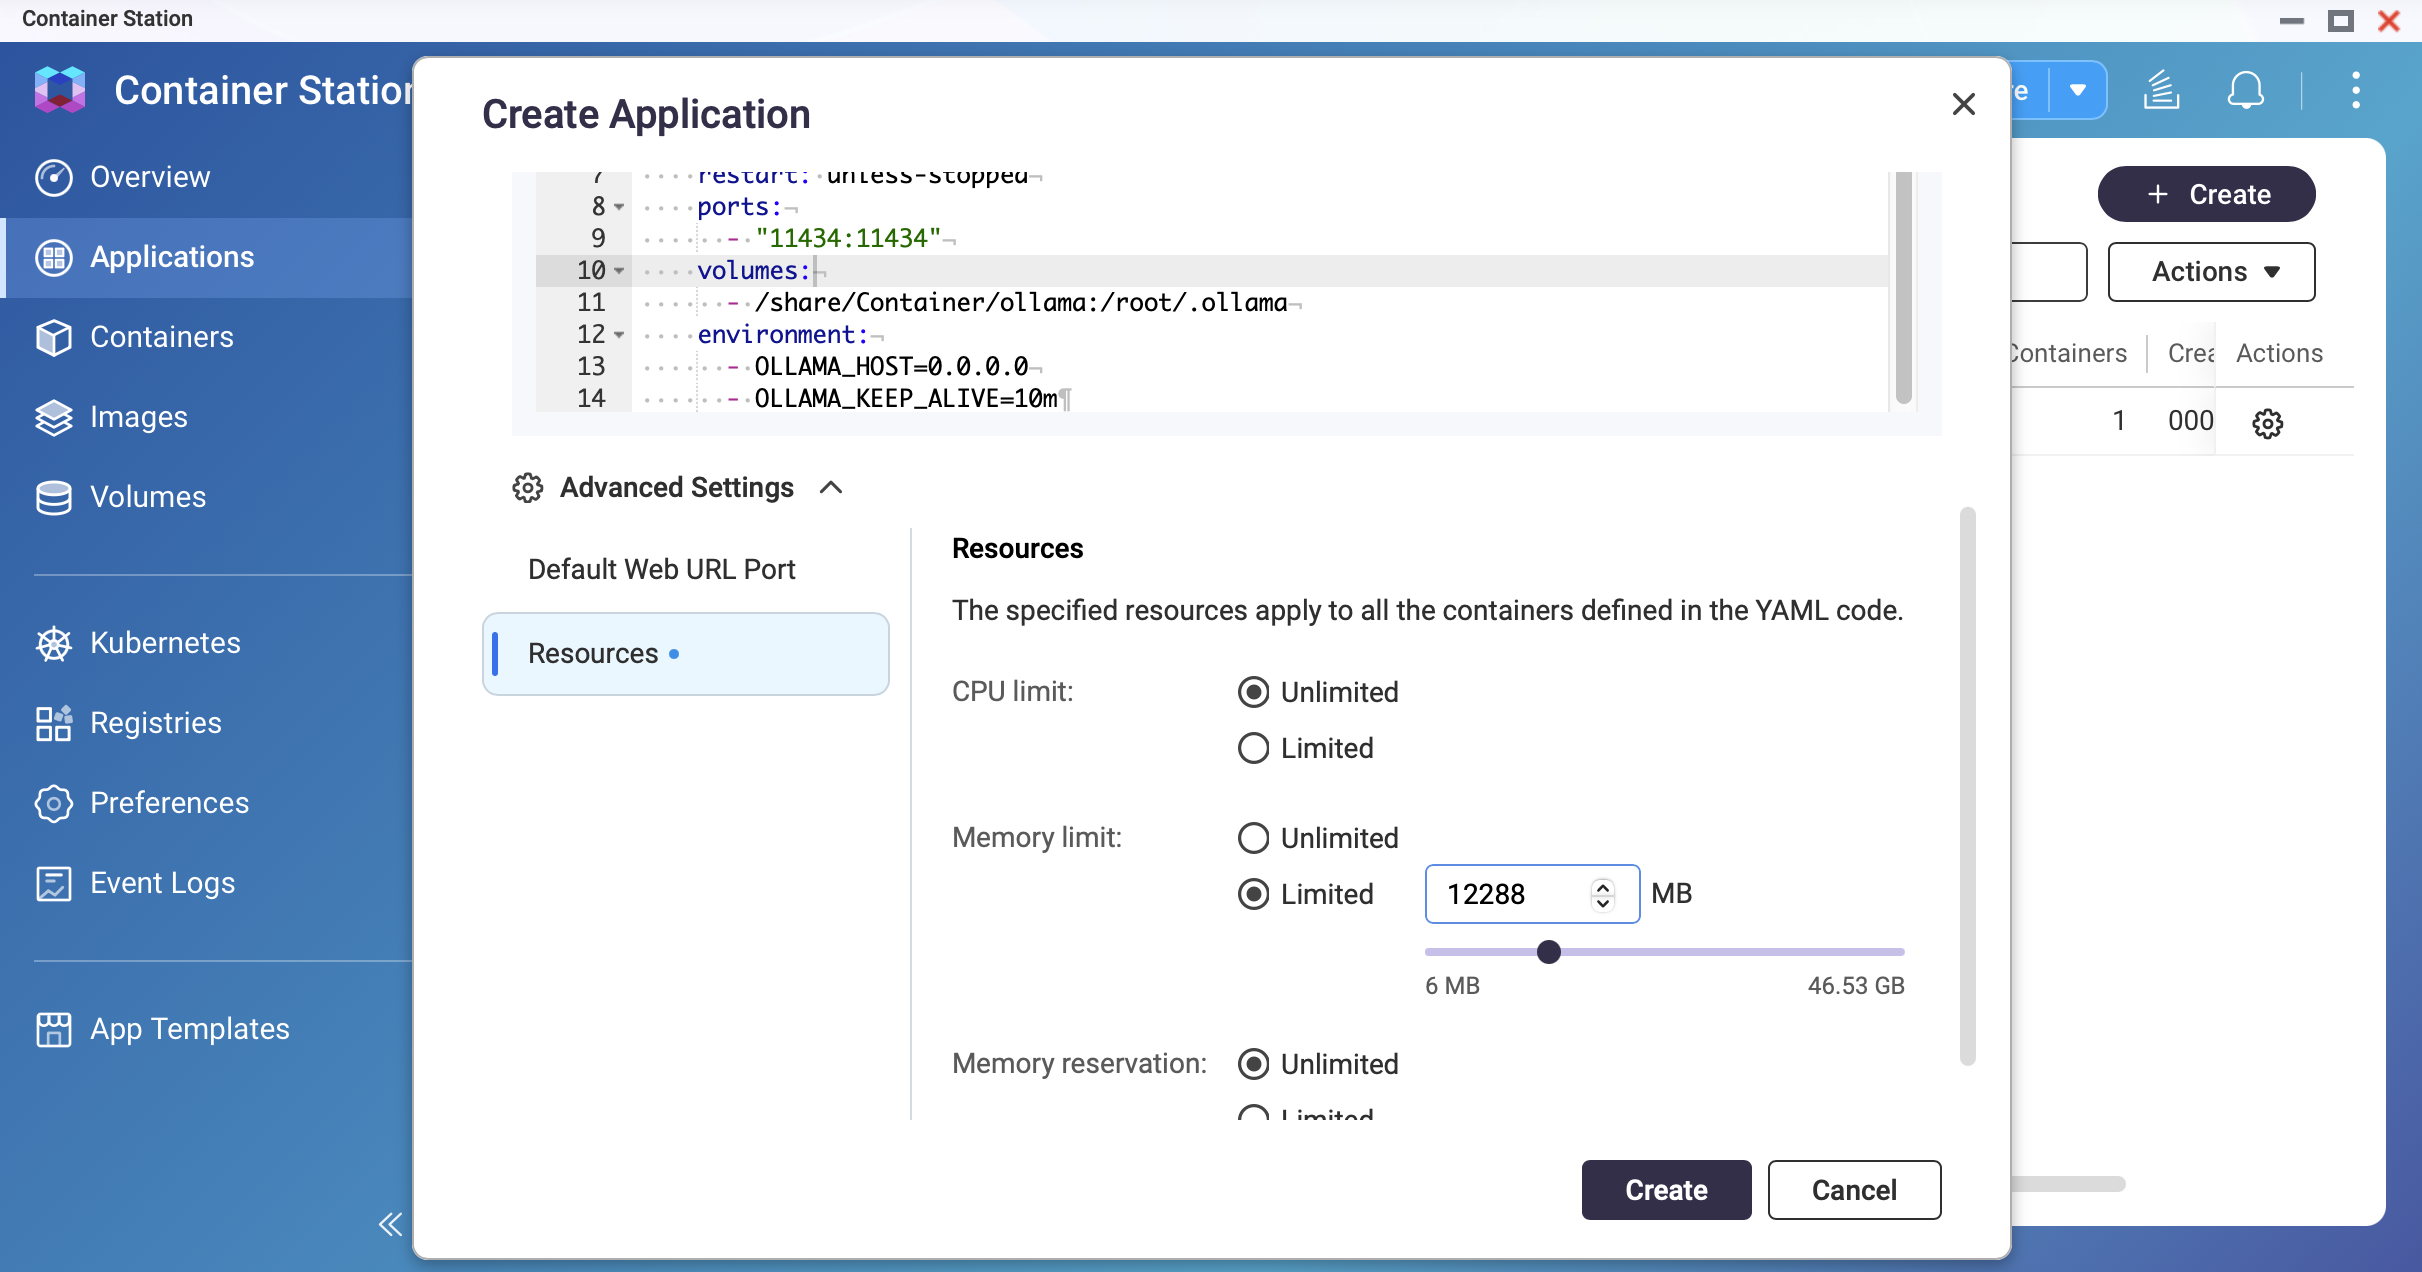 Schermafbeelding: Container Station — Stel de geheugenlimiet in
Implementeer de container.
Klik op Create. Container Station zal de Ollama-afbeelding ophalen en de container starten. Wacht tot de status Running aangeeft.
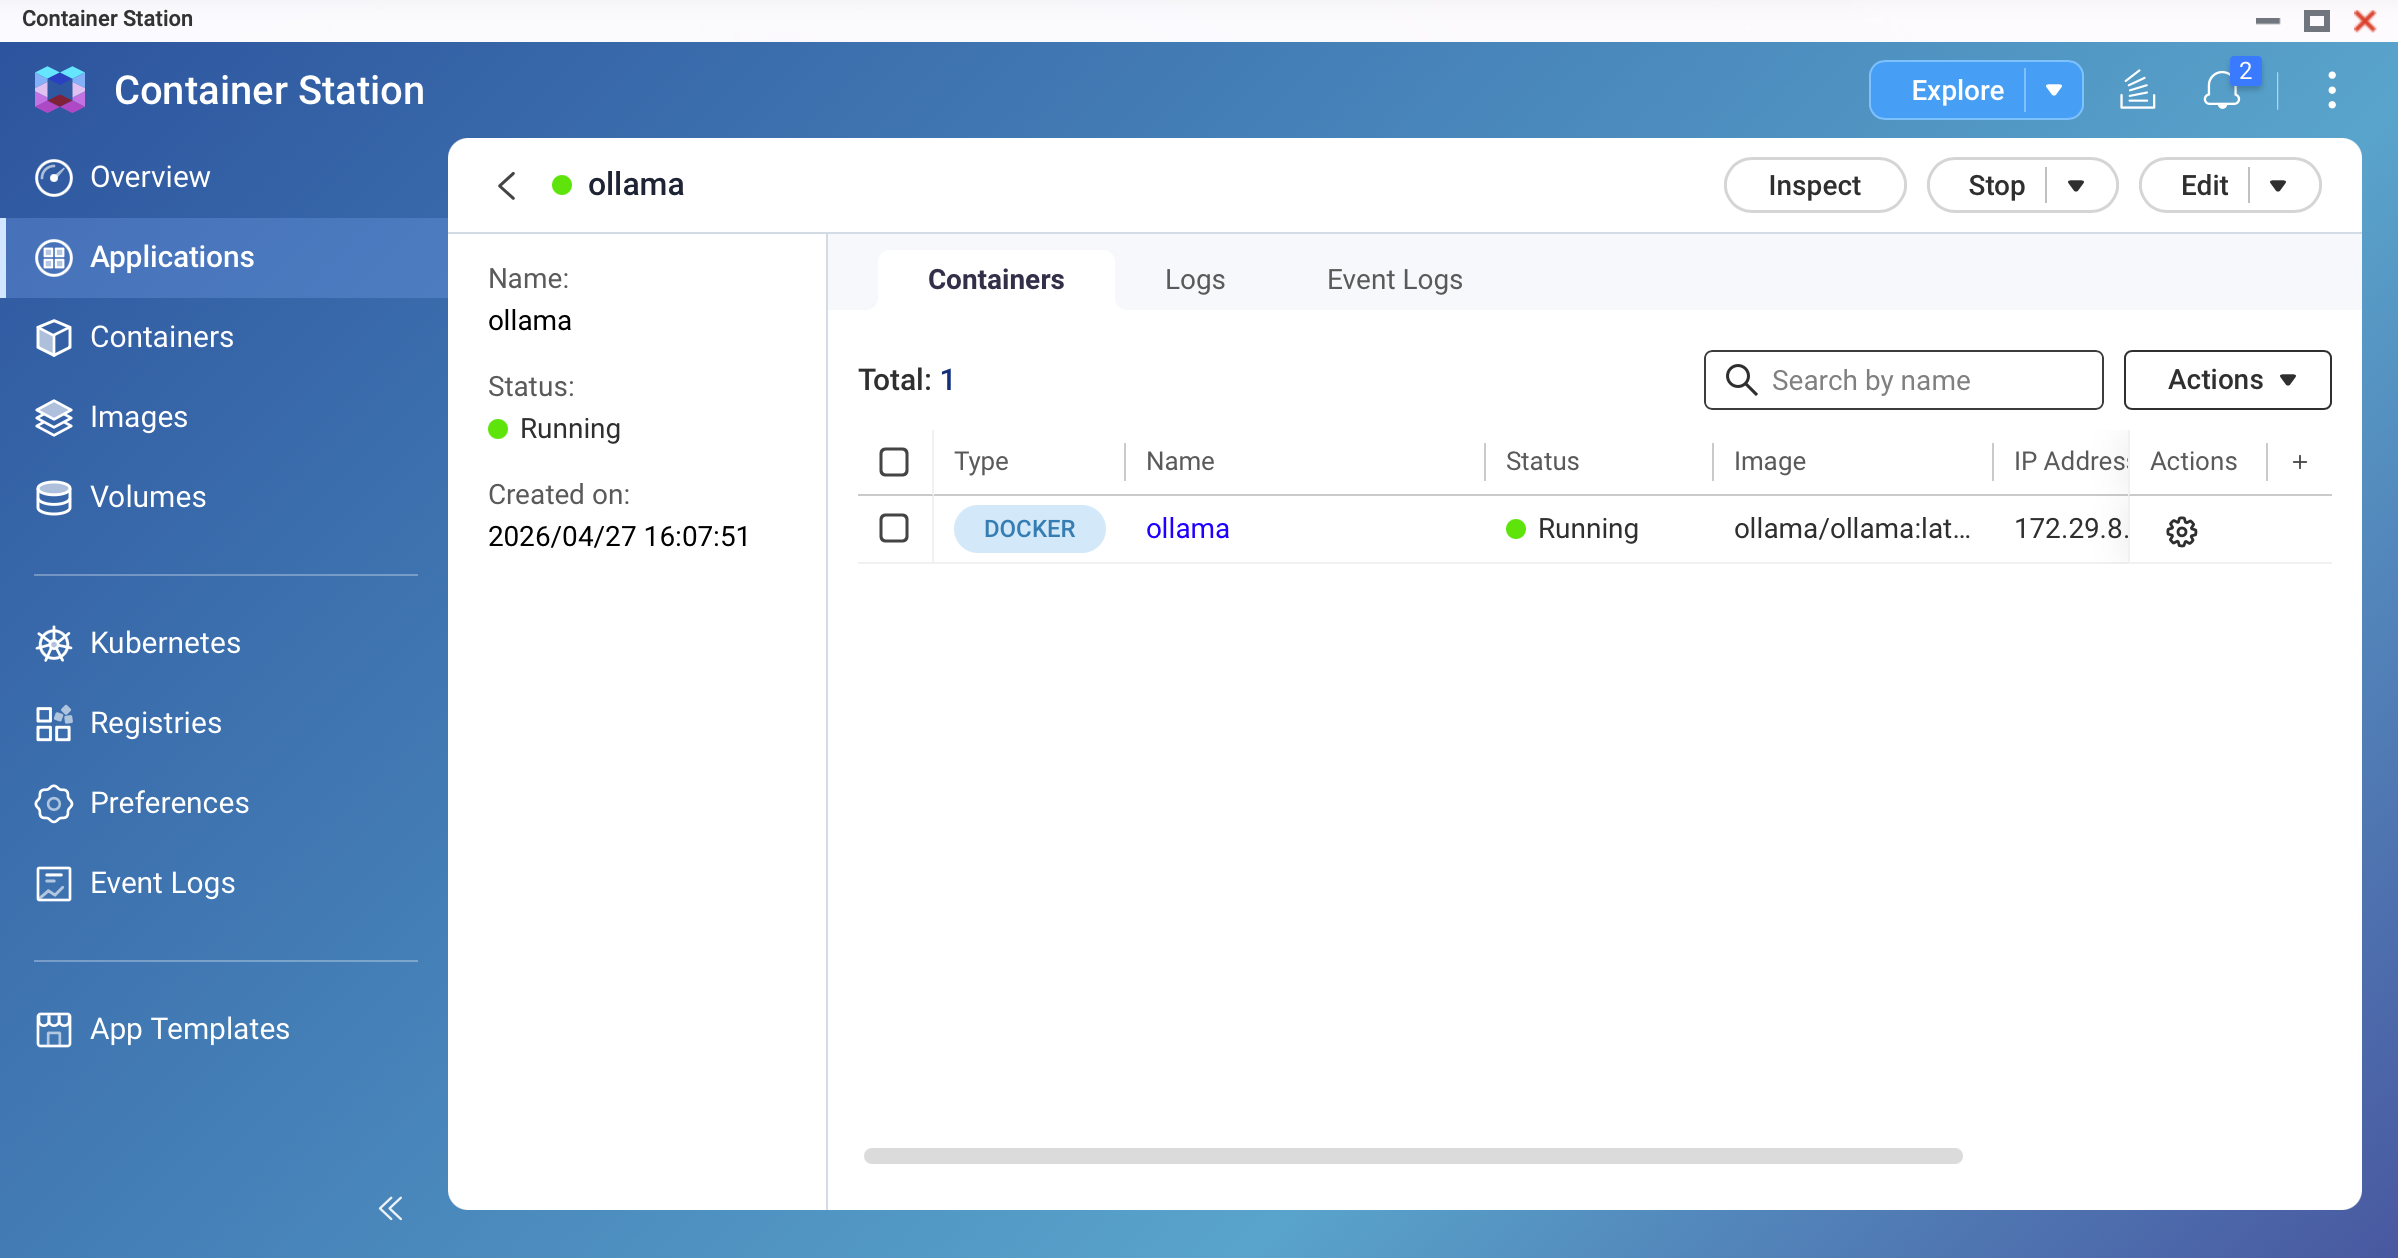 Schermafbeelding: Container Station — ollama-container toont "Running" status
Trek uw eerste model binnen.
Open de Terminal van de container (of SSH naar uw NAS en voer uw Docker uit) en voer uit:
# Voor een lichtgewicht 3B model (aanbevolen voor eerste test): ollama pull llama3.2:3b # Voor een standaard 9B model (vereist 16 GB+ RAM): ollama pull qwen3.5:9bHet downloaden kan enkele minuten duren, afhankelijk van uw internetsnelheid. Een 9B Q4_K_M model is ongeveer 4–7 GB.
Opmerking- Controleer of u voldoende schijfruimte heeft voordat u binnenhaalt. Gebruik
ollama listom bestaande modellen en hun groottes te controleren. - Voor ARM-gebaseerde NAS-modellen raden we aan te beginnen met het <1B model om het geheugengebruik te monitoren.
- Controleer of u voldoende schijfruimte heeft voordat u binnenhaalt. Gebruik
Test het model.
Voer in de containerterminal uit:
ollama run qwen3.5:9bTyp een prompt en bevestig dat u een reactie ontvangt. Typ
/byeom af te sluiten.
Methode 2: NVIDIA GPU-versnelde implementatie
Aanvullende vereisten voor GPU-modus:
- NVIDIA GPU geïnstalleerd en gedetecteerd door QTS/QuTS hero
- GPU ingesteld op Container Station Modus in de Configuratiescherm
- NVIDIA GPU Driver en NvKernelDriver geïnstalleerd van App Center
Gebruik de GPU-ingeschakelde Docker Compose-configuratie.
Vervang de YAML van Methode 1 door het volgende:
version: "3.8" services: ollama: image: ollama/ollama:latest container_name: ollama restart: unless-stopped ports: - "11434:11434" volumes: - /share/Container/ollama:/root/.ollama environment: - OLLAMA_HOST=0.0.0.0 - OLLAMA_KEEP_ALIVE=10m - NVIDIA_VISIBLE_DEVICES=all deploy: resources: reservations: devices: - driver: nvidia count: all capabilities: [gpu] networks: - ai-network networks: ai-network: name: ai-network driver: bridge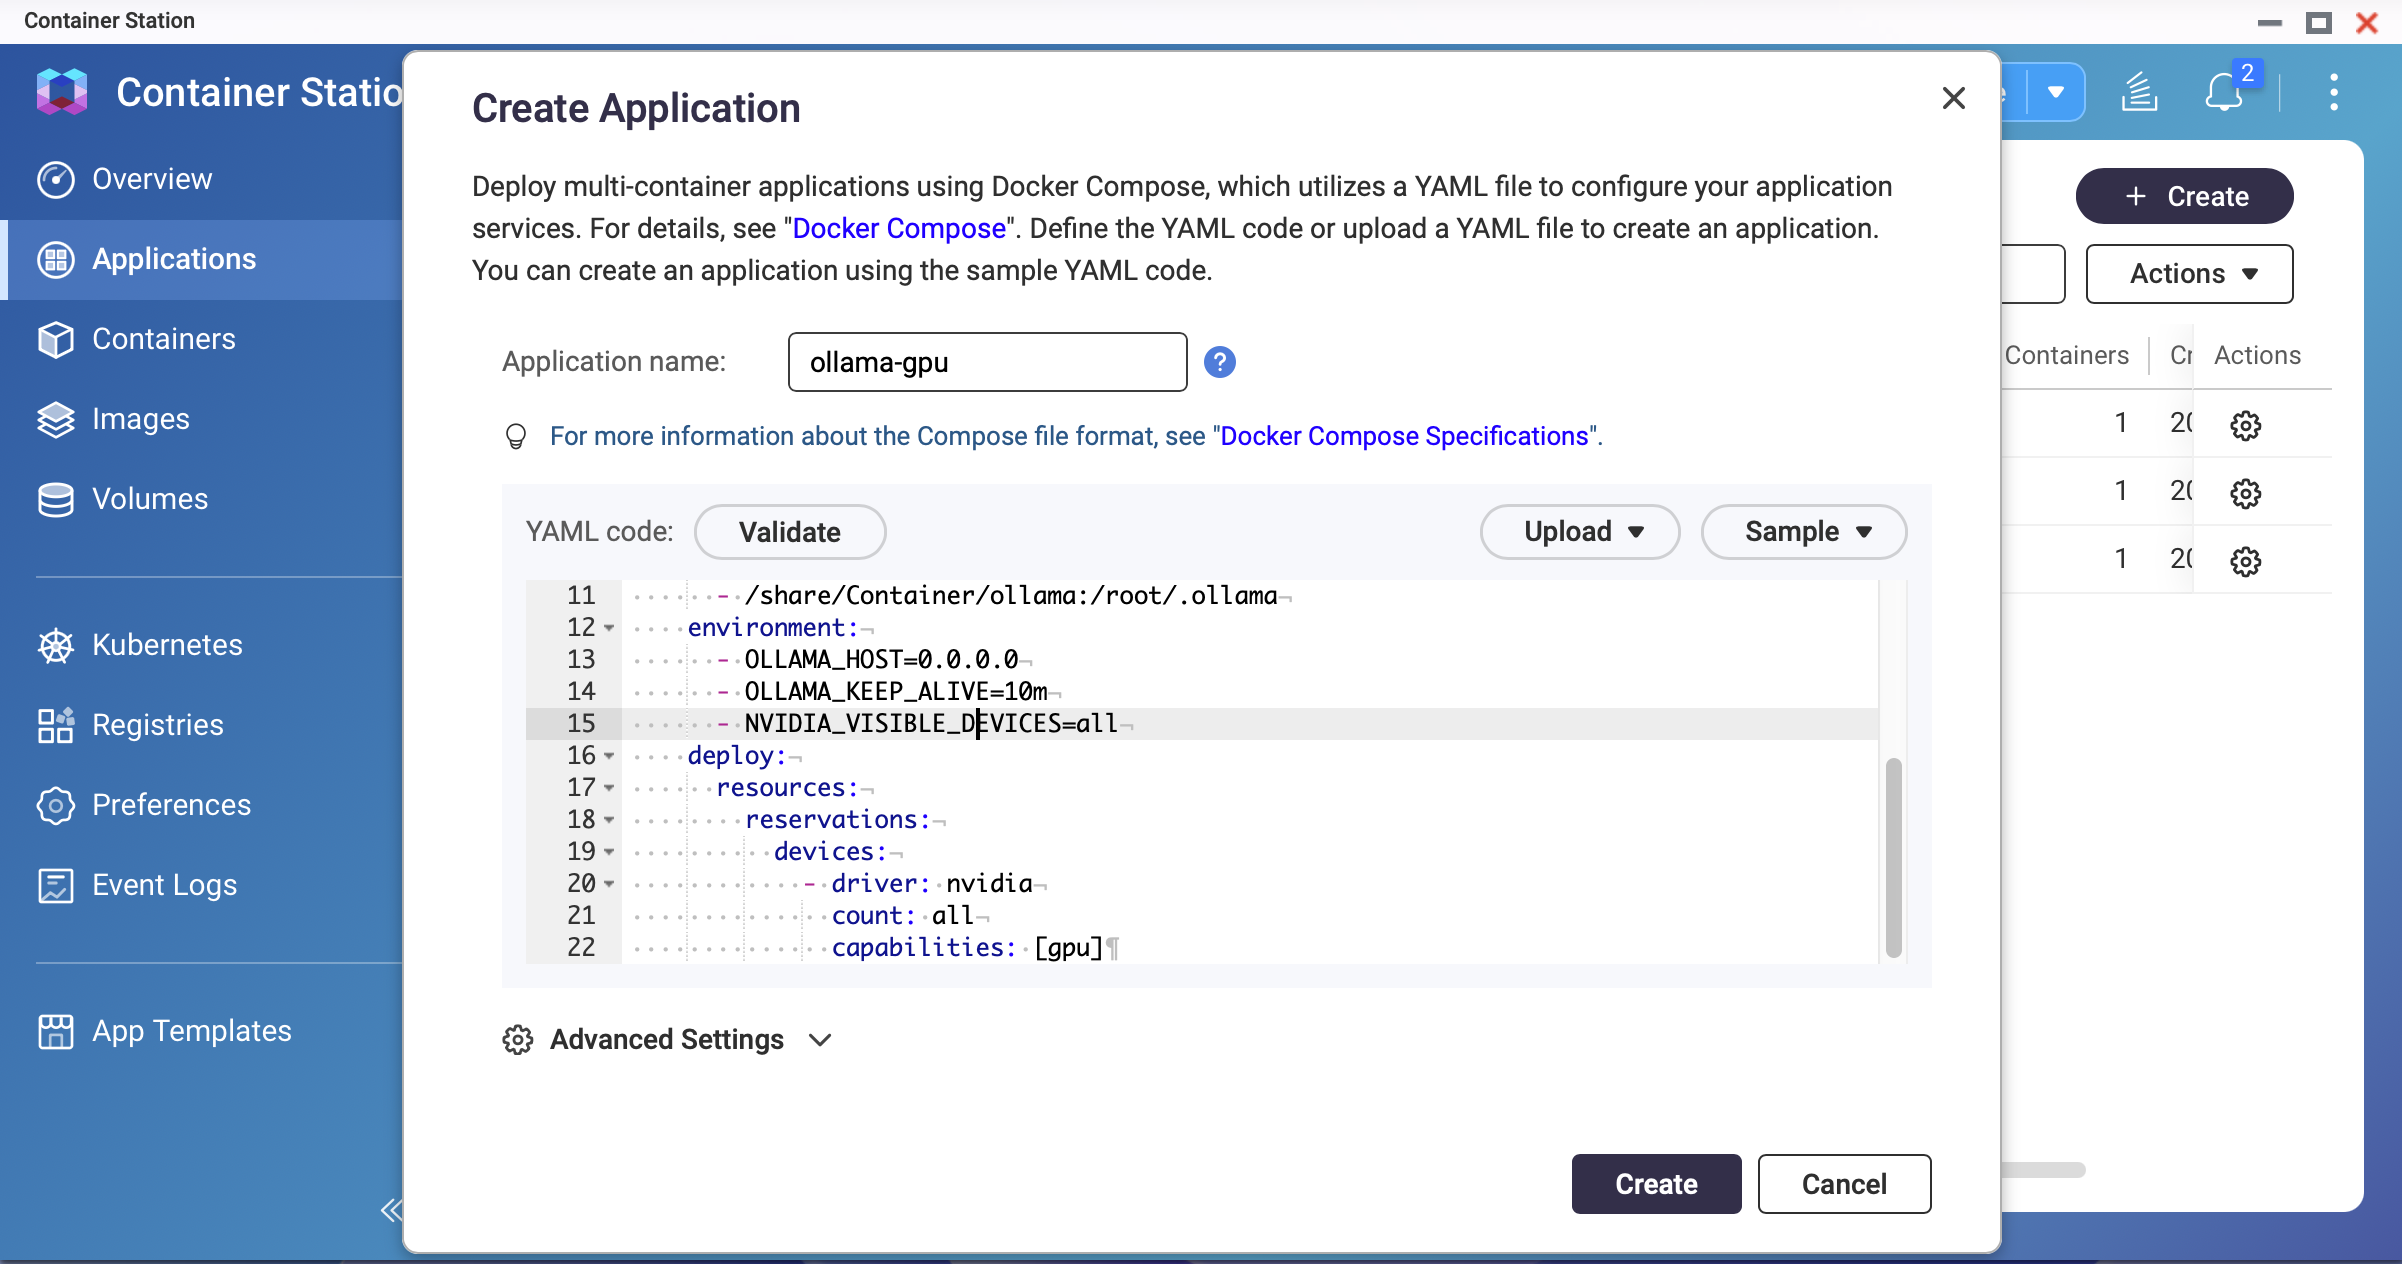 Schermafbeelding: Container Station — GPU-ingeschakelde Docker Compose YAMLOpmerkingDe meegeleverde NVIDIA-drivers van QNAP kunnen ouder zijn dan de nieuwste release. Als de container niet start met GPU ingeschakeld, controleer dan de stuurprogramma-versie met
nvidia-smiop de host en zorg ervoor dat deze compatibel is met de Ollama image-versieImplementeer en verifieer GPU-toegang.
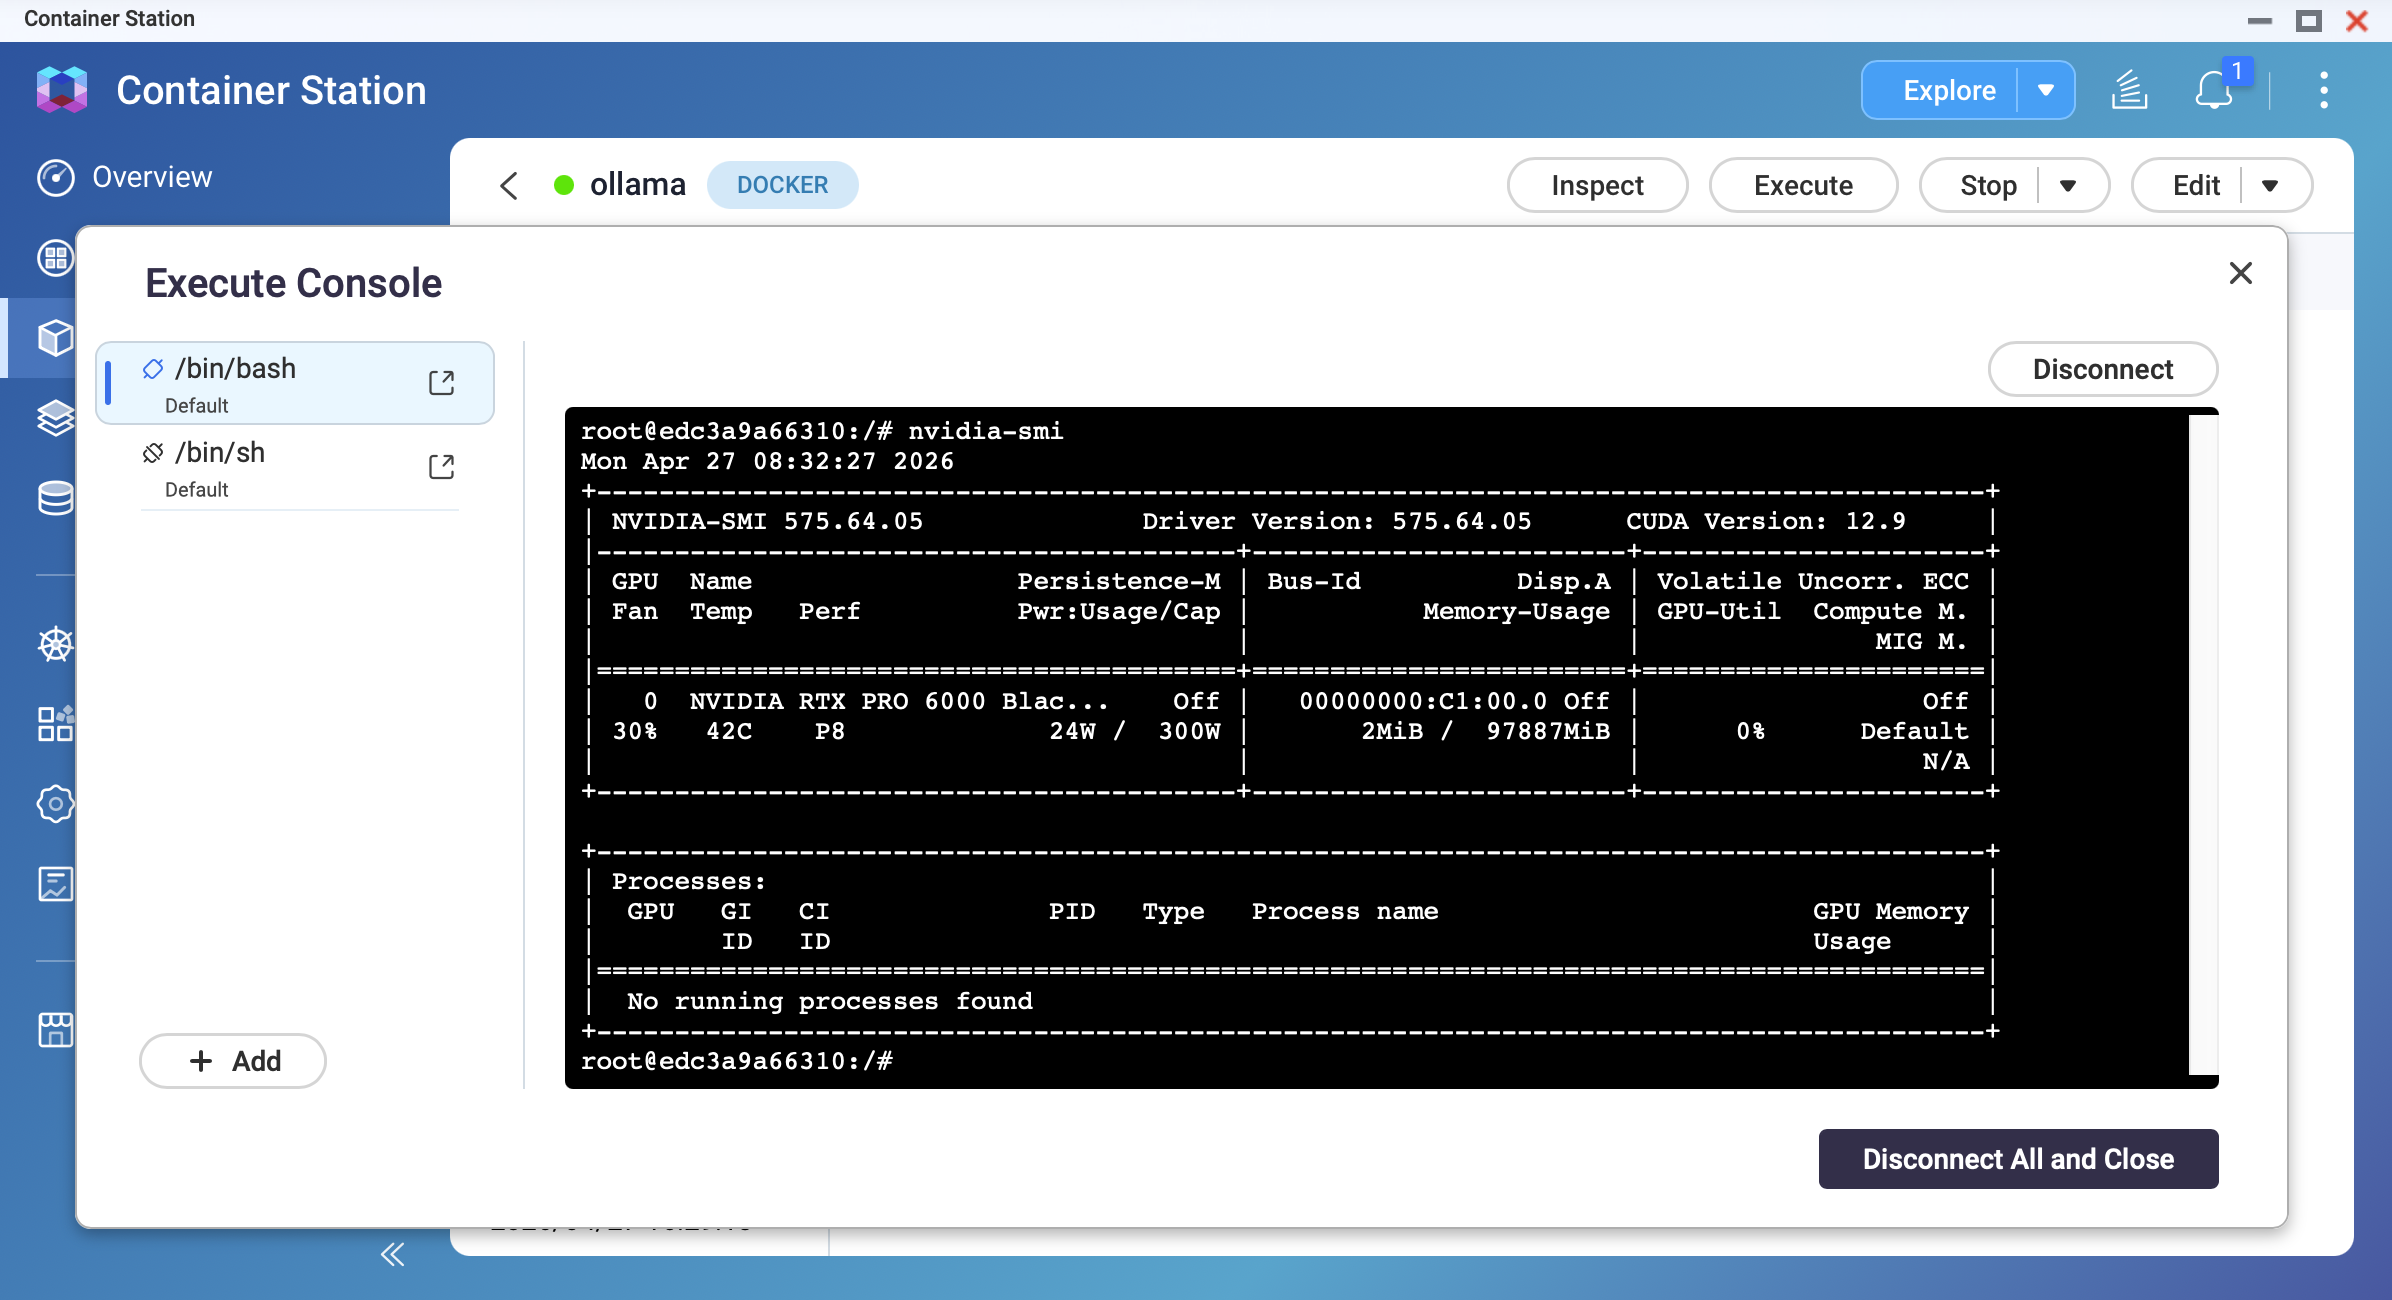
Nadat de container is gestart, open de terminal en voer uit:
nvidia-smiU zou uw GPU-model, stuurprogramma-versie en geheugeninformatie moeten zien.
Haal een model op en bevestig GPU-versnelling.
ollama pull qwen3.5:9b ollama run qwen3.5:9bTerwijl het model een reactie genereert, open een andere terminal en voer
nvidia-smiuit. U zou een toename van GPU-geheugengebruik en GPU-utilisatie moeten waarnemen.
Resultaat
Na het voltooien van deze tutorial, zult u hebben:
- Ollama draaiend op uw QNAP NAS bij
http://<NAS-IP>:11434 - Modelgegevens opgeslagen in
/share/Container/ollama(overleeft containerherbouw) - Een werkende LLM toegankelijk via de Ollama API
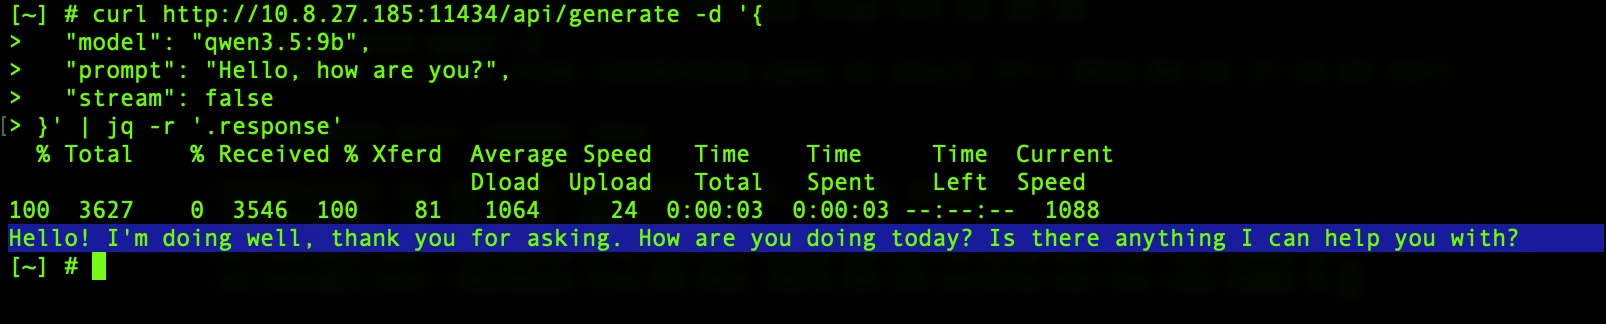
U kunt de API testen vanaf elk apparaat op uw lokale netwerk:
curl http://<NAS-IP>:11434/api/generate -d '{
  "model": "qwen3.5:9b",
  "prompt": "Hello, how are you?",
  "stream": false
}'
OLLAMA_HOST=0.0.0.0 instelling stelt de Ollama API bloot op alle netwerkinterfaces. Stel poort 11434 niet bloot aan het internet. Gebruik Firewall regels of de netwerkinstellingen van QNAP om de toegang te beperken tot alleen uw lokale netwerk.Probleemoplossing
Container stopt onmiddellijk na starten
Dit kan worden veroorzaakt door onvoldoende RAM of een mismatch van de GPU-driver. Controleer containerlogs in Container Station. Verminder geheugenbeperkingen of schakel GPU-modus uit.
Model ophalen mislukt halverwege
Dit kan het gevolg zijn van onvoldoende schijfruimte of een netwerk-timeout. Probeer Opslag ruimte vrij te maken. Voer ollama pull opnieuw uit; het systeem hervat vanaf waar het stopte.
Reactiesnelheid is erg traag (1–3 tokens per seconde)
Het model draait mogelijk op de CPU in plaats van de GPU, of het model is te groot voor uw RAM. Controleer uw GPU-toegang met nvidia-smi binnen de container. Probeer een kleiner model te gebruiken.
De NAS reageert niet tijdens inferentie
Dit kan een "out of memory" probleem zijn: het model verbruikt al het systeemgeheugen. We raden aan de NAS opnieuw op te starten. Stel een geheugenverbruiksbeperking in de applicatie in. Of gebruik een kleiner model.
"Kan geen verbinding maken met Ollama" melding van Open WebUI
Dit kan worden veroorzaakt door een verkeerde API-URL of Docker netwerkisolatie. U kunt http://ollama:11434 gebruiken als u op hetzelfde Docker netwerk bent.
Voor verdere hulp kunt u andere gebruikers en QNAP-experts in de community vragen. Ga naar de QNAP Community


