


Hur man distribuerar Ollama på QNAP NAS med hjälp av Container Station
Tillämpliga produkter
QTS, QuTS hero
Container Station
Scenario
Du vill köra stora språkmodeller (LLM) lokalt på din QNAP NAS för privat AI-chat, kodassistans eller dokumentanalys utan att skicka data till molnet. Ollama är den mest populära och nybörjarvänliga inferensmotorn för detta ändamål. Denna handledning förklarar hur man distribuerar Ollama på QNAP NAS med Container Station.
Systemkrav
| Krav | Detalj |
|---|---|
| QNAP-app | Container Station 3.x eller senare |
| NAS-arkitektur | x86_64 (Intel eller AMD CPU) (Endast några få ARM-baserade modeller stöds.) |
| Minne |
|
| Lagring-utrymme |
|
| GPU (valfritt) | Kompatibla NVIDIA GPU:er (se Kompatibilitetslistan) GPU bör ställas in på Container Station-läge i Kontrollpanelen. |
Ollama kommer att försöka ladda hela modellen i minnet som standard. Om din NAS har endast 8–16 GB RAM kan laddning av en 14B eller större modell tömma systemminnet, vilket gör att NAS-tjänster blir oresponsiva eller att systemet startar om.
Risk för dataförlust
Om du inte monterar en beständig volym för
/root/.ollama, kommer alla nedladdade modeller och konfigurationer att gå förlorade när containern tas bort eller återskapas. Följ alltid volymmonteringsinstruktionerna i denna handledning.- Kontrollera modellens storlek mot ditt tillgängliga RAM i förväg.
- Ställ in minnesgränser för att begränsa containerminnesanvändningen.
- Börja med små modeller (1B eller 3B) och bedöm systemets stabilitet innan du försöker med större modeller.
Procedur
Metod 1: Endast CPU-distribution (ingen GPU krävs)
Skapa Lagring mappar.
Öppna File Station och skapa följande mapp för att lagra Ollama-modelldata:
/share/Container/ollama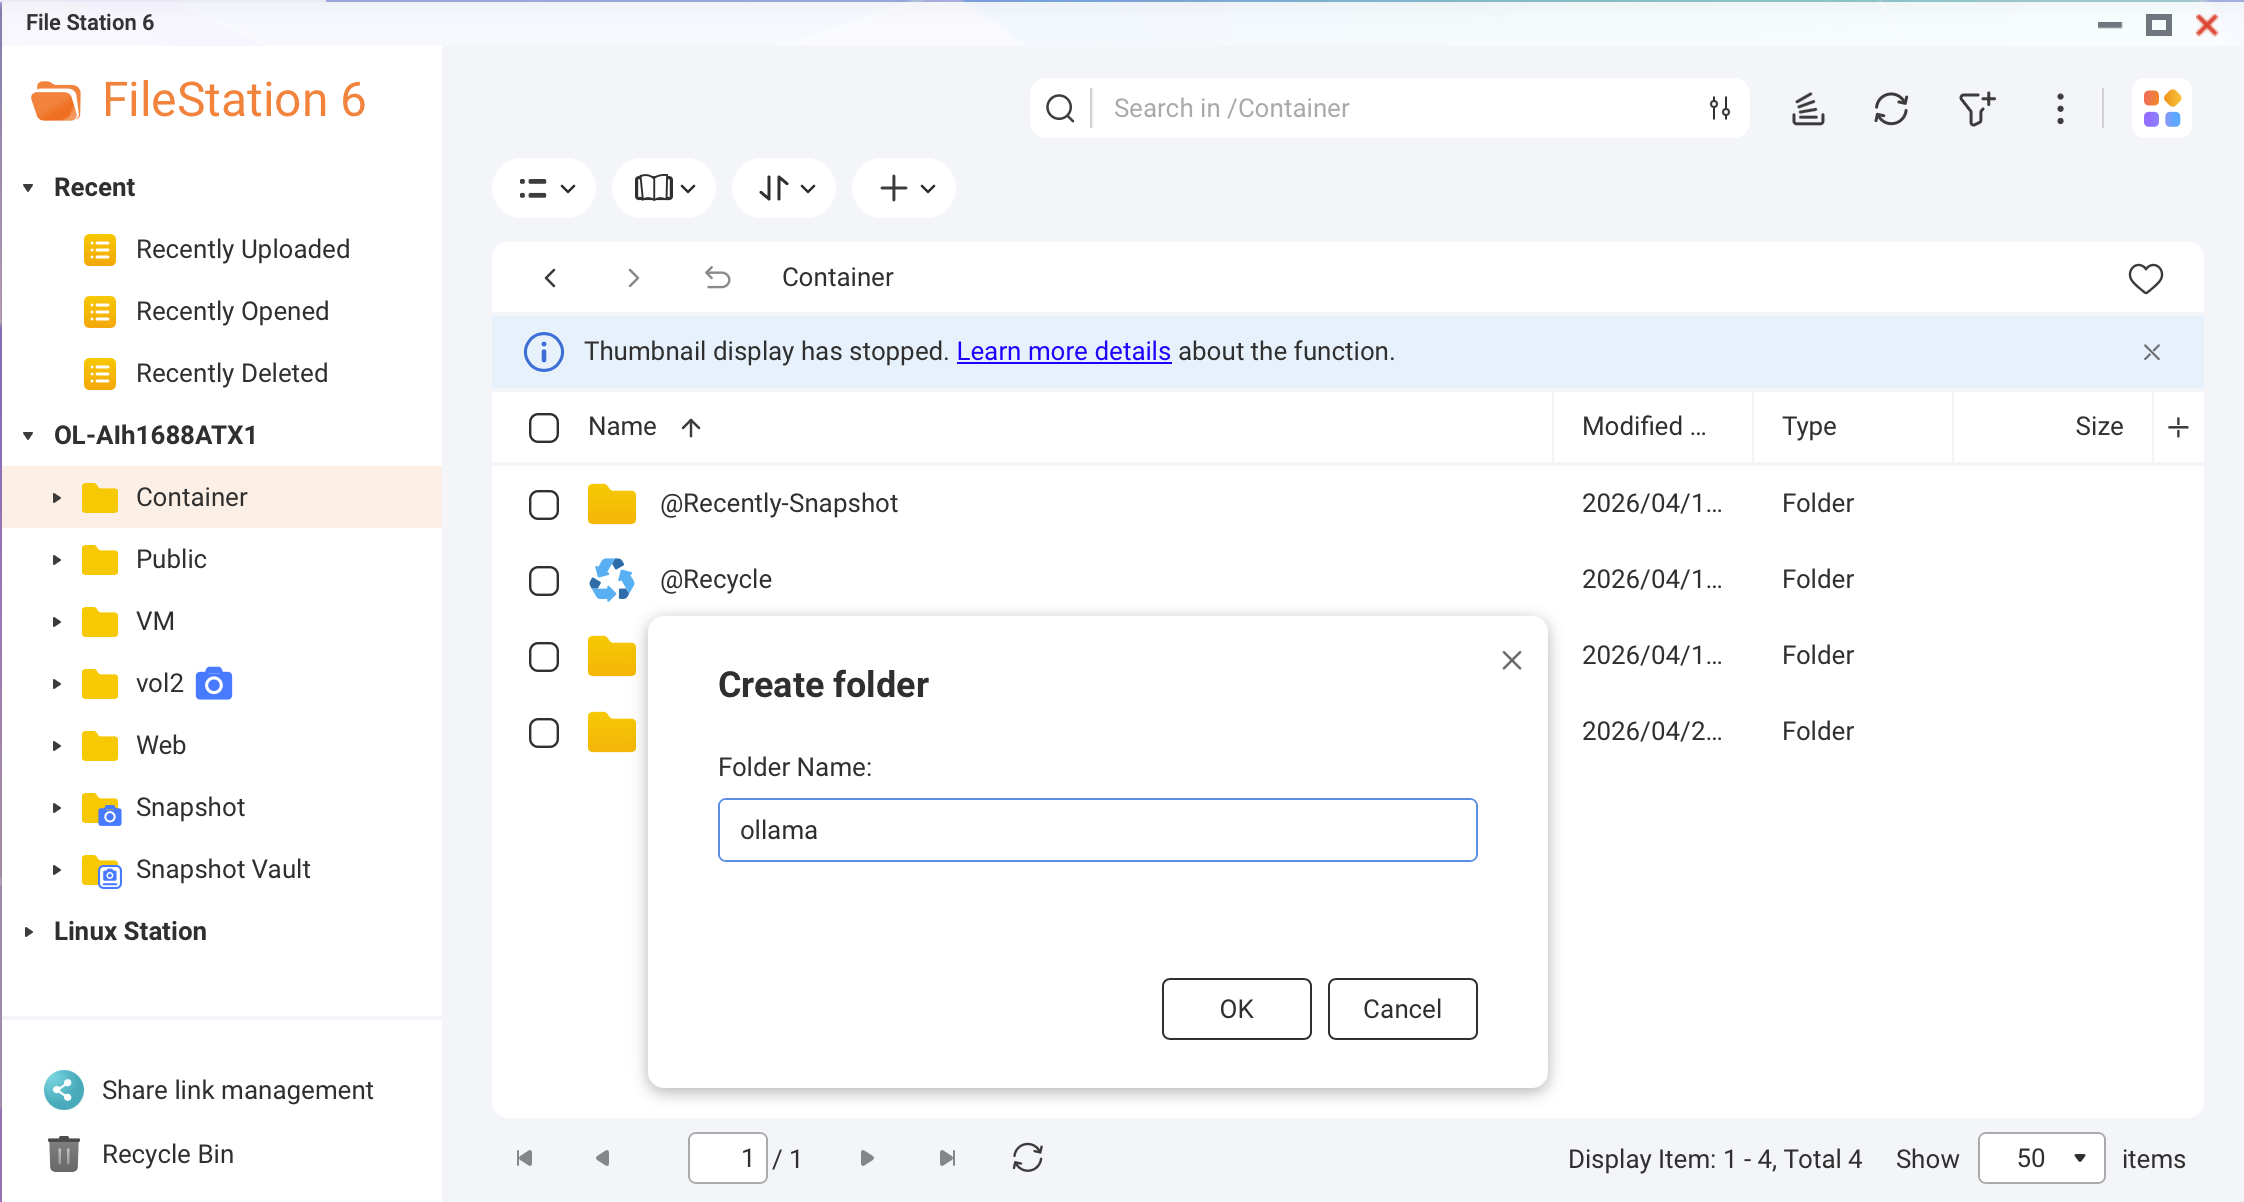 Skärmdump: File Station — skapar Ollama-mappen under /share/Container/BranschrekommendationerOm din NAS har en NVMe SSD-cache eller SSD-volym, skapa denna mapp på SSD:n. Modellens laddningshastighet förbättras med upp till 10 gånger jämfört med HDD.
Skapa en Docker Compose-fil.
I Container Station, gå till Applications > Create. Namnge applikationen
ollamaoch klistra in följande YAML:version: "3.8" services: ollama: image: ollama/ollama:latest container_name: ollama restart: unless-stopped ports: - "11434:11434" volumes: - /share/Container/ollama:/root/.ollama environment: - OLLAMA_HOST=0.0.0.0 - OLLAMA_KEEP_ALIVE=10m networks: - ai-network networks: ai-network: name: ai-network driver: bridge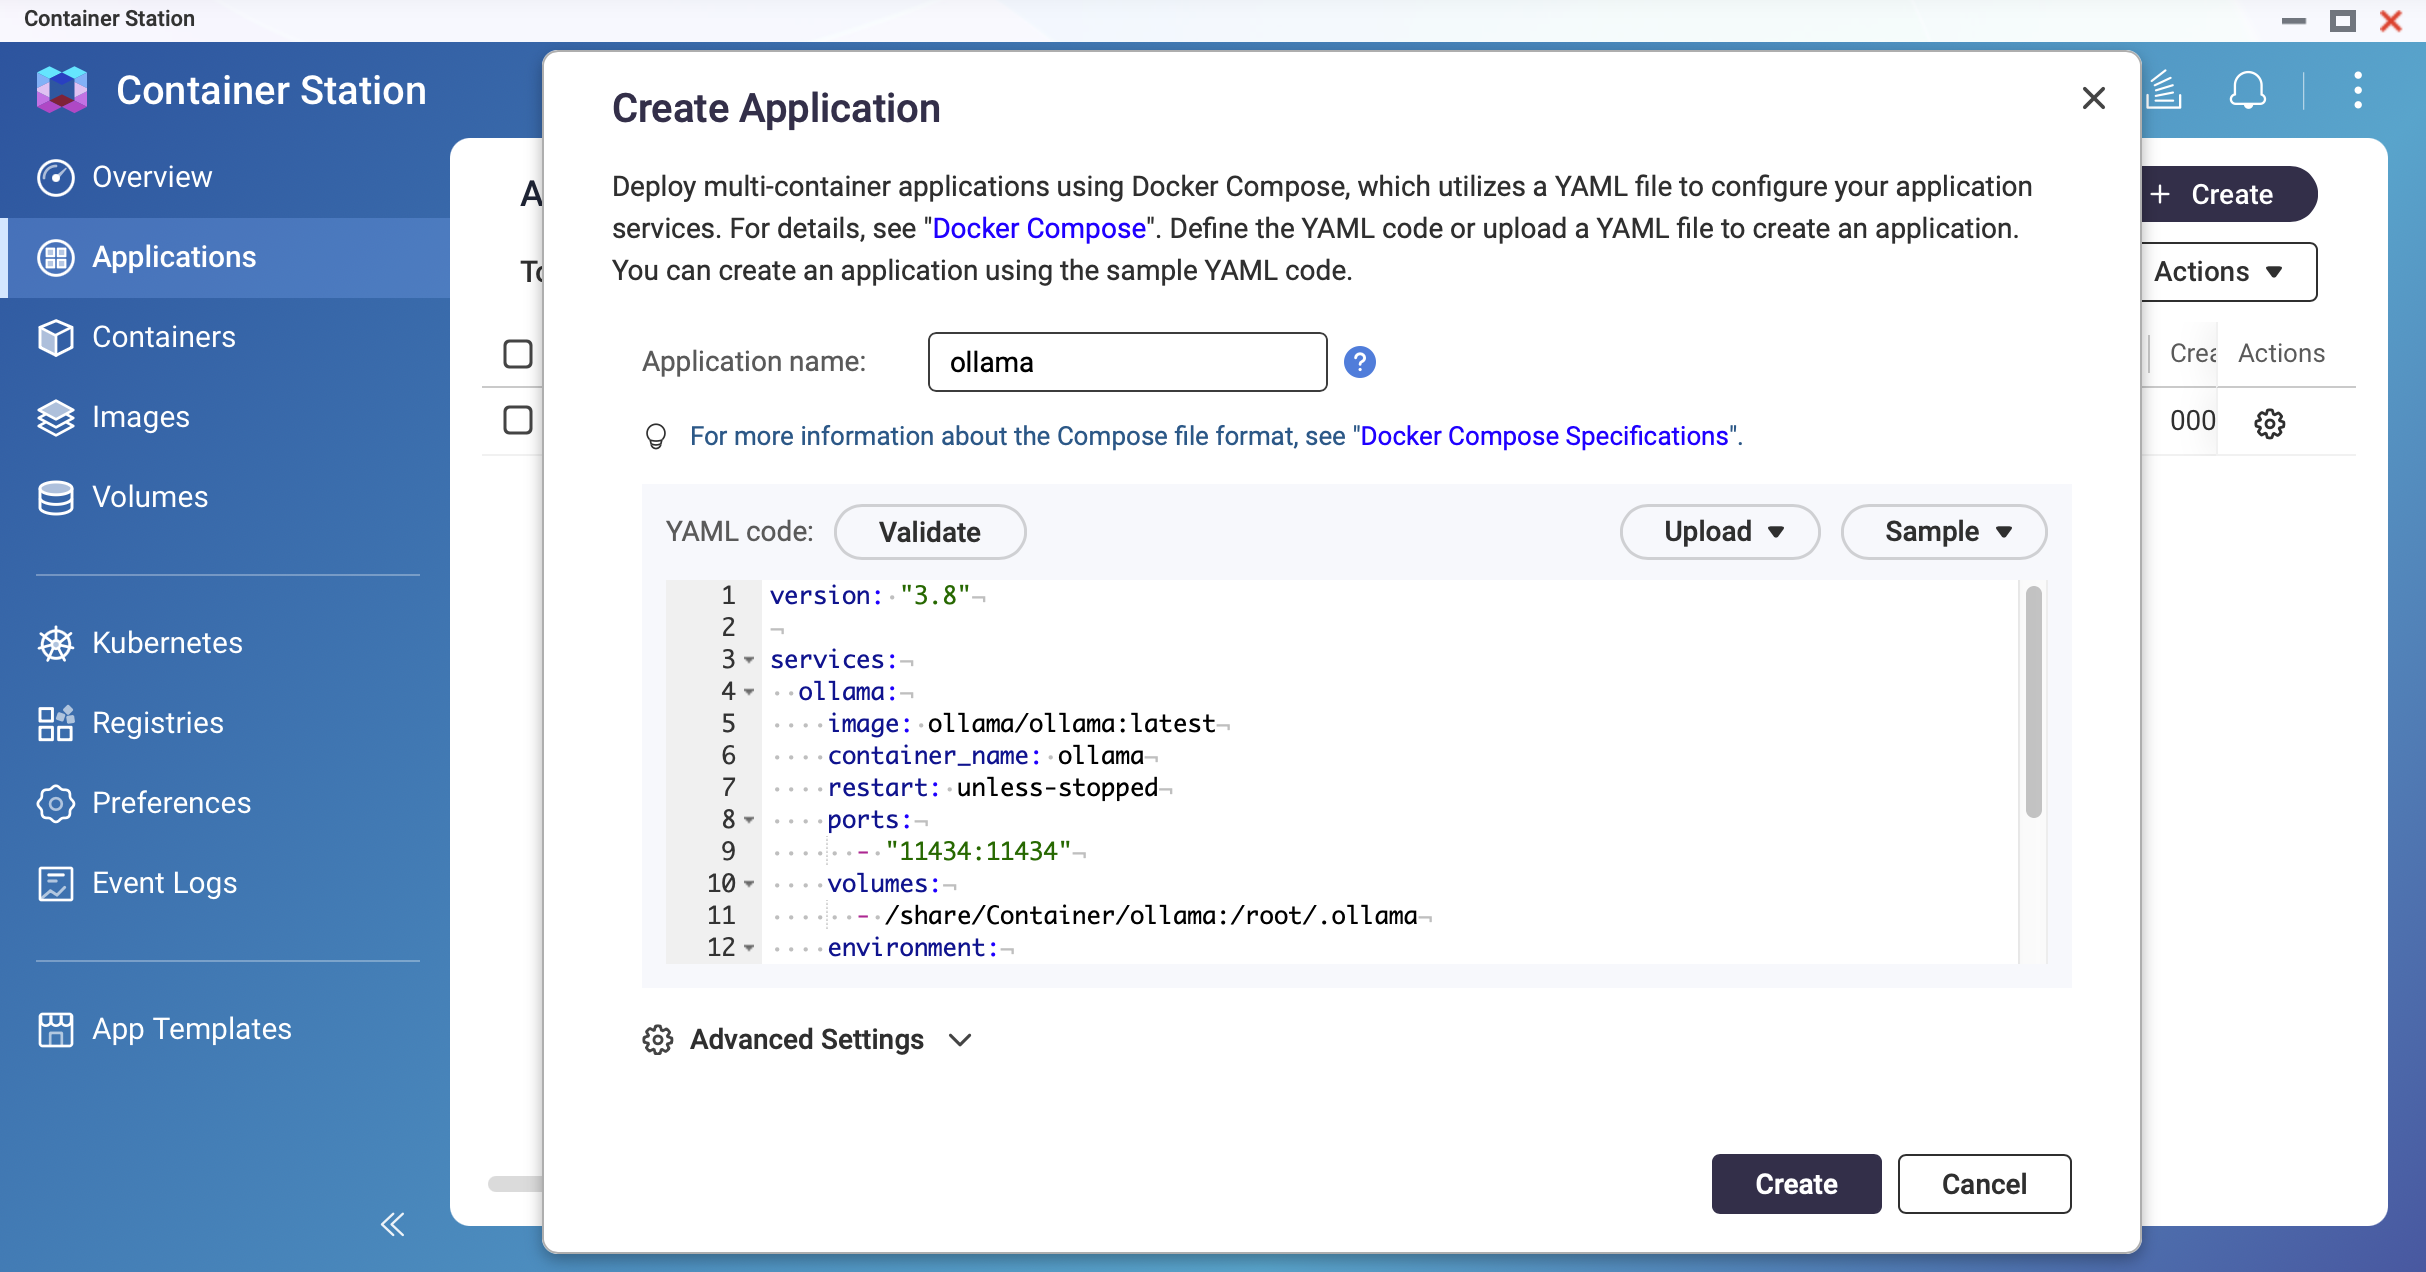 Skärmdump: Container Station — Skärm för applikationsskapande med YAML-redigerare
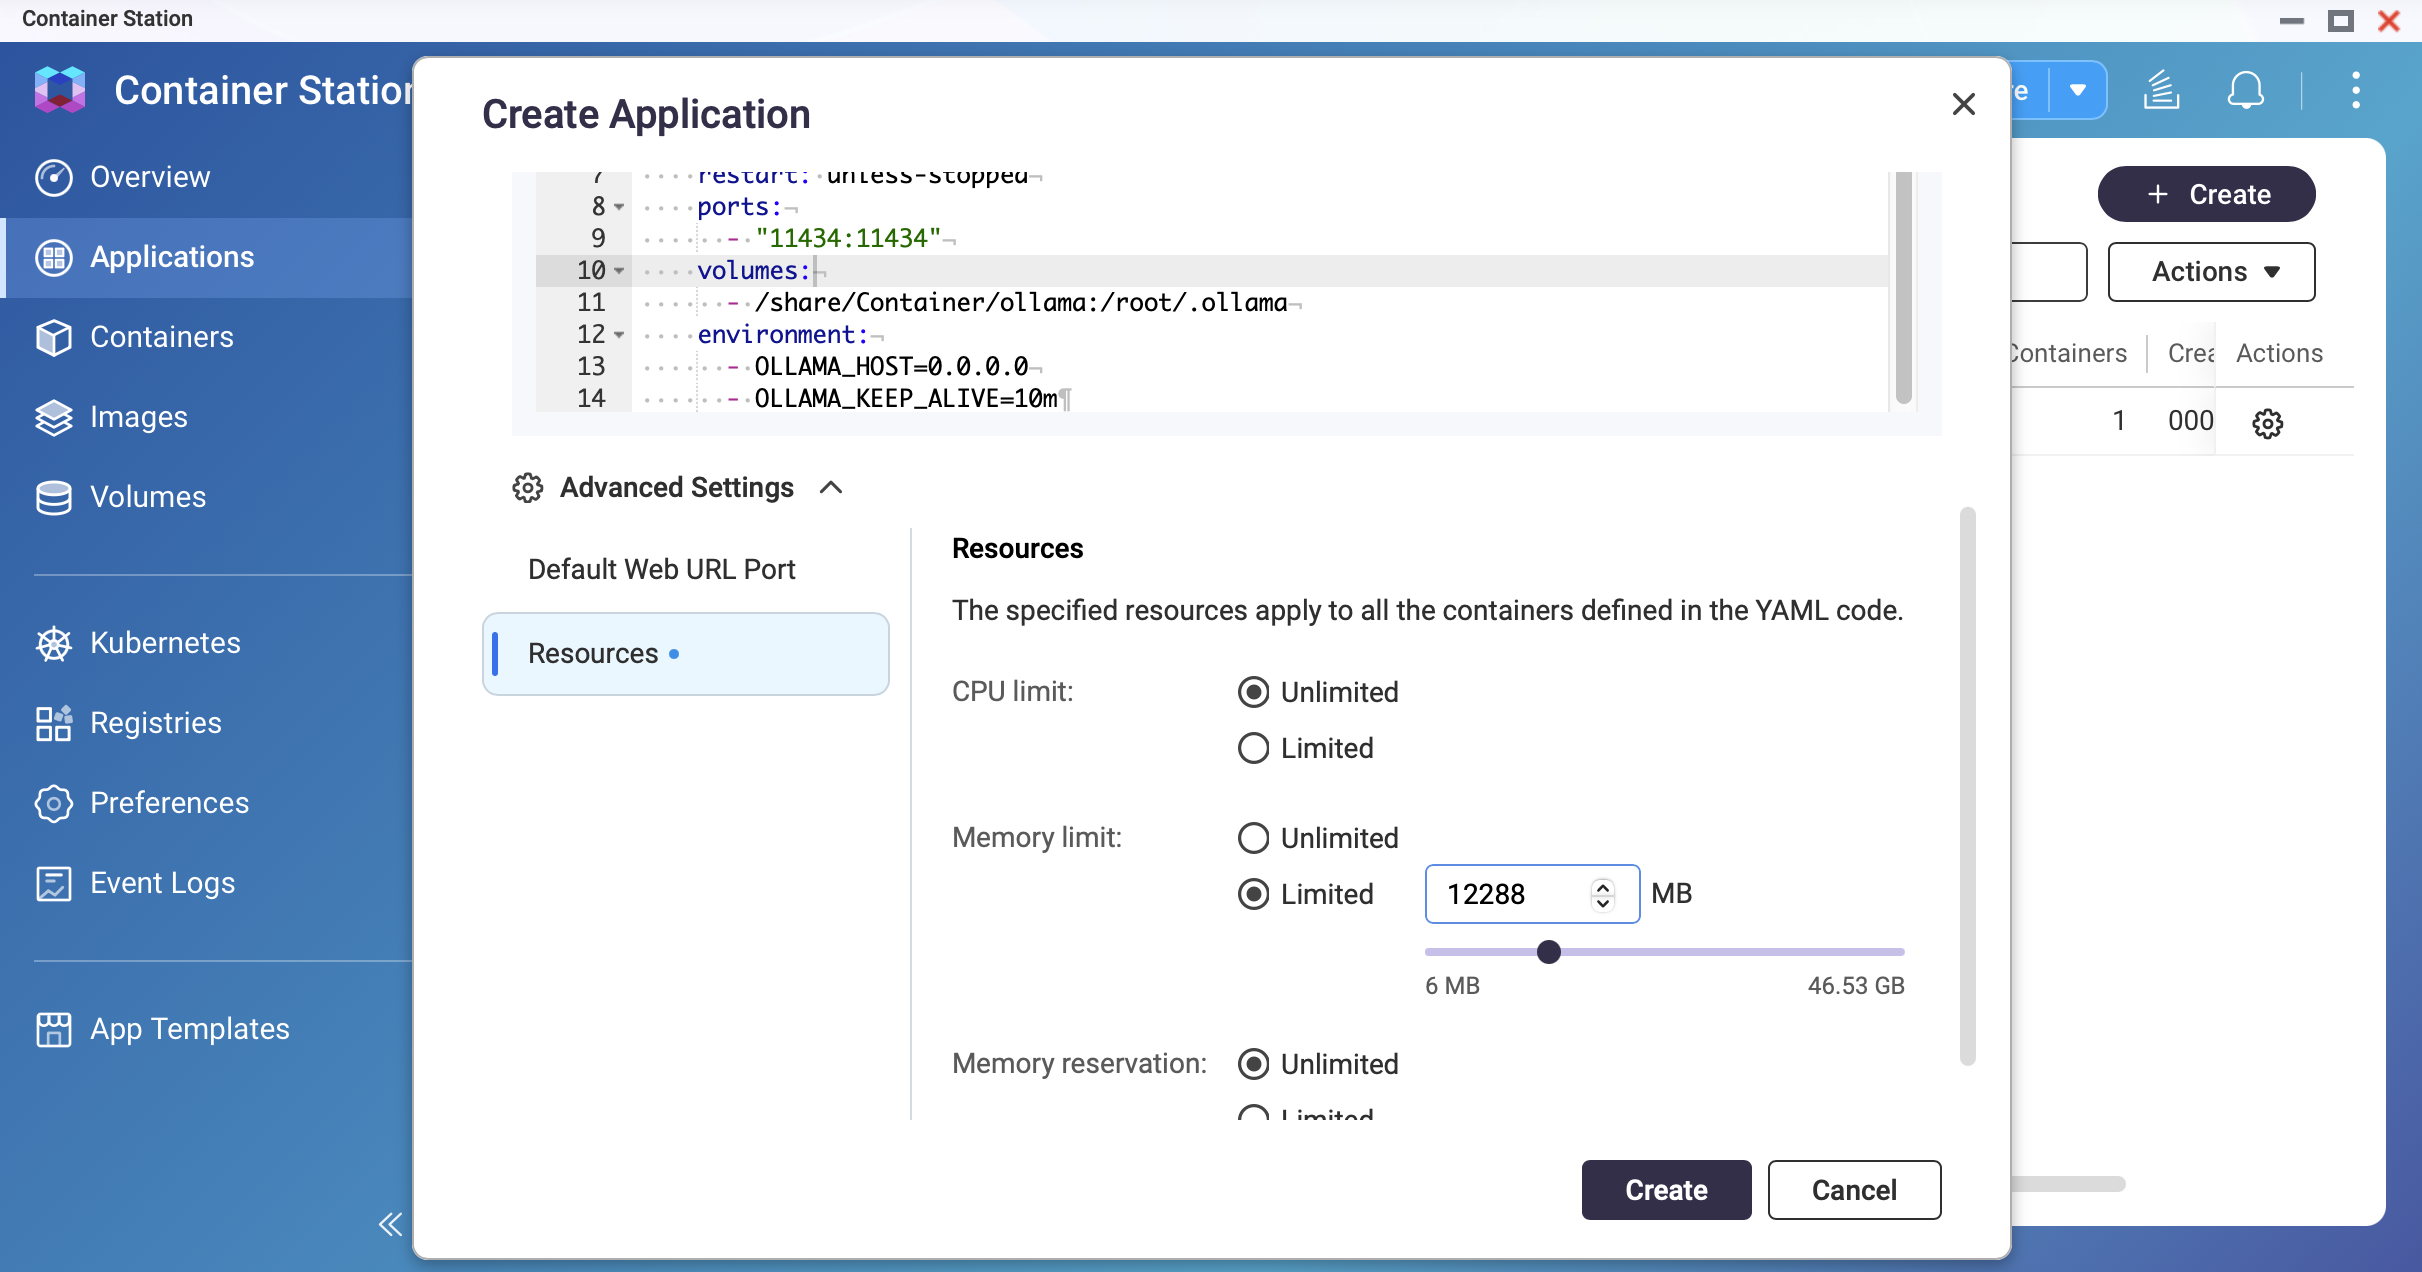 Skärmdump: Container Station — Ställ in minnesgränsen
Distribuera containern.
Klicka på Create. Container Station kommer att hämta Ollama-avbildningen och starta behållaren. Vänta tills statusen visar Running.
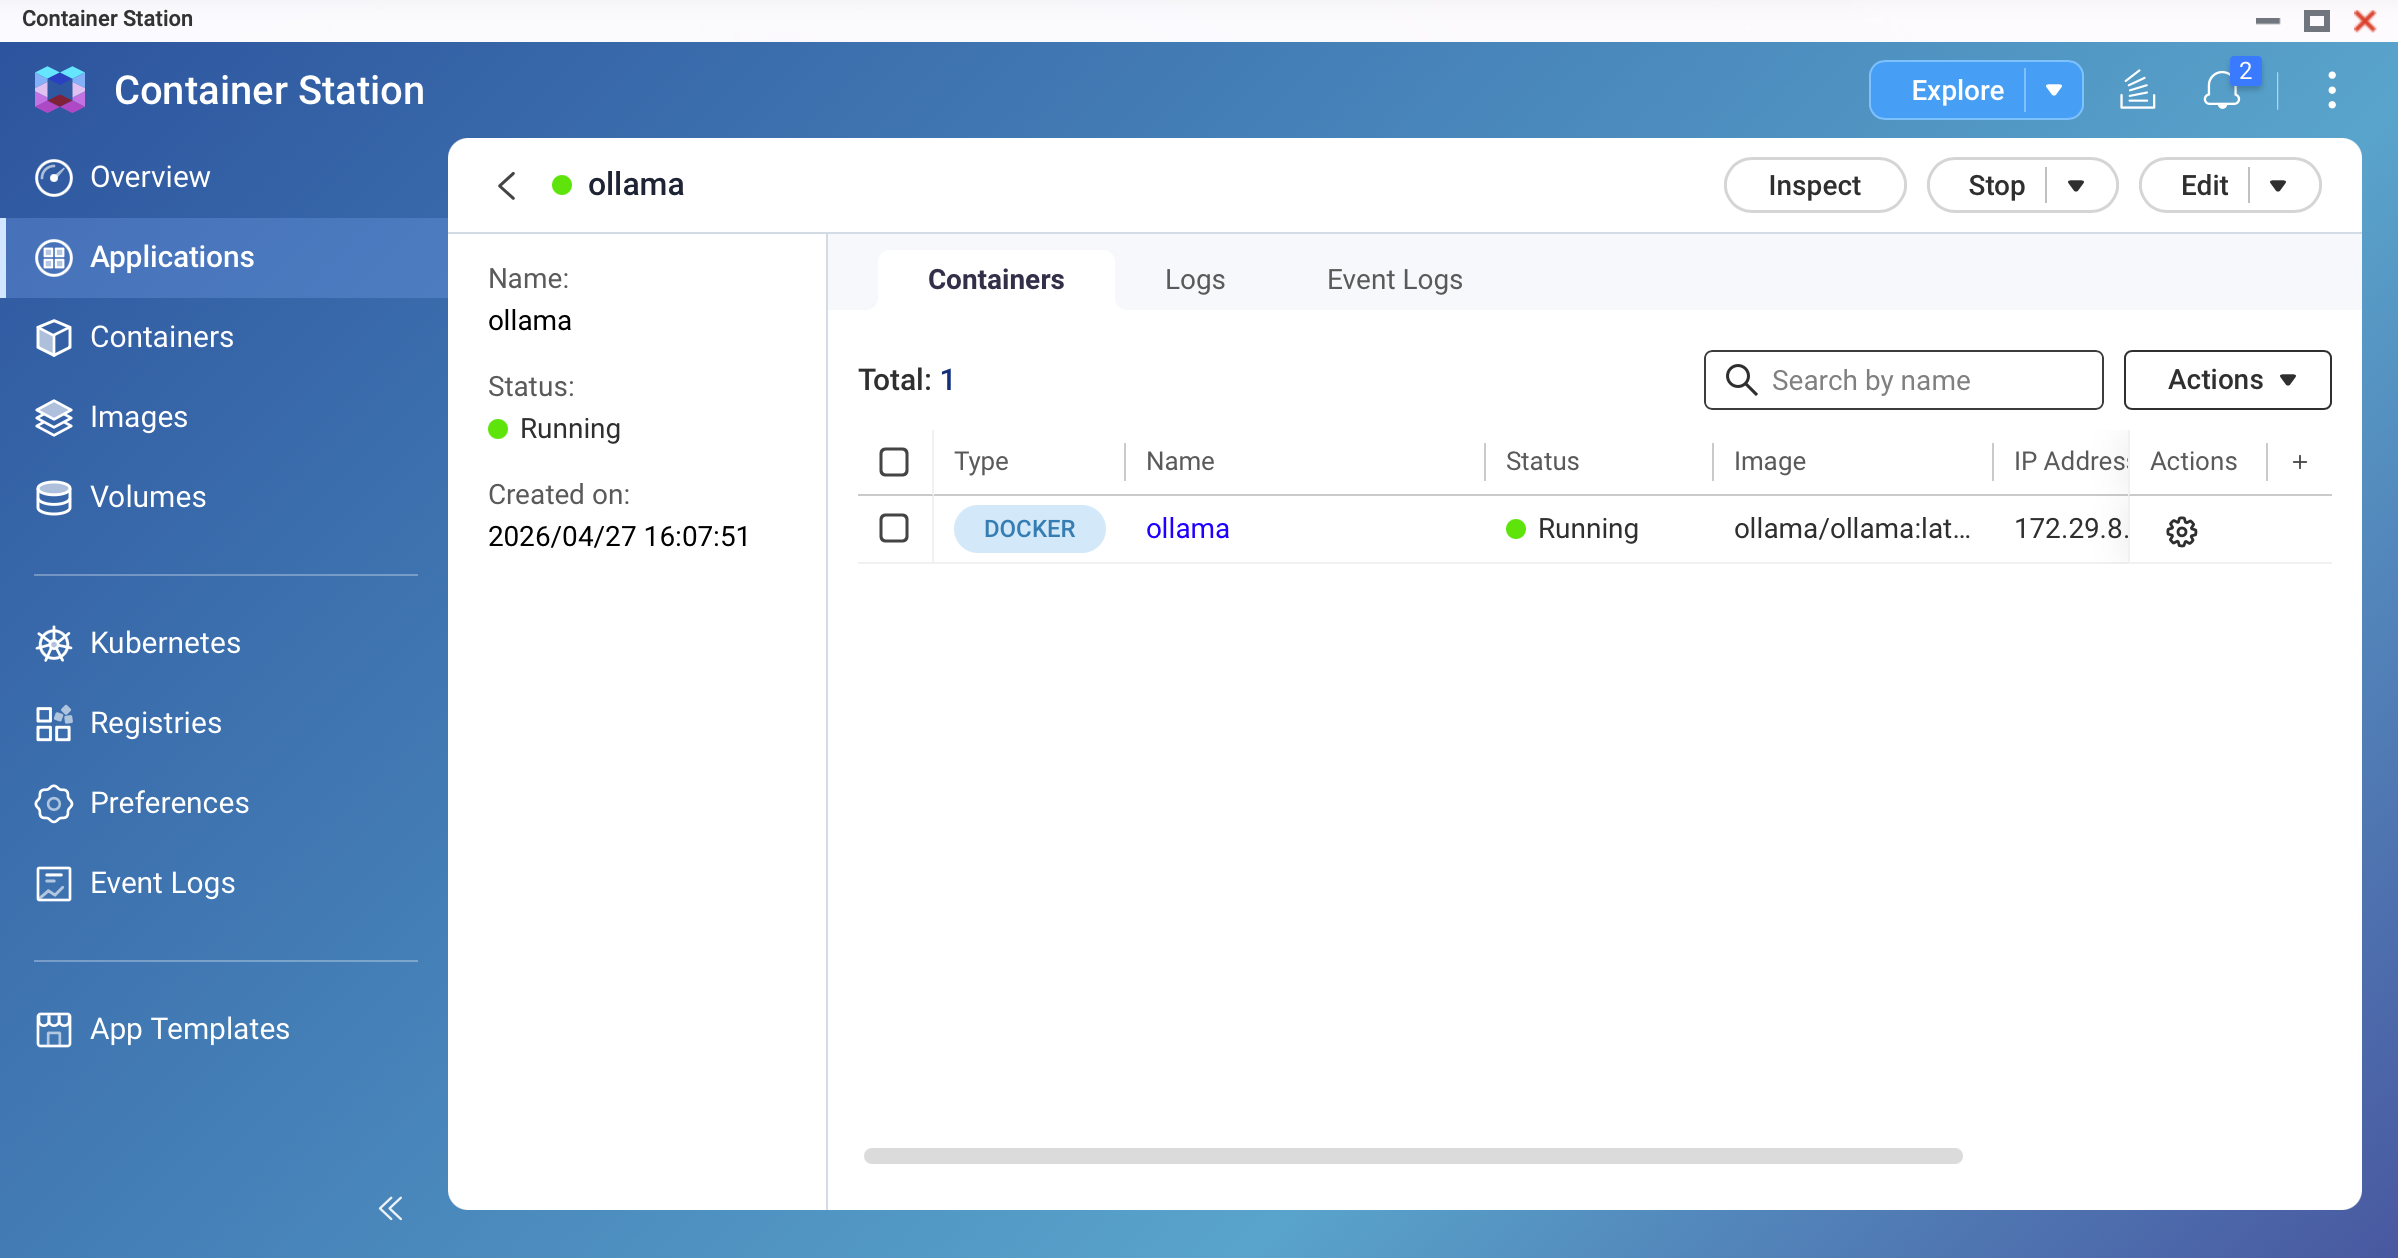 Skärmdump: Container Station — ollama-behållare som visar "Running"-status
Dra din första modell.
Öppna behållarens Terminal (eller SSH till din NAS och kör din Docker) och kör:
# För en lätt 3B-modell (rekommenderas för första testet): ollama pull llama3.2:3b # För en standard 9B-modell (kräver 16 GB+ RAM): ollama pull qwen3.5:9bNedladdningen kan ta flera minuter beroende på din internetanslutning. En 9B Q4_K_M-modell är ungefär 4–7 GB.
Obs- Kontrollera att du har tillräckligt med diskutrymme innan du hämtar. Använd
ollama listför att kontrollera befintliga modeller och deras storlekar. - För ARM-baserade NAS-modeller rekommenderar vi att börja med <1B-modellen för att övervaka minnesanvändningen.
- Kontrollera att du har tillräckligt med diskutrymme innan du hämtar. Använd
Testa modellen.
Kör i behållarens terminal:
ollama run qwen3.5:9bSkriv en prompt och bekräfta att du får ett svar. Skriv
/byeför att avsluta.
Metod 2: NVIDIA GPU-accelererad distribution
Ytterligare förutsättningar för GPU-läge:
- NVIDIA GPU installerad och upptäckt av QTS/QuTS hero
- GPU inställd på Container Station-läge i Kontrollpanelen
- NVIDIA GPU-drivrutin och NvKernelDriver installerad från App Center
Använd den GPU-aktiverade Docker Compose-konfigurationen.
Byt ut YAML från metod 1 med följande:
version: "3.8" services: ollama: image: ollama/ollama:latest container_name: ollama restart: unless-stopped ports: - "11434:11434" volumes: - /share/Container/ollama:/root/.ollama environment: - OLLAMA_HOST=0.0.0.0 - OLLAMA_KEEP_ALIVE=10m - NVIDIA_VISIBLE_DEVICES=all deploy: resources: reservations: devices: - driver: nvidia count: all capabilities: [gpu] networks: - ai-network networks: ai-network: name: ai-network driver: bridge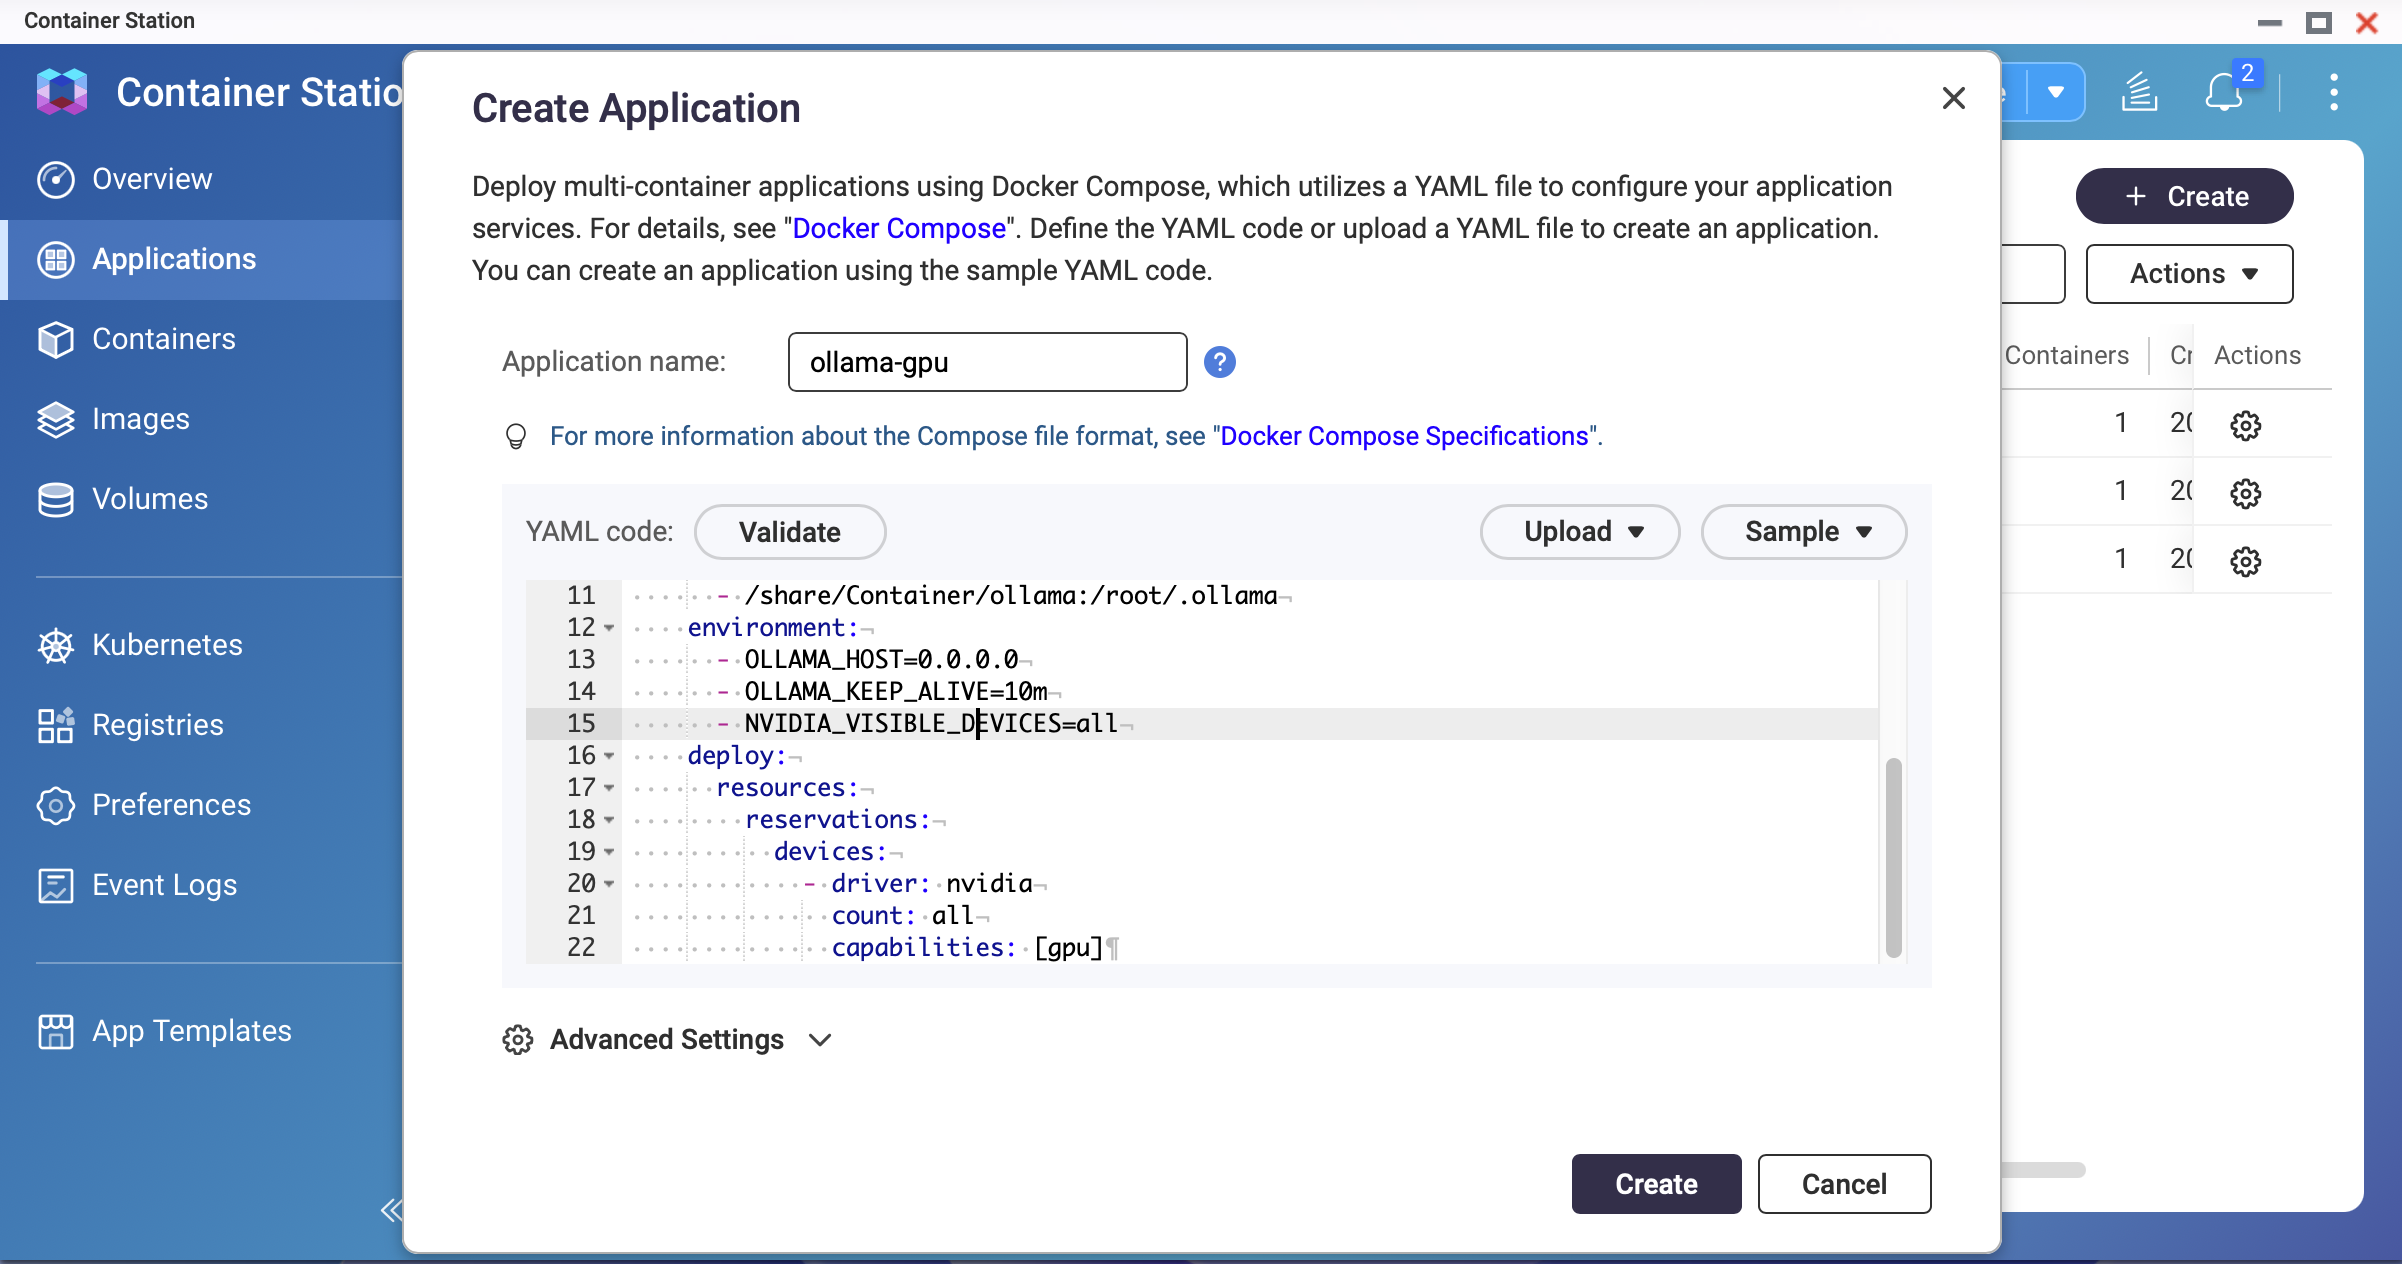 Skärmdump: Container Station — GPU-aktiverad Docker Compose YAMLObsQNAP:s medföljande NVIDIA-drivrutiner kan vara äldre än den senaste versionen. Om containern inte startar med GPU aktiverad, kontrollera drivrutinsversionen med
nvidia-smipå värden och säkerställ att den är kompatibel med Ollama-bildversionenDistribuera och verifiera GPU-åtkomst.
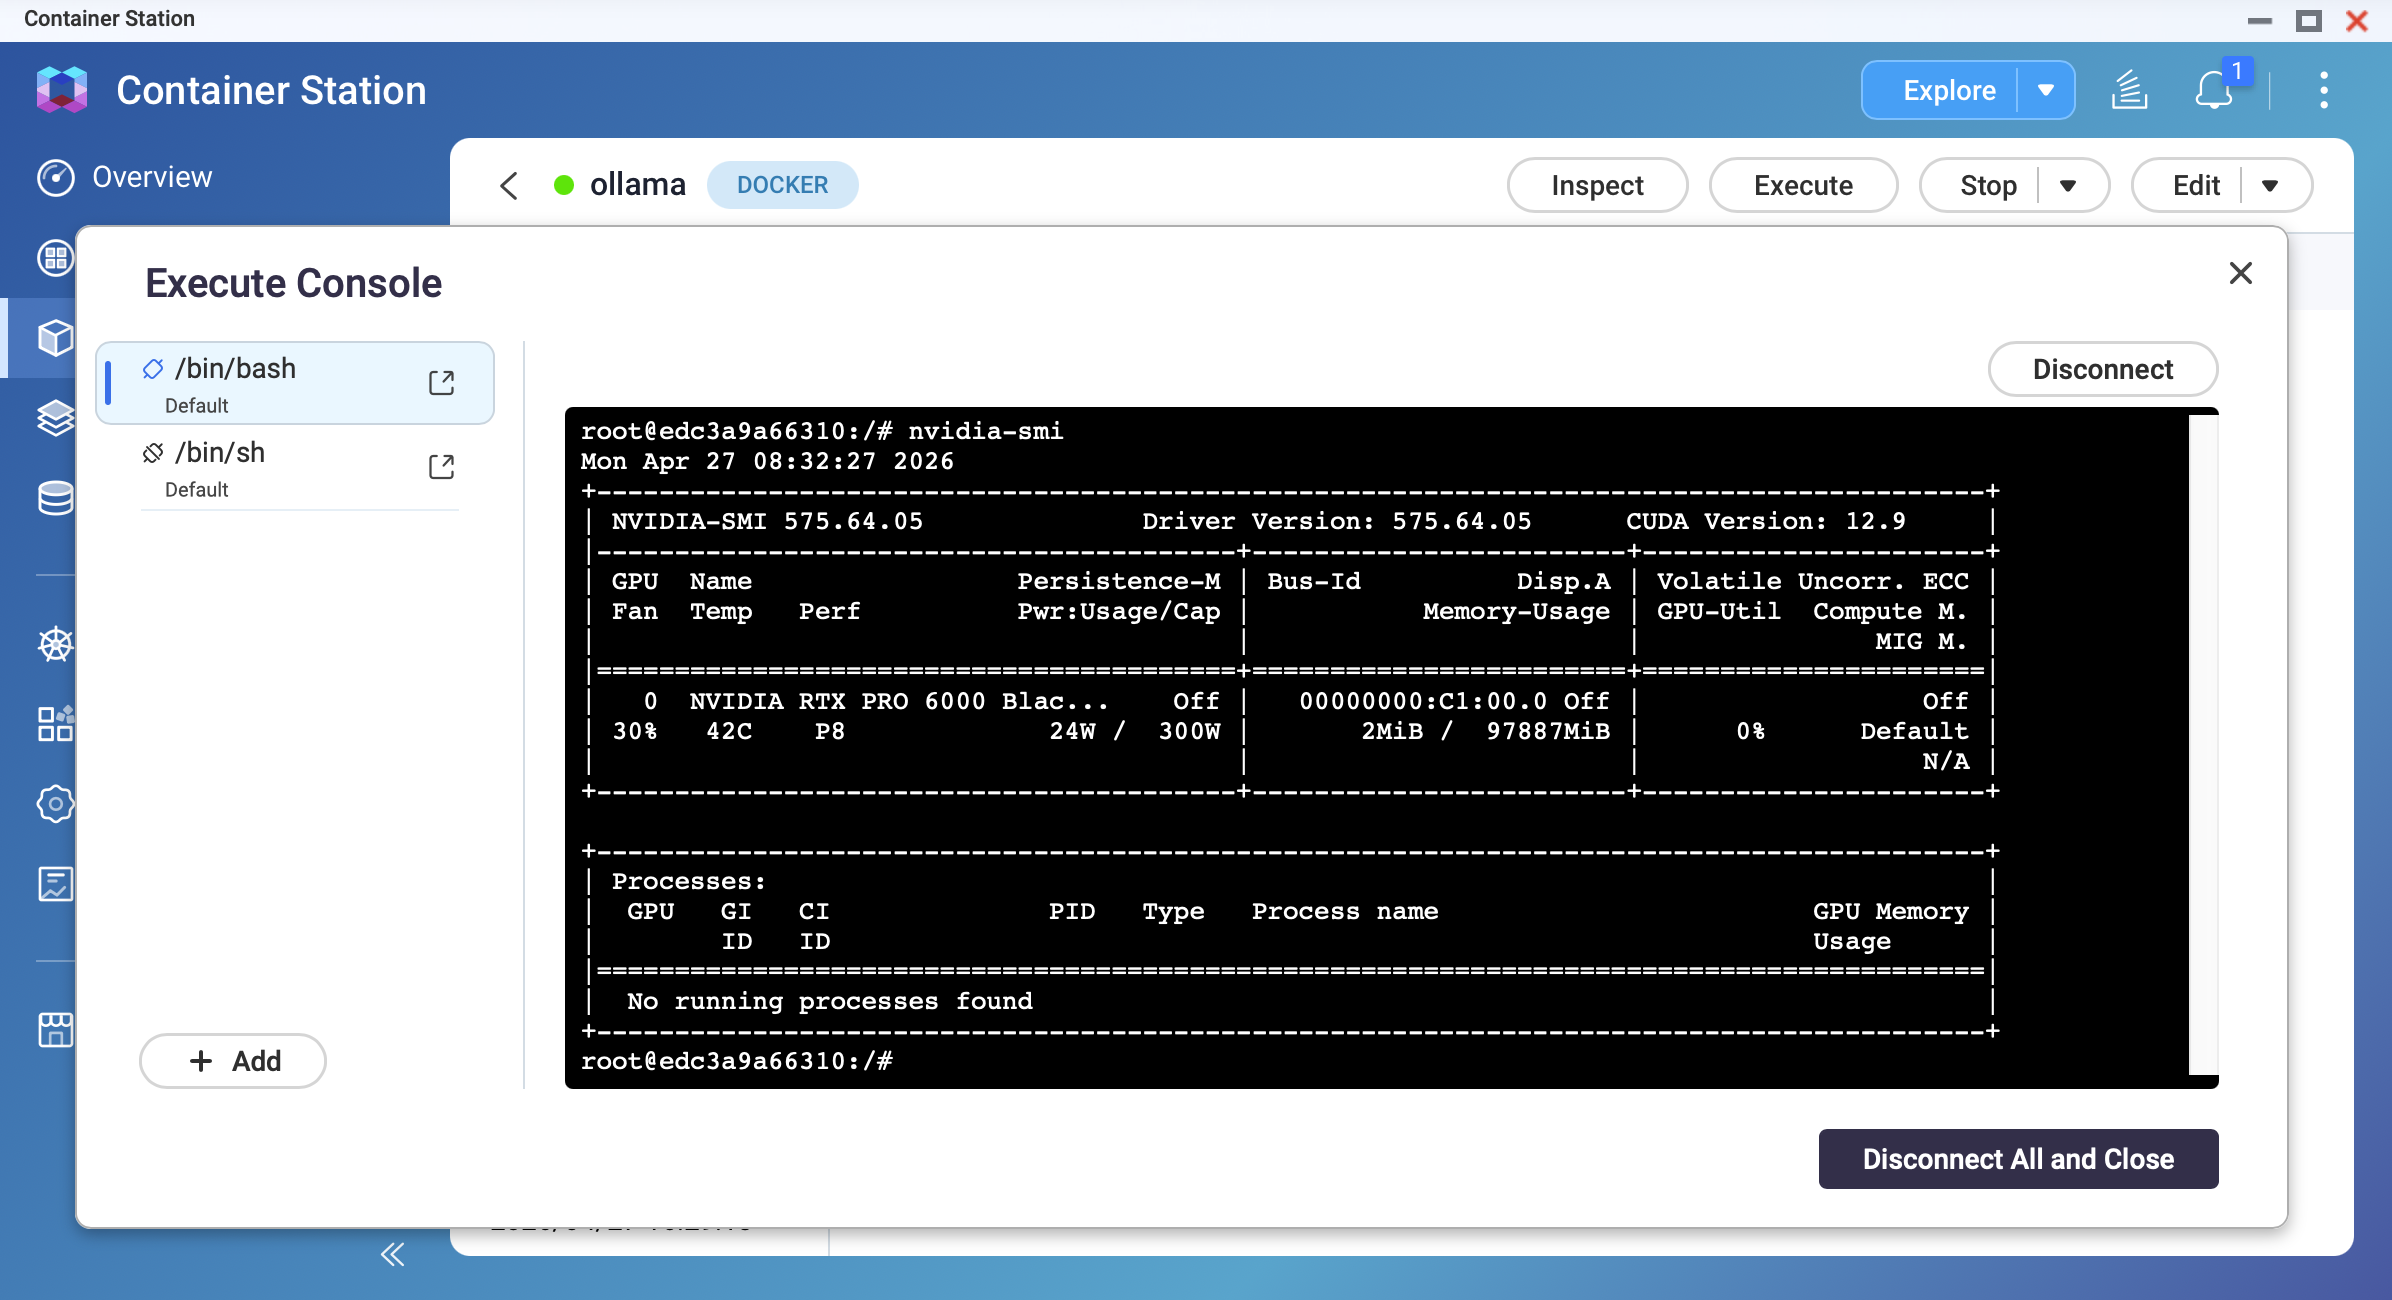
När containern startar, öppna dess terminal och kör:
nvidia-smiDu bör se din GPU-modell, drivrutinsversion och minnesinformation.
Dra en modell och bekräfta GPU-acceleration.
ollama pull qwen3.5:9b ollama run qwen3.5:9bMedan modellen genererar ett svar, öppna en annan terminal och kör
nvidia-smi. Du bör observera att GPU-minnesanvändning och GPU-utnyttjande ökar.
Resultat
När du har slutfört denna handledning kommer du att ha:
- Ollama som körs på din QNAP NAS vid
http://<NAS-IP>:11434 - Modelldata lagras i
/share/Container/ollama(överlever container-ombyggnader) - En fungerande LLM som är tillgänglig via Ollama API
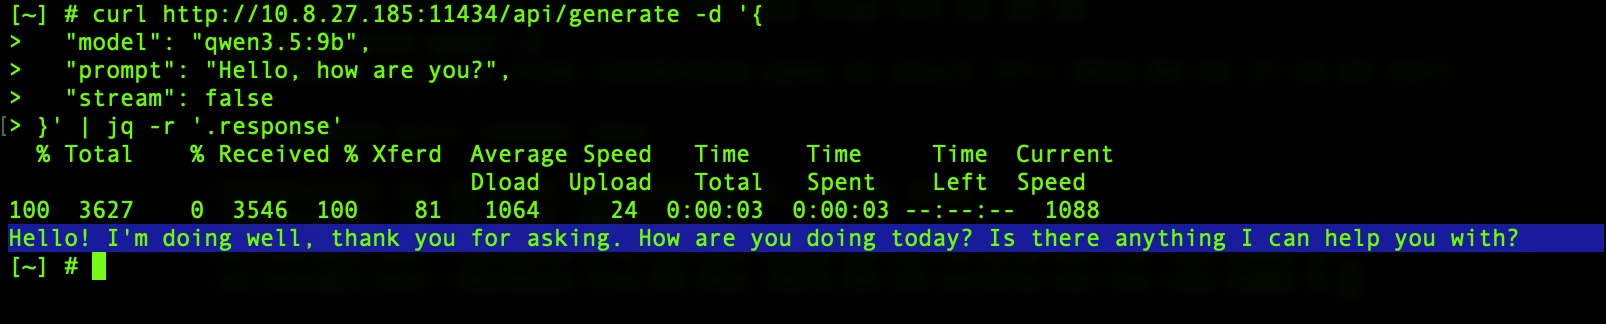
Du kan testa API:et från vilken enhet som helst på ditt lokala nätverk:
curl http://<NAS-IP>:11434/api/generate -d '{
  "model": "qwen3.5:9b",
  "prompt": "Hello, how are you?",
  "stream": false
}'
OLLAMA_HOST=0.0.0.0-inställningen exponerar Ollama API på alla nätverksgränssnitt. Exponera inte port 11434 till internet. Använd Brandvägg-regler eller QNAP:s nätverksinställningar för att begränsa åtkomst till endast ditt lokala nätverk.Felsökning
Containern avslutas omedelbart efter start
Detta kan orsakas av otillräckligt RAM eller felaktig GPU-drivrutin. Kontrollera containerloggar i Container Station. Minska minnesbegränsningar eller inaktivera GPU-läge.
Modellhämtning misslyckas halvvägs
Detta kan bero på otillräckligt diskutrymme eller nätverkstidsgräns. Försök att frigöra Lagring-utrymme. Kör om ollama pull; systemet återupptar där det slutade.
Svarshastigheten är mycket långsam (1–3 tokens per sekund)
Modellen kan köras på CPU istället för GPU, eller modellen är för stor för ditt RAM. Verifiera din GPU-åtkomst med nvidia-smi inne i containern. Försök att använda en mindre modell.
NAS-enheten blir okänslig under inferens
Detta kan vara ett "out of memory"-problem: modellen förbrukar all systemminne. Vi rekommenderar att du startar om NAS-enheten. Ställ in en minnesanvändningsgräns i applikationen. Eller använd en mindre modell.
"Cannot connect to Ollama"-meddelande från Open WebUI
Detta kan orsakas av en felaktig API-URL eller Docker-nätverksisolering. Du kan använda http://ollama:11434 om du är på samma Docker-nätverk.
För ytterligare hjälp kan du fråga andra användare och QNAP-experter i vår community. Gå till QNAP Community


